
NVMe за Tri-Mode-контроллером в vSAN 9.x: откуда берутся задержки и ошибки контрольных сумм
Звонок обычно звучит так: «Нам поставили кластер vSAN на NVMe, диски дорогие, а работает хуже старого сервера с SAS-массивом». Дальше по списку — латентность скачет, в логах ошибки контрольных сумм, время от времени storage pool на одном из узлов уходит в недоступное состояние и часть машин перезапускается. Очень часто виновата не прошивка и не сеть, а путь подключения дисков: NVMe пришли в процессор не напрямую по PCIe, а через Tri-Mode RAID-контроллер. Ниже — что об этом говорят Broadcom KB и vSAN Design Guide, как проверить свой кластер за 15 минут, что делать, если железо уже оплачено, и честный разговор о том, нужен ли vSAN организации на 40–50 рабочих мест вообще.
Совместимость проверили по двум пунктам из трёх
Когда компания заказывает узлы под vSAN, проверка совместимости обычно выглядит так: открыли список сертифицированного оборудования, нашли модель сервера — есть. Нашли модель NVMe-накопителя — есть. Всё, галочка поставлена, счёт согласован. А третий пункт — «как именно диск физически доходит до процессора» — не смотрит никто. Ни интегратор, потому что он продаёт готовую конфигурацию из своего конфигуратора. Ни системный администратор, потому что в спецификации написано «8 × NVMe U.3 3.84 ТБ», и слово NVMe там честное.
Проблема в том, что U.3-слот в корзине — универсальный разъём. Через него диск может уйти двумя разными маршрутами: прямо в PCIe-линии процессора или через RAID-контроллер, который умеет SAS, SATA и NVMe одновременно. Такие контроллеры называют Tri-Mode: у Broadcom это MegaRAID 94xx/95xx/96xx (например, 9460-16i, 9560-16i), у вендоров — под своими именами: Dell PERC 11 (H755N, H755) и PERC 12 (H965i), HPE MR416i, Lenovo ThinkSystem RAID 940-й серии. В спецификации это выглядит как плюс: «и NVMe умеет». Для vSAN это минус, причём дисквалифицирующий.
Broadcom формулирует однозначно: vSAN поддерживает за Tri-Mode-контроллером только SAS и SATA. NVMe за таким контроллером — неподдерживаемая конфигурация. Не «не рекомендуется», а прямо вне поддержки, и в KB314305 это распространено на vSAN 7.x, 8.x и 9.x. Режим контроллера роли не играет: перевод в JBOD, passthrough или «HBA-режим» не превращает NVMe в прямое PCIe-устройство — ввод-вывод всё равно идёт через прошивку контроллера и драйвер lsi_mr3. В классической OSA Tri-Mode-контроллер может быть сертифицирован для SAS/SATA-дисков, а в ESA контроллеров в тракте данных нет вообще — об этом ниже.
- Сервер есть в каталоге совместимости — это ещё не значит, что сертифицирована конкретная корзина и схема подключения;
- NVMe-накопитель есть в списке ESA — это не отменяет требования подключить его напрямую к PCIe;
- JBOD/passthrough на Tri-Mode-контроллере не делает NVMe-конфигурацию поддерживаемой;
- Tri-Mode-контроллер в шасси допустим только под SAS/SATA (OSA) или загрузочные диски, не под NVMe vSAN.
Что именно написано в документации, а не в пересказах
Основной документ — статья базы знаний Broadcom KB314305 «vSAN support of NVMe devices behind tri-mode controllers». Ключевая фраза оттуда: «VMware vSAN will only support SAS and SATA devices attached to a Tri-mode controller. NVMe devices attached to Tri-mode controller are NOT a vSAN supported configuration». И там же: NVMe поддерживаются только при прямом подключении к PCIe-шине. Решение KB предлагает одно — связаться с производителем сервера и переделать железо: заменить backplane или убрать контроллер из тракта. Там же перечислены симптомы неподдерживаемой схемы, и они настолько узнаваемые, что по ним можно ставить предварительный диагноз.
Второй документ — vSAN Design Guide, в актуальной редакции он называется «Design recommendations for vSAN in VMware Cloud Foundation 9.1» и выпущен в мае 2026 года. В разделе Choosing a Storage I/O Controller написано буквально: vSAN не поддерживает размещение NVMe-дисков за RAID- или Tri-Mode-контроллерами, и, помимо того что это вне поддержки, такая схема демонстрирует проблемы с производительностью — особенно в конфигурациях, где NVMe ограничен одной линией PCI-Express. Вот эта оговорка про одну линию — самая практически важная часть всего вопроса, и к ней я вернусь отдельно.
И третье, что стоит держать в голове про ESA. В разделе про Broadcom Compatibility Guide прямым текстом сказано: для vSAN ESA storage-контроллеры вообще больше не нужно подбирать, потому что ESA не поддерживается за RAID-контроллерами, Tri-Mode-контроллерами и HBA. Никакими. То есть в ESA контроллера в тракте данных нет по определению — там же отдельно отмечено, что глубина очереди контроллера перестала быть предметом обсуждения именно потому, что контроллер не находится в пути ввода-вывода. Если вы поставили Tri-Mode в ESA-узел и повесили на него диски — вы не просто нарушили рекомендацию, вы построили архитектуру, которой в проекте vSAN не существует.
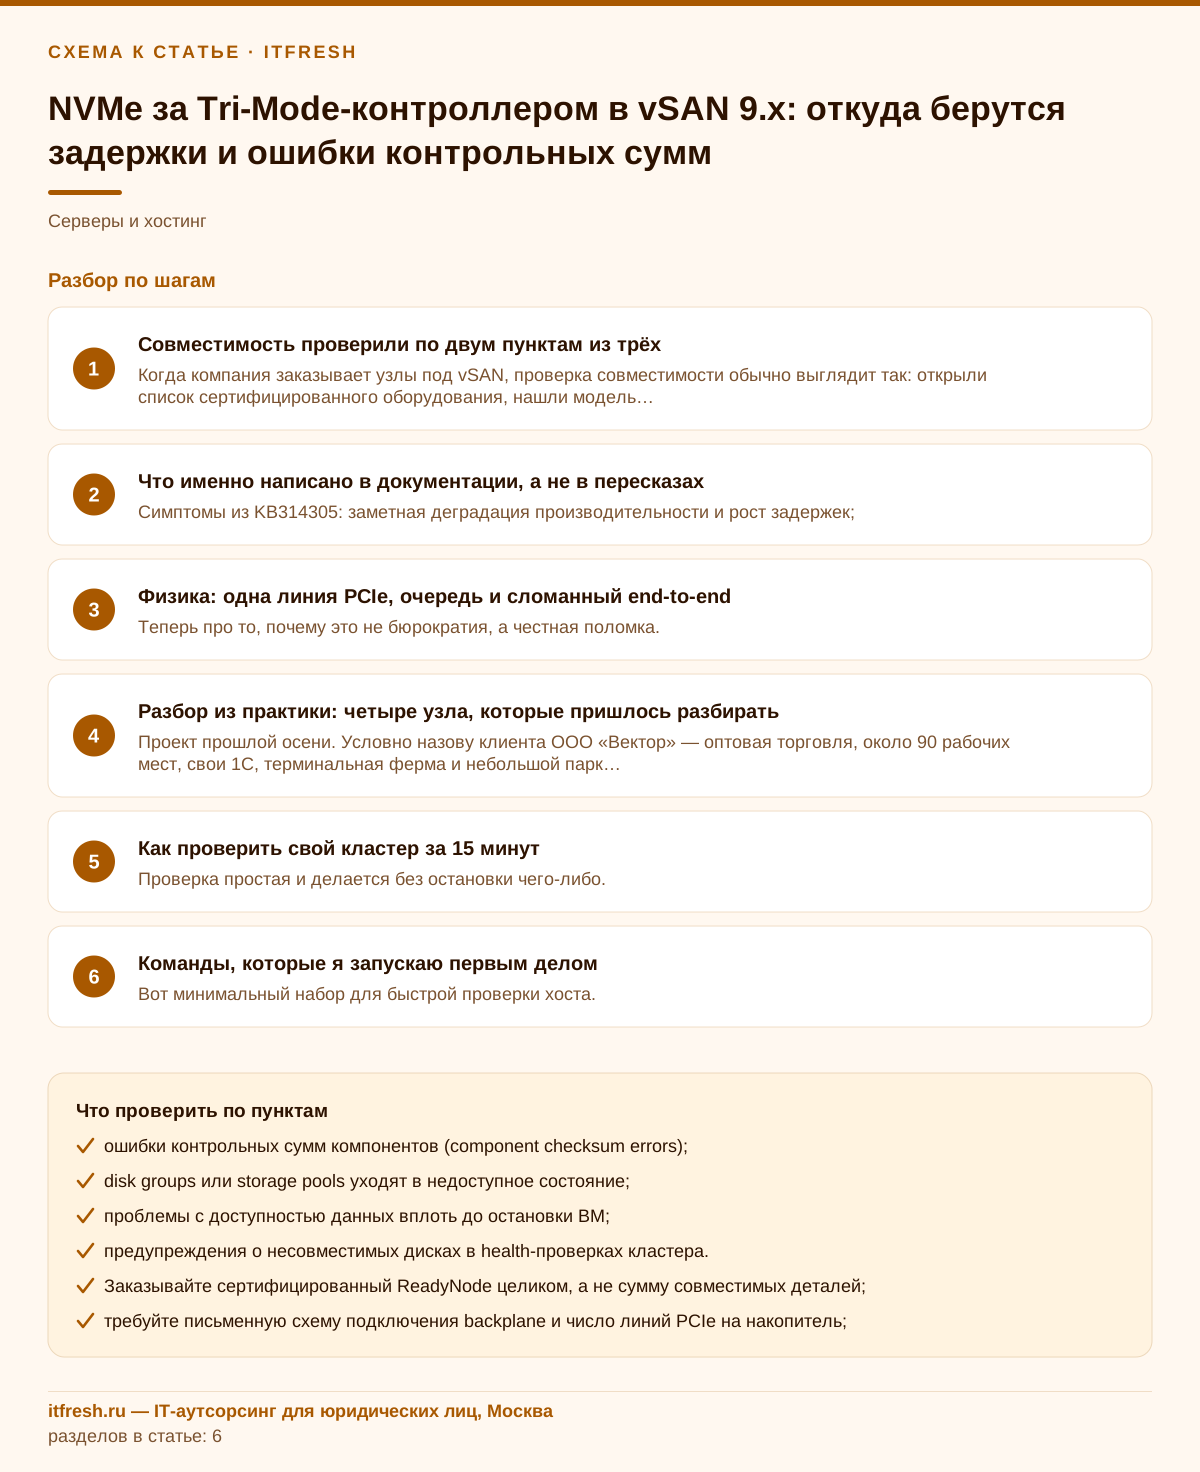
- Симптомы из KB314305: заметная деградация производительности и рост задержек;
- ошибки контрольных сумм компонентов (component checksum errors);
- disk groups или storage pools уходят в недоступное состояние;
- проблемы с доступностью данных вплоть до остановки ВМ;
- предупреждения о несовместимых дисках в health-проверках кластера.
Физика: одна линия PCIe, очередь и сломанный end-to-end
Теперь про то, почему это не бюрократия. Первое и главное — линии. Design Guide отдельно предупреждает: backplane, применяемые с Tri-Mode-контроллерами, часто ограничивают NVMe-диски одной линией PCI-Express, и это делает неподдерживаемую конфигурацию источником экстремальных проблем с производительностью. Диск, рассчитанный на x4, получает x1: на PCIe Gen4 это около 2 ГБ/с на накопитель вместо примерно восьми, и это в идеальном мире. Сверху — общий аплинк самого контроллера, в который упираются все диски узла. Прироста от NVMe вы не получаете — получаете дорогой SAS.
Второе — очередь. Прямо подключённый NVMe работает через драйвер nvme_pcie с несколькими аппаратными очередями, и в выводе esxcli storage core device list у такого устройства большое значение Device Max Queue Depth. Тот же диск за контроллером предъявляется ESXi как логическое SCSI-устройство драйвера lsi_mr3, и глубина очереди у него заметно меньше — по моим замерам на разных контроллерах разница была на порядок и больше; точное число зависит от модели и прошивки, сравнивайте на своём железе. Дальше арифметика простая: под нагрузкой очередь забивается, время отклика растёт нелинейно, появляются таймауты команд.
Третье — контрольные суммы. vSAN сам считает и проверяет контрольную сумму данных, рассчитывая на предсказуемый тракт до накопителя. Между ним и диском встаёт контроллер со своей прошивкой, своей обработкой ошибок и ретраями. Broadcom в KB не расписывает механизм, но прямо относит component checksum errors к симптомам этой схемы, и на практике картина одинаковая: в интерфейсе ошибки контрольных сумм, все думают на диски, а диски здоровые — SMART чистый, износ пара процентов, вендорская диагностика молчит. Моя рабочая гипотеза — ошибка рождается в тракте на переполненной очереди, abort'ах и повторных отправках, а не в NAND.
И финальная стадия — отстрел. Когда команда не укладывается в таймаут, ESXi помечает устройство как проблемное, vSAN выводит его из storage pool, запускается ребилд — на тех же перегруженных линиях, через тот же контроллер. Ребилд добивает очередь, отстреливается следующий диск. В OSA, где диски объединены в disk group вокруг кэш-устройства, потеря одного элемента могла увести в offline всю группу. В ESA такой связки нет, отказ одного накопителя не тянет за собой остальные, но каскад по перегрузке никто не отменял.
- x1 вместо x4 на накопитель — потолок пропускной способности в разы ниже паспортного;
- одна логическая очередь контроллера вместо многоочередного nvme_pcie — нелинейный рост задержек под нагрузкой;
- таймауты и abort'ы команд в vmkernel.log — предвестник вывода устройства из пула;
- ребилд идёт через тот же перегруженный тракт и провоцирует следующий отказ.
Разбор из практики: три узла у благотворительного фонда
Условный клиент — благотворительный фонд «Забота без границ», 43 рабочих места: бухгалтерия на 1С, CRM по донорам и подопечным, терминальный сервер для удалённых сотрудников и координаторов в регионах, файловый сервер с отсканированными документами. Кластер фонду собрал предыдущий подрядчик на деньги грантовой программы: три узла 1U, по одному Xeon на 16 ядер, 256 ГБ памяти, по четыре NVMe U.3 3.84 ТБ, сеть 25GbE двумя портами. VCF 9, vSAN в режиме ESA. Для организации такого размера — очень серьёзное железо, и ожидания были соответствующие. Меня позвали, когда кластер месяц отработал в бою и начал вести себя странно.
Картина при первом заходе: средняя латентность записи 9–14 мс при ожидаемых для NVMe долях миллисекунды, пики до 40 мс, когда бухгалтерия формировала отчётность, а терминальный сервер одновременно открывали два десятка пользователей. За три недели — шесть событий с ошибками контрольных сумм, один ребилд, один раз storage pool на узле ушёл в недоступное состояние, и терминальный сервер перезапустился посреди рабочего дня. Сеть чистая: потерь и ошибок на портах нет, MTU согласован. Прошивки накопителей актуальные. Всё «по документации», а работает плохо.
Диагноз занял минут двадцать. esxcli nvme adapter list вернула пустой список — при четырёх NVMe в каждом узле. esxcli storage core adapter list показала единственный vmhba с драйвером lsi_mr3, и все накопители висели на нём как обычные SCSI-устройства. Утилита контроллера с хоста видела все четыре диска. В спецификации поставки стояли Tri-Mode-контроллер и «универсальный backplane», а консоль управления сервером показывала ширину линка x1 на каждый слот.
Что сделали. У вендора заказали вариант корзины с прямым подключением NVMe и кабели к материнской плате, загрузку перенесли на штатный модуль M.2 с зеркалом, контроллер из тракта vSAN убрали. На трёх узлах с RAID-5 полная эвакуация данных невозможна — некуда, поэтому перед каждым узлом делали свежую резервную копию всех ВМ на отдельное хранилище, самые важные машины (1С и CRM) временно запускали на резервном сервере с локальными дисками. Узел — в maintenance mode с Ensure accessibility, вывод дисков из storage pool, переделка, проверка, что накопители видны через nvme_pcie с линком x4, создание пула заново и ожидание полной ресинхронизации. По одному узлу за выходные. Итог: латентность записи 0,4–0,8 мс, в пики не выше 2–3 мс, ошибок контрольных сумм ноль. Стоимость переделки — комплект корзин, кабелей и модулей загрузки плюс три выходных, около 10 % от стоимости кластера.
- Симптомы: латентность 9–14 мс, checksum errors, пул в недоступном состоянии;
- диагностика: пустой `esxcli nvme adapter list`, все диски на vmhba с lsi_mr3, линк x1;
- исправление: прямой NVMe-backplane, загрузка на M.2, пересоздание storage pool по узлу;
- страховка на время работ: свежие бэкапы и временный перенос 1С и CRM на отдельный сервер.
Как проверить свой кластер за 15 минут
Проверка простая и делается без остановки чего-либо. Зайдите по SSH на любой хост кластера и посмотрите, какими адаптерами видны накопители. Если NVMe подключены правильно, каждый живёт на своём vmhba с драйвером nvme_pcie, и esxcli nvme adapter list их показывает. Если список пуст, а все диски висят на одном vmhba с драйвером RAID-контроллера (lsi_mr3 у MegaRAID и PERC, smartpqi у контроллеров на Microchip) — вы нашли проблему.
Дальше стоит убедиться в ширине линка и в том, что за контроллером действительно ничего лишнего. Здесь удобнее вендорские утилиты: storcli/perccli с хоста или консоль управления iDRAC/iLO/XCC. Правило простое и не требует толкований: контроллер не должен видеть ни одного NVMe-накопителя, который вы отдаёте под vSAN. Если видит — маршрут неправильный, независимо от того, что написано в счёте.
И третий шаг — health-проверки самого кластера. Они не назовут проблему своим именем, но покажут связанные признаки: неактуальную базу совместимости, непройденные проверки устройств, накопленные ошибки. Смотреть их надо не разово, а держать зелёными постоянно — в Design Guide прямым текстом стоит рекомендация не заводить нагрузку на vSAN-датастор, пока health-сервис не показывает зелёный статус по всем пунктам.
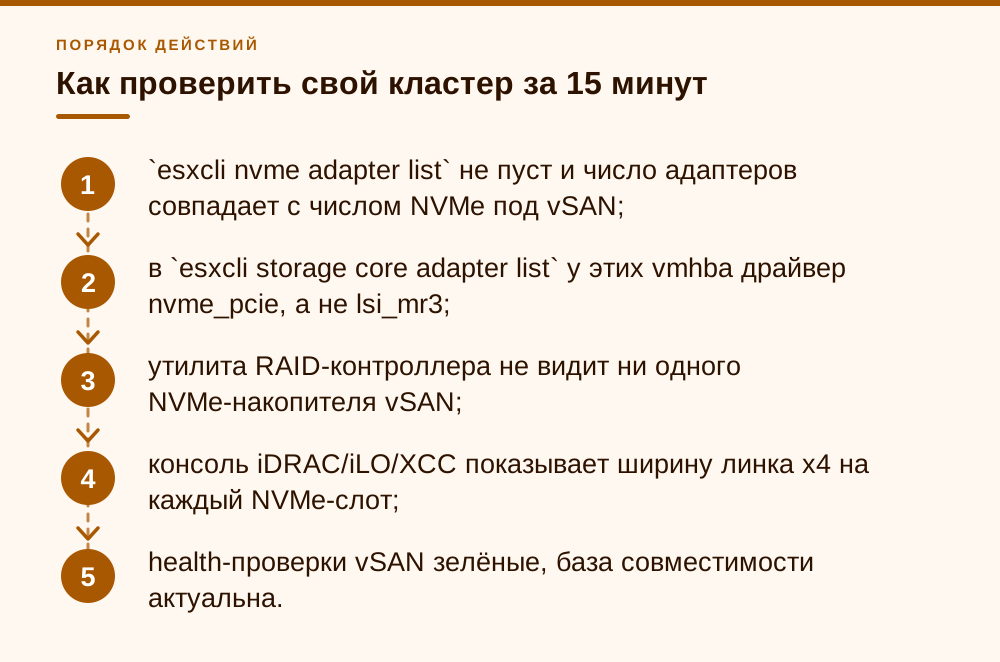
- `esxcli nvme adapter list` не пуст и число адаптеров совпадает с числом NVMe под vSAN;
- в `esxcli storage core adapter list` у этих vmhba драйвер nvme_pcie, а не lsi_mr3;
- утилита RAID-контроллера не видит ни одного NVMe-накопителя vSAN;
- консоль iDRAC/iLO/XCC показывает ширину линка x4 на каждый NVMe-слот;
- health-проверки vSAN зелёные, база совместимости актуальна.
Команды, которые я запускаю первым делом
Вот минимальный набор для быстрой проверки хоста. Ничего разрушительного здесь нет, всё только читает состояние, выполняется на живом хосте без вывода в maintenance mode.
# 1. Есть ли вообще NVMe-адаптеры (правильное подключение)
esxcli nvme adapter list
esxcli nvme device list

# 2. Какими адаптерами и драйверами видны накопители
esxcli storage core adapter list
esxcli storage core device list | grep -E 'Display Name|Is Local|Queue'

# 3. Что видит PCI-подсистема
lspci -v | grep -i -E 'nvme|raid|megaraid|mr3'

# 4. Видит ли RAID-контроллер ваши NVMe (в норме — не должен)
# путь зависит от версии VIB: storcli / storcli64 / perccli (Dell)
ls /opt/lsi/
/opt/lsi/storcli64/storcli64 /c0 show

# 5. Health-проверки кластера с хоста
esxcli vsan health cluster list

# 6. Ошибки в тракте: checksum, aborts, таймауты
grep -i -E 'checksum|abort|timeout' /var/log/vmkernel.log | tail -50
Отдельно про интерпретацию вывода. Пустой список NVMe-адаптеров при физически установленных NVMe — приговор, дальше можно не смотреть. Если адаптеры есть, но их меньше, чем накопителей, — вероятна смешанная схема, часть дисков в PCIe, часть за контроллером. Если адаптеры на месте и по числу совпадают, а латентность всё равно высокая — тогда причина в другом, и надо идти в сеть и профили нагрузки. Тоже полезный результат: вы точно исключили самую дорогую в исправлении гипотезу.
- Пустой список NVMe-адаптеров при установленных NVMe — диски за контроллером;
- адаптеров меньше, чем накопителей, — смешанная схема, ищите узлы и слоты за контроллером;
- адаптеры совпадают, линк x4, а задержки высокие — идите в сеть, политики хранения и профиль нагрузки;
- строки abort/timeout в vmkernel.log рядом по времени с checksum errors — косвенное подтверждение проблемы тракта.
Как заказывать железо, чтобы не попасть второй раз
Правило первое и главное: берите ReadyNode-конфигурацию целиком, а не собирайте узел из совместимых по отдельности компонентов. Смысл программы ReadyNode ровно в том, что сертифицирована связка — плата, корзина, кабели, накопители, сетевые карты. Проверка «сервер в списке, диск в списке» этой связки не гарантирует. Broadcom Compatibility Guide для ESA вообще устроен так, что раздел storage-контроллеров вам просто не нужен: подбираются только накопители из списка ESA-совместимых.
Правило второе: PCIe switch — не то же самое, что RAID-контроллер, но и не свободная опция. В плотных конфигурациях, где линий процессора физически не хватает на все слоты, PCIe-коммутатор допустим, однако политика поддержки для него такая же, как для SAS-экспандеров: он поддерживается только на тех серверных платформах, у которых есть сертифицированный ReadyNode с этим коммутатором в составе. Проверять это надо по каталогу совместимости, а не по словам менеджера. Правда, в Design Guide тут же отмечено, что на современных процессорных архитектурах такие коммутаторы обычно уже не требуются — линий хватает.
Правило третье: формулируйте требование в договоре явно. Строчка «8 × NVMe U.3» не значит ничего. Требуйте формулировку вида «накопители NVMe подключены напрямую к PCIe материнской платы, без прохождения через RAID- или Tri-Mode-контроллер; каждый накопитель получает не менее четырёх линий PCIe; конфигурация соответствует сертифицированному vSAN ESA ReadyNode». Три строки в спецификации, которые снимают весь класс проблем. И просите у поставщика схему подключения корзины — нормальный вендор её даёт без разговоров.
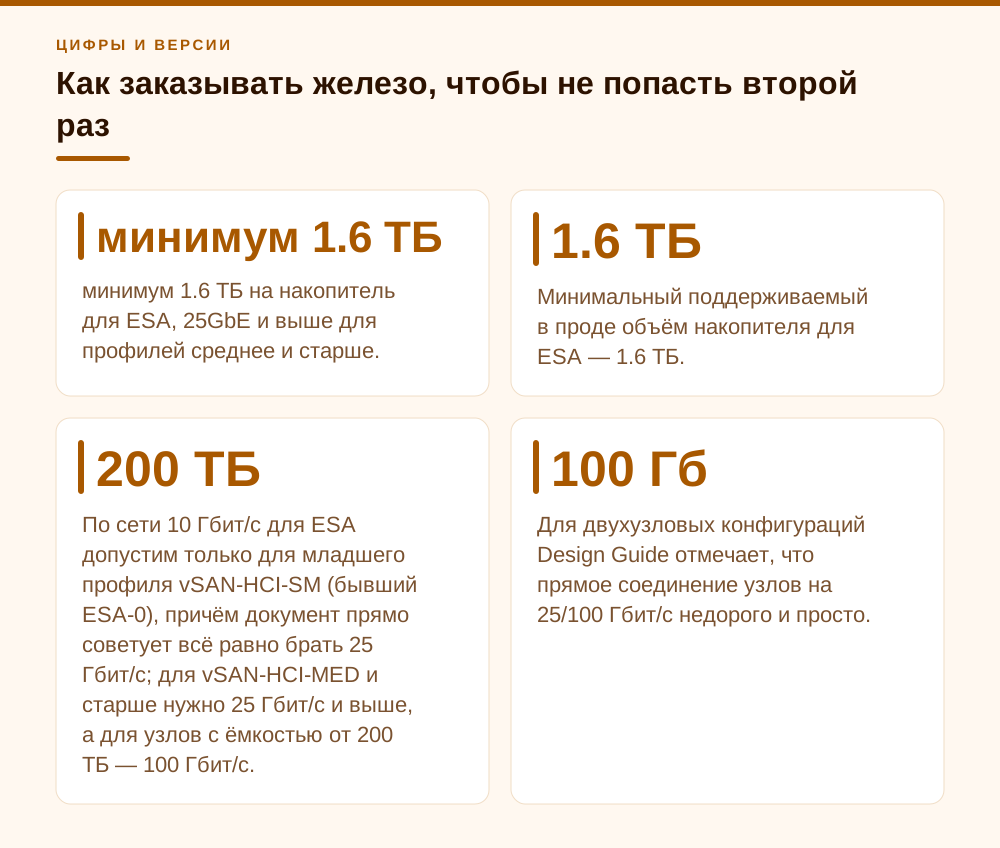
И заодно пара смежных вещей из того же Design Guide, на которых спотыкаются чаще всего. Минимальный поддерживаемый в проде объём накопителя для ESA — 1.6 ТБ. По сети 10 Гбит/с для ESA допустим только для младшего профиля vSAN-HCI-SM (бывший ESA-0), причём документ прямо советует всё равно брать 25 Гбит/с; для vSAN-HCI-MED и старше нужно 25 Гбит/с и выше, а для узлов с ёмкостью от 200 ТБ — 100 Гбит/с. Для двухузловых конфигураций Design Guide отмечает, что прямое соединение узлов на 25/100 Гбит/с недорого и просто. Read-intensive TLC-накопители в ESA поддерживаются на всех профилях, а QLC появился в 9.1 только в классе CyberRecovery ReadyNode под долгое хранение, не как дешёвая замена основной ёмкости.
- Заказывайте сертифицированный ReadyNode целиком, а не сумму совместимых деталей;
- требуйте письменную схему подключения backplane и число линий PCIe на накопитель;
- Tri-Mode-контроллер в шасси допустим — но только под SAS/SATA и загрузочные диски;
- PCIe switch — только если платформа сертифицирована с ним в составе ReadyNode;
- минимум 1.6 ТБ на накопитель для ESA, 25GbE и выше для профилей среднее и старше.
Нужен ли vSAN организации на 40–50 рабочих мест
Честно: чаще всего нет. У фонда на 43 места типичный набор — 8–15 виртуальных машин: 1С, терминальный сервер, файлы, CRM, контроллер домена, резервное копирование. Для такой нагрузки vSAN даёт отказоустойчивость хранилища, но требует минимум двух узлов плюс witness-appliance где-то ещё или трёх полноценных узлов, сети 25 Гбит/с, сертифицированного ReadyNode и подписки VCF или VVF, которая считается по ядрам. Для российской организации отдельный вопрос — сможете ли вы вообще легально купить подписку и получить поддержку. Если ответ неочевиден, решайте его до закупки железа, а не после.
Если vSAN всё-таки нужен, для 40–50 мест я бы смотрел на двухузловой кластер ESA: два узла с прямым подключением NVMe, соединённые напрямую портами 25 Гбит/с, и witness-appliance на отдельном небольшом сервере или в другой площадке. Design Guide прямо называет прямое соединение узлов для двухузловых конфигураций экономичным. Три узла имеют смысл, когда нужно пережить отказ узла и продолжать работать с полной защитой данных — для фонда это обычно избыточно. В обоих случаях сервер выбирается так: платформа из ESA ReadyNode, вариант корзины с прямым NVMe, загрузка на отдельном модуле M.2 (у Dell — BOSS, у HPE — NS204i), без RAID-контроллера в тракте.
Альтернатива, которую я предлагаю малым организациям чаще: два сервера с локальными NVMe на аппаратном RAID или ZFS, репликация виртуальных машин между ними средствами системы резервного копирования и отдельное хранилище бэкапов. Переключение не мгновенное — минуты вместо секунд, — зато нет требований к сертифицированной схеме подключения, подписке на программно-определяемое хранилище и сети 25 Гбит/с. Вот здесь Tri-Mode-контроллер с NVMe как раз уместен: локальный RAID — его родная задача.
- vSAN оправдан, если простой 1С или терминального сервера на час стоит дороже подписки и третьего узла;
- двухузловой ESA: два ReadyNode, прямое 25GbE между узлами, witness на отдельной машине;
- три узла — если нужна полная защита данных даже при выведенном узле;
- два сервера + репликация ВМ + отдельные бэкапы — дешевле и проще для 40–50 мест;
- вопрос лицензирования и поддержки для российской организации решить до закупки.
Что делать, если железо уже стоит в стойке
Сначала успокою: паниковать и выключать продуктив не надо. Кластер в такой конфигурации, как правило, работает — плохо, нестабильно, с периодическими сюрпризами, но работает. У вас есть время спланировать переделку нормально, а не в ночь на субботу. Что действительно нужно сделать немедленно — это перестать наращивать на нём нагрузку и снять с этого кластера всё, что не переживёт часовой недоступности. И завести резервные копии в отдельное хранилище, если их там ещё нет.
Дальше три варианта по стоимости. Самый дешёвый и правильный — перекоммутация: прямой NVMe-backplane и кабели-ретаймеры от вендора, контроллер остаётся под загрузку. Обычно это единицы процентов от стоимости кластера и выходные на узел. Средний вариант — если корзина в принципе не переключается на прямой PCIe: часть накопителей переносится в слоты AIC или на E3/U.2-салазки с прямым подключением, ёмкость при этом теряется. Худший — платформа физически не умеет прямой NVMe, и тогда это замена шасси, что имеет смысл обсуждать с поставщиком как поставку конфигурации, не соответствующей заявленному назначению.
Порядок работ при переделке одинаковый для любого варианта. Узел в maintenance mode с политикой Ensure accessibility, дождаться эвакуации данных, выключить, переделать, включить, убедиться, что накопители видны как NVMe-устройства, вернуть в кластер и обязательно дождаться завершения ресинхронизации перед тем, как трогать следующий узел. Не пытайтесь ускориться и делать два узла разом даже на кластере из шести — вы съедаете запас отказоустойчивости ровно тогда, когда идёт максимальная нагрузка на диски.
И честно про спорное. Есть мнение, что «на маленькой нагрузке и так сойдёт» — и в каком-то смысле оно не беспочвенно: кластер на десяток нетребовательных виртуалок может годами не показывать ничего страшного. Но я бы на это не закладывался по двум причинам. Первая — нагрузка растёт всегда, а деградация здесь нелинейная: до какого-то порога тихо, после порога сразу больно. Вторая — конфигурация вне поддержки, и в момент реального инцидента разбор упрётся в этот факт. За что тогда контракт на поддержку.
- Сразу: свежие резервные копии всех ВМ на отдельное хранилище, вне vSAN;
- не наращивать нагрузку до переделки и снять с кластера то, что не переживёт простоя;
- запросить у поставщика вариант прямого NVMe-backplane для вашей платформы;
- планировать по одному узлу, с полной ресинхронизацией между узлами;
- после переделки — поузловая проверка nvme_pcie, ширины линка и health-сервиса.
Частые вопросы
Tri-Mode-контроллер вообще нельзя ставить в узел vSAN?
Можно, но не под NVMe. За Tri-Mode-контроллером vSAN поддерживает SAS- и SATA-устройства — в архитектуре OSA это штатный сценарий, если контроллер есть в каталоге совместимости. Загрузочные диски за контроллером тоже вопросов не вызывают. Запрещено ровно одно: пропускать ввод-вывод NVMe-накопителей vSAN через этот контроллер. В архитектуре ESA контроллера в тракте данных не должно быть вообще — ни RAID, ни Tri-Mode, ни HBA.
Если перевести Tri-Mode-контроллер в JBOD или passthrough, NVMe станет поддерживаемым?
Нет. В режиме JBOD/passthrough контроллер отдаёт диск хосту без RAID-массива, но ввод-вывод всё равно проходит через его прошивку и драйвер lsi_mr3, а сам накопитель виден как SCSI-устройство. KB314305 не делает исключений по режимам: NVMe поддерживаются только при прямом подключении к PCIe. Проверка простая — если диск не отображается в esxcli nvme adapter list и виден утилитой контроллера, конфигурация неподдерживаемая.
У нас всё работает без ошибок. Это точно надо переделывать?
Если кластер загружен слабо, симптомы действительно могут не проявляться месяцами. Но деградация здесь нелинейная: пока очередь контроллера не переполняется — тихо, после порога начинаются таймауты, ошибки контрольных сумм и отстрел дисков сразу. Плюс конфигурация формально вне поддержки, и при обращении в поддержку по инциденту разбор упрётся именно в это. Я рекомендую планировать переделку заранее, а не в аварийном режиме.
Ошибки контрольных сумм — это же признак умирающих дисков?
Не обязательно. В такой схеме накопители обычно совершенно здоровы: износ единицы процентов, вендорская диагностика чистая, SMART без замечаний. Ошибка рождается в тракте — на переполненной очереди контроллера, повторных отправках и частичных записях. Поэтому замена диска по гарантии лечит симптом на неделю, а потом отстреливается следующий. Прежде чем менять накопители, проверьте, как они подключены.
PCIe switch — это то же самое, что RAID-контроллер?
Нет, это разные вещи. PCIe-коммутатор просто размножает линии, не влезая в обработку ввода-вывода, и он допустим — но не безусловно: политика поддержки для него такая же, как для SAS-экспандеров, то есть только на серверных платформах, у которых есть сертифицированный ReadyNode с этим коммутатором в составе. В каталоге совместимости наличие PCIe switch можно указать параметром поиска. При этом на современных процессорных архитектурах линий обычно хватает и без него.
Как проверить, что диск получает четыре линии PCIe, а не одну?
Надёжнее всего — через консоль управления сервером (iDRAC, iLO, XCC) или вендорскую утилиту: там видна ширина линка на слот корзины. На хосте можно ориентироваться на вывод lspci и на то, через какой адаптер и драйвер виден накопитель. Но самый быстрый косвенный признак не требует ничего считать: если утилита управления RAID-контроллером видит ваши NVMe в списке подключённых устройств — они идут через контроллер, и вопрос ширины линка уже вторичен.
Можно ли переделать кластер без простоя сервисов?
Да, если узлов достаточно для сохранения отказоустойчивости при выводе одного. Схема стандартная: узел в maintenance mode с политикой Ensure accessibility, эвакуация данных, переделка железа, возврат, полное ожидание ресинхронизации — и только потом следующий узел. Виртуальные машины при этом не останавливаются. Критично не спешить между узлами: почти все потери данных на таких работах происходят из-за попытки вести два узла параллельно.
Стоит ли фонду или небольшой компании на 40–50 мест строить vSAN?
Чаще всего нет. Для 8–15 виртуальных машин обычно достаточно двух серверов с локальными дисками, репликации ВМ между ними и отдельного хранилища резервных копий. vSAN оправдан, когда час простоя стоит дорого и есть бюджет на сертифицированные узлы, сеть 25 Гбит/с и подписку. Если всё же vSAN — смотрите на двухузловой ESA с witness и прямым подключением NVMe.
Источники
- Broadcom KB314305 — vSAN support of NVMe devices behind tri-mode controllers — распространяется на vSAN 7.x, 8.x и 9.x (OSA и ESA); ключевая формулировка: «VMware vSAN will only support SAS and SATA devices attached to a Tri-mode controller». https://knowledge.broadcom.com/external/article/314305/vsan-support-of-nvme-devices-behind-trim.html
- VMware vSAN Design Guide — Design recommendations for vSAN in VMware Cloud Foundation 9.1, редакция май 2026 г. Разделы «Choosing a Storage I/O Controller», «Tri-mode controllers», «PCIe Switch», «Storage Controller Queue Depth», «Network Connectivity and Bandwidth», «Small Disk Drive Capacity Considerations», «Adhere to the Broadcom Compatibility Guide (BCG)». https://www.vmware.com/docs/vmware-vsan-design-guide
- Broadcom Compatibility Guide (BCG/VCG), раздел vSAN — Каталог сертифицированных vSAN ESA ReadyNode, ESA-совместимых накопителей и платформ с PCIe switch; для ESA раздел storage-контроллеров не применяется (vSAN ESA не поддерживается за RAID, Tri-Mode и HBA). https://compatibilityguide.broadcom.com/