
Поднял совместимость ВМ до version 22 на ESX 9 — почему её больше не вернуть на резервный ESXi 8
Если у вас есть новый хост на ESX 9.0 и старый резервный на ESXi 8.0 U3, то одна безобидная на вид галочка «Обновить совместимость ВМ» способна лишить вас запасного аэродрома. Машина после этого физически не включится на восьмёрке — ни vMotion, ни холодной миграцией, ни через Veeam. Ниже — почему так устроено, как это выглядело у нас на реальном стенде, три рабочих способа отката и правила, по которым я теперь разрешаю трогать виртуальное железо вообще.
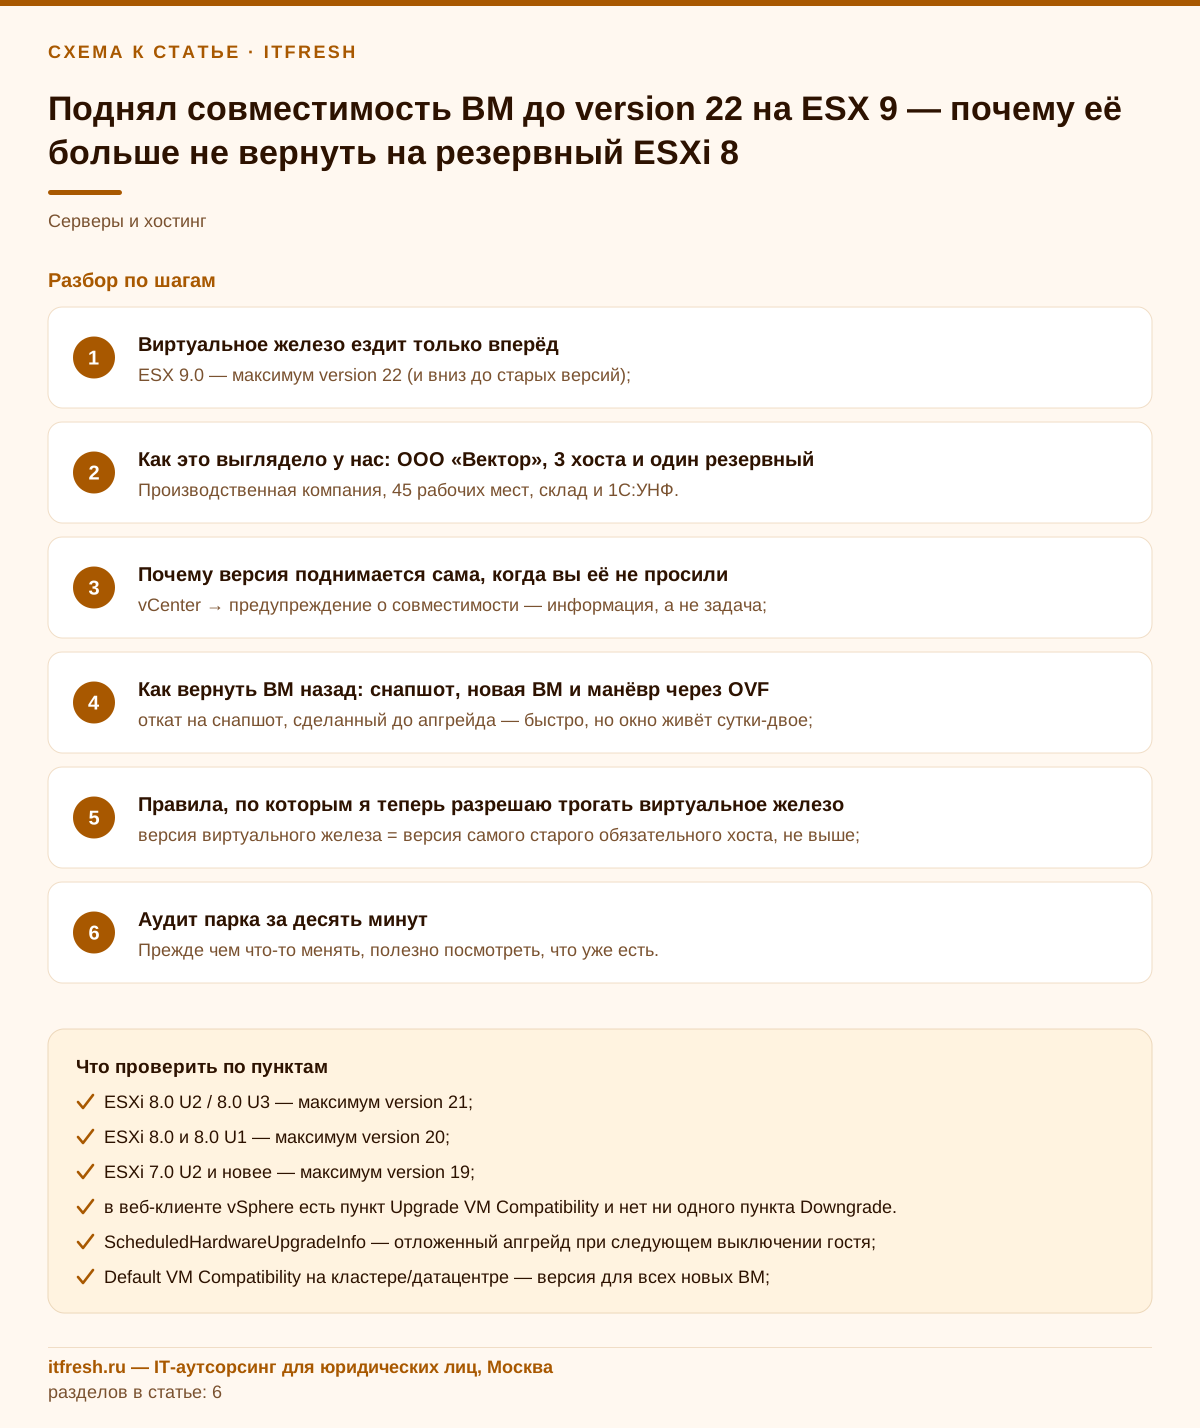
Виртуальное железо ездит только вперёд
Обновление virtual hardware version в голове у большинства админов лежит рядом с обновлением VMware Tools: нажал, перезагрузил, стало новее и лучше. На деле это ближе к смене материнской платы. Вы меняете набор виртуальных устройств и их описание в .vmx, и гипервизор старой версии этот набор просто не умеет собрать. Не «не рекомендуется», не «работает медленнее» — не умеет.
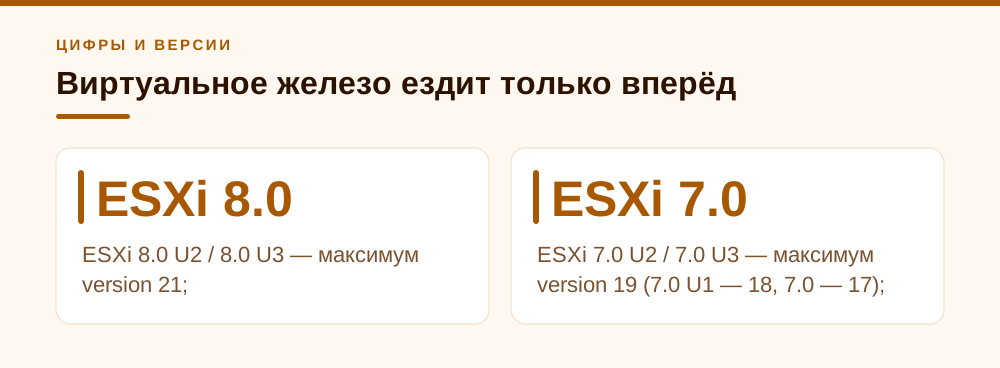
Разложу по цифрам. В таблице соответствия хостов и версий виртуального оборудования (Broadcom KB 315655 «Virtual machine hardware versions», детальная матрица — в KB 312100) у ESX 9.0 максимальная версия — 22, у ESXi 8.0 U2 — 21, у ESXi 8.0 — 20. В той же статье прямым текстом: продукт VMware не может включить ВМ, у которой версия виртуального железа выше, чем он поддерживает. В руководстве vSphere 9.0 по администрированию ВМ на techdocs.broadcom.com перечислено поимённо: машина с совместимостью ESX 9.0 and later (hardware version 22) не запускается на ESX 6.5, 6.7, 7.0 со всеми апдейтами и на 8.0, 8.0 U1, 8.0 U2, 8.0 U3. Потолок восьмёрки — version 21 (появилась в 8.0 U2, в 8.0 U3 новой версии не добавилось), а у голой 8.0 и 8.0 U1 потолок ещё ниже, version 20. Никакими патчами это не двигается: чтобы хост научился версии 22, его нужно обновить до девятки, других вариантов у Broadcom нет.
В руководстве Performance Best Practices for VMware vSphere 9.0 это сказано прямым текстом: машины на hardware version 22 не могут работать на предыдущих версиях ESXi, и потому средствами vMotion такие ВМ переносятся только на хосты ESX 9.0 и новее. Там же отдельно отмечено, что это ограничивает выбор целевых хостов для DRS и DPM — то есть в смешанном кластере планировщик просто теряет половину площадок для балансировки.
А вот в обратную сторону всё честно и мягко: ESX 9.0 обратно совместим с более ранними версиями виртуального оборудования, и такие ВМ спокойно уезжают по vMotion на старые хосты, которые их версию поддерживают. Это ключевой момент, который снимает половину паники. Проблема не в новом гипервизоре — новый хост запустит вам хоть version 13. Проблема ровно в одной ВМ, которой подняли планку выше, чем есть у резерва.
- ESX 9.0 — максимум version 22 (и вниз до старых версий);
- ESXi 8.0 U2 / 8.0 U3 — максимум version 21;
- ESXi 8.0 и 8.0 U1 — максимум version 20;
- ESXi 7.0 U2 / 7.0 U3 — максимум version 19 (7.0 U1 — 18, 7.0 — 17);
- в веб-клиенте vSphere есть пункт Upgrade VM Compatibility и нет ни одного пункта Downgrade.
Как это выглядело у нас: «ТепличныйГрад», два хоста и один из них резервный
Тепличное хозяйство, 18 рабочих мест: агрономы, склад, отгрузка в торговые сети, бухгалтерия на 1С. Стенд: свежий Dell PowerEdge R660 под ESX 9.0 — основной хост, и старый HP DL380 Gen10, который живёт отдельно как холодный резерв и приёмник реплик Veeam, на нём ESXi 8.0 U3. Восемь виртуалок, из них критичные три: контроллер домена, сервер 1С и SQL (к нему же ходит система учёта климата и поливов теплиц). Схема простая и рабочая: боевые машины крутятся на новом узле, Veeam каждые 4 часа гонит реплики на DL380, и в теории при отказе основного хоста мы за 10–15 минут поднимаем реплики на резерве.
Апгрейд до ESX 9.0 прошёл штатно. А через неделю системный администратор клиента честно доделал то, что ему подсказал vCenter: в списке ВМ висело предупреждение о том, что совместимость машин ниже поддерживаемой хостом, и он прошёлся по всем восьми с пунктом Upgrade VM Compatibility → ESX 9.0 and later. Логика понятная: раз система сама подсказывает — значит надо. Машины перезагрузились в ближайшее окно, всё поднялось, никто ничего не заметил.
Заметил Veeam. Точнее, заметили мы, когда в 03:40 прилетел алерт: три задания репликации упали на этапе работы с целевой машиной на резервном хосте — в логах фигурировала несовместимость версии виртуального оборудования. Ещё через день попробовали ради проверки поднять на DL380 старую реплику, снятую до апгрейда — она поднялась, потому что была на version 19. А вот заново снять реплику с боевого 1С уже не получалось никак. По ресурсам DL380 был свободен на две трети: 192 ГБ RAM, 24 ядра, 4 ТБ на локальном RAID. И при этом он не мог запустить виртуалку с 8 vCPU и 32 ГБ памяти. Это ровно та ситуация, ради которой я и пишу статью: у резерва достаточно железа и ноль возможностей.
Разбирали три дня. Домен-контроллер и файловый сервер с агрономическими отчётами вернули откатом на снапшоты — их, по счастью, делали перед окном обновления и ещё не успели схлопнуть. Сервер 1С и SQL снапшотов уже не имели (консолидировали через сутки, чтобы не пухли дельты), их пересобирали вручную: новая ВМ с совместимостью ESXi 8.0 U2 and later, подключение существующих VMDK, правка сетевых настроек в госте. Суммарно по двум машинам — около двух часов простоя в выходной. Дёшево отделались только потому, что резерв в тот момент никому не понадобился по-настоящему.
- Два хоста разных версий: новый Dell PowerEdge R660 на ESX 9.0 — боевой, старый HP DL380 Gen10 на ESXi 8.0 U3 — холодный резерв и приёмник реплик Veeam.
- Администратор клиента выполнил Upgrade VM Compatibility по подсказке vCenter на всех восьми машинах, не подозревая о последствиях для резерва.
- Проблема вскрылась не сразу, а через Veeam: задания репликации на резервный хост стали падать из-за несовместимости версии виртуального оборудования.
- У резервного хоста было достаточно свободных ресурсов, но он не мог запустить обновлённые ВМ — отказоустойчивость исчезла незаметно для мониторинга.
- Восстановление заняло три дня: контроллер домена и файловый сервер откатили по снапшотам, сервер 1С и SQL пересобрали вручную как новые ВМ с подключением старых VMDK.
Почему версия поднимается сама, когда вы её не просили
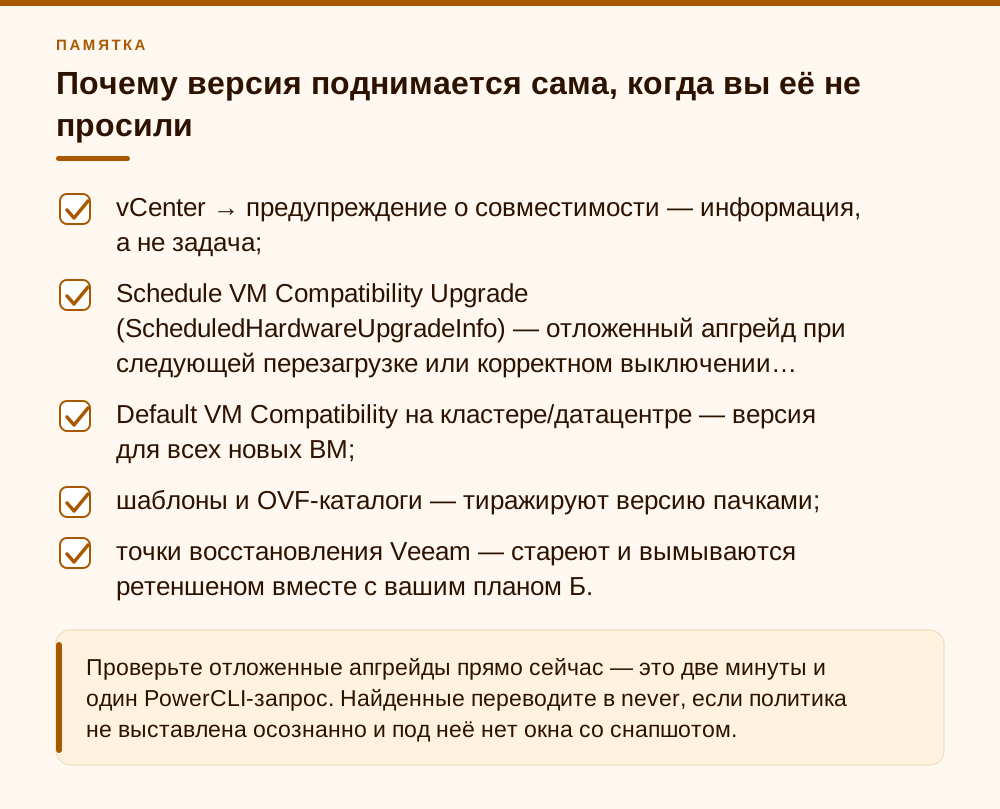
Первый механизм — то самое предупреждение в vCenter. Оно не ошибка и не требование, это просто информационная плашка «совместимость ВМ ниже, чем поддерживает хост». Но выглядит она как задача в бэклоге, и рано или поздно кто-нибудь её закроет. Особенно если админ новый и по инерции лечит всё жёлтое.
Второй механизм опаснее: отложенное обновление. В контекстном меню машины есть Compatibility → Schedule VM Compatibility Upgrade — vCenter запоминает целевую версию в свойстве ScheduledHardwareUpgradeInfo, и железо обновляется при следующей перезагрузке ВМ. Галочка «Only upgrade after normal guest OS shutdown» сужает это до корректного выключения гостя; в API это значения политики upgradePolicy: never, onSoftPowerOff и always. Срабатывает такая политика через недели, когда про неё уже все забыли — например, в ночь патч-вторника. Внешне это выглядит как «после обновления Windows виртуалка перестала подниматься на резерве». Ищите не в Windows.
Третий — уровень по умолчанию. У кластера и у датацентра есть параметр Default VM Compatibility. Если он не задан (тогда по документации совместимость берётся от версии хоста, на котором создаётся ВМ) или прямо выставлен в ESX 9.0 and later, то каждая новая ВМ и каждая машина, развёрнутая из шаблона, поедет на version 22 сразу при создании. Никто ничего не обновлял — просто новые машины по умолчанию несовместимы с резервом. Отдельно проверьте шаблоны: конвертация шаблона в ВМ и обратно с обновлением совместимости — классический способ незаметно поднять версию всему потоку новых серверов.
И четвёртое, про что забывают: реплики и бэкапы несут версию источника. Точка восстановления хранит конфигурацию машины такой, какой она была в момент снятия, и рассчитывать на то, что система резервного копирования сама понизит железо под старый хост, я бы не стал — проверяется это только тестовым восстановлением на тот самый хост. Значит, ваш backup repository после апгрейда постепенно заполняется точками восстановления, которые на старый хост без дополнительной возни уже не встанут. Пока в цепочке есть старые точки — у вас есть план Б, и он тихо истекает по ретеншену.
- vCenter → предупреждение о совместимости — информация, а не задача;
- Schedule VM Compatibility Upgrade (ScheduledHardwareUpgradeInfo) — отложенный апгрейд при следующей перезагрузке или корректном выключении гостя;
- Default VM Compatibility на кластере/датацентре — версия для всех новых ВМ;
- шаблоны и OVF-каталоги — тиражируют версию пачками;
- точки восстановления Veeam — стареют и вымываются ретеншеном вместе с вашим планом Б.
Как вернуть ВМ назад: снапшот, новая ВМ и манёвр через OVF
Broadcom в KB 339998 («Downgrading the virtual machine hardware version in ESXi») описывает ровно три варианта понижения версии виртуального оборудования, и начинать каждый нужно с выключения машины. Первый — откат на снимок, сделанный до обновления железа. Это единственный по-настоящему быстрый путь: снапшот хранит конфигурацию ВМ целиком, включая virtualHW.version, и возврат к нему возвращает старую версию за минуту. Ограничение очевидное: снимок должен существовать. Держать его неделями ради страховки — плохая идея, дельты растут и бьют по производительности, поэтому окно у вас реально сутки-двое.
Второй — создать новую ВМ нужной совместимости и подключить к ней существующий диск. Способ надёжный, я им пользуюсь чаще всего. Порядок такой: гасим машину, снимаем VMDK из настроек (именно Remove, ни в коем случае не Delete from disk), создаём новую ВМ с явным выбором Compatibility = ESXi 8.0 U2 and later, ставим тот же гостевой ОС-тип, добавляем существующий диск с датастора, проверяем контроллер (PVSCSI/NVMe должны совпасть с тем, что стоял, иначе гость не найдёт загрузочный том), забираем MAC-адреса со старой машины, если к ним привязаны лицензии или DHCP-резервации. Гость после этого чаще всего переопределяет сетевую карту, поэтому статику в Windows придётся вбить заново — старый адаптер останется скрытым устройством и будет держать IP.
Третий вариант из KB — vCenter Converter: в мастере на шаге Specify Destination выбирается нужная версия виртуального железа, и машина фактически клонируется в новую ВМ с пониженной совместимостью. Скажу честно: в 2026 году я на него не полагаюсь, продукт живёт своей жизнью и городить P2V-инструмент ради понижения версии смысла мало. А самый популярный совет из интернета — открыть .vmx и руками поправить virtualHW.version с 22 на 21 — на проде не делайте вовсе. Строка версии это лишь заголовок; вместе с апгрейдом в конфиг могли приехать устройства и параметры, которых старый гипервизор не понимает, и вы получите либо отказ регистрации, либо ВМ, которая падает на старте с невнятной ошибкой. В лаборатории — пожалуйста, для боевого 1С — нет.
Отдельный сценарий — когда ВМ надо не просто понизить, а физически перевезти на автономный ESXi 8.0 U3, где нет ни общего хранилища, ни vCenter. Тут выручает ovftool — но сразу оговорюсь, в перечне KB 339998 этого способа нет, это практический манёвр под мою ответственность: экспортируем выключенную машину в OVF (не OVA — нам нужен читаемый дескриптор), правим тип виртуальной системы и заливаем на целевой хост.
# 1. Экспорт с исходного ESX 9.0 (машина выключена)
ovftool --targetType=OVF --noSSLVerify \
  vi://root@esx9-01.example.local/TG-1C \
  /mnt/export/TG-1C.ovf

# 2. Понижаем VirtualSystemType в дескрипторе (vmx-22 -> vmx-21)
sed -i 's|vmx-22|vmx-21|g' /mnt/export/TG-1C.ovf

# 3. Контрольные суммы больше не сойдутся — убираем манифест
rm -f /mnt/export/TG-1C.mf

# 4. Заливаем на резервный ESXi 8.0 U3
ovftool --lax --noSSLVerify --datastore=DS-LOCAL-01 \
  --network='VM Network' \
  /mnt/export/TG-1C.ovf \
  vi://root@esxi8-dr.example.local/
Ключевой момент — флаг --lax: он ослабляет проверку соответствия спецификации и позволяет импортировать дескриптор, который формально не совпадает с ожидаемым. Второй момент: правка типа системы не убирает из конфигурации устройства, которых на восьмёрке нет, поэтому перед экспортом снимите всё лишнее — vTPM, проброс устройств, экзотические контроллеры, привязку к vGPU. И помните, что экспорт крупной ВМ в OVF — это полный размер её дисков на промежуточном хранилище плюс два прохода по сети: для терабайтного SQL считайте часы простоя, а не минуты, и лучше сразу идите путём новой ВМ с подключением существующего VMDK.
- откат на снапшот, сделанный до апгрейда — быстро, но окно живёт сутки-двое;
- новая ВМ нужной совместимости + подключение существующего VMDK — основной рабочий способ;
- экспорт в OVF с правкой VirtualSystemType и импортом с --lax — аварийный манёвр вне перечня KB 339998, для переезда на автономный хост;
- vCenter Converter с выбором версии на шаге Specify Destination — поддерживаемый способ из KB 339998, по сути клонирование с понижением;
- ручная правка virtualHW.version в .vmx — не поддерживается, в проде не применять.
Правила, по которым я теперь разрешаю трогать виртуальное железо
Главное правило звучит скучно: не обновляйте версию виртуального оборудования без конкретной причины. Не «чтобы было новее», а «нам нужна вот эта функция, она требует не ниже такой-то версии». В документации Broadcom честно написано, что переход на version 22 открывает ряд дополнительных возможностей — но для типовой компании на 15–50 мест с доменом, файловой шарой, 1С и SQL разница между version 19 и version 22 в повседневной работе не заметна вообще. Значимые вещи вроде UPTv2-режима сети или latency sensitivity High with Hyperthreading требуют version 20, и она у вас, скорее всего, уже есть.
Второе правило — фиксируем целевую версию на уровне кластера и датацентра, а не оставляем на усмотрение мастера создания ВМ. Ставим Default VM Compatibility равным версии самого старого хоста, который обязан уметь запускать эти машины: есть резервный ESXi 8.0 U3 — значит ESXi 8.0 U2 and later (version 21), и точка. Это одна настройка, которая закрывает три из четырёх способов случайного апгрейда.
Третье — окно и снапшот. Если апгрейд версии всё-таки нужен, он делается пачками не больше 3–5 машин за окно, каждой перед выключением делается снимок без памяти с именем вида pre-hw22-2026-09-07, и снимки живут ровно до следующего успешного цикла бэкапа, потом консолидируются. Это тот случай, когда снапшот не костыль, а точка отката по инструкции самого вендора.
И четвёртое, организационное: резервный хост и приёмник реплик обновляются раньше боевых, а не позже. Логика контринтуитивная — обычно новое катят на прод в последнюю очередь. Но с версиями виртуального железа порядок обратный: пока приёмник старее источника, у вас в схеме зашита мина. Если поднять резерв до ESX 9.0 прямо сейчас нельзя (нет лицензий, железо не в HCL девятки), то боевой кластер держите на version 21 и живите спокойно — потерь не будет никаких.
- версия виртуального железа = версия самого старого обязательного хоста, не выше;
- Default VM Compatibility прибит гвоздями на кластере и датацентре;
- перед апгрейдом — снапшот, живущий до следующего успешного бэкапа;
- приёмник реплик и DR-хост обновляются первыми;
- после апгрейда парка — контрольный запуск одной реплики на резерве, руками.
Аудит парка за десять минут
Прежде чем что-то менять, полезно посмотреть, что уже есть. Три запроса PowerCLI дают полную картину: какие версии хостов в парке, как распределены версии железа по машинам и у кого висит отложенный апгрейд.
# Версии хостов
Get-VMHost | Select-Object Name, Version, Build, ConnectionState | Sort-Object Version

# Распределение версий виртуального железа по парку
Get-VM | Group-Object HardwareVersion | Select-Object Count, Name | Sort-Object Name

# Кто уже уехал выше потолка резервного хоста (vmx-21)
Get-VM | Where-Object { [int]($_.HardwareVersion -replace 'vmx-','') -gt 21 } |
  Select-Object Name, HardwareVersion, VMHost, PowerState

# Отложенные апгрейды: политика должна быть never
Get-VM | Where-Object {
    $p = $_.ExtensionData.Config.ScheduledHardwareUpgradeInfo.UpgradePolicy
    $p -and $p -ne 'never' } |
  Select-Object Name,
    @{N='Policy';E={$_.ExtensionData.Config.ScheduledHardwareUpgradeInfo.UpgradePolicy}},
    @{N='TargetVer';E={$_.ExtensionData.Config.ScheduledHardwareUpgradeInfo.VersionKey}}
Отключается отложенный апгрейд через ReconfigVM — руками по одной машине это долго, поэтому сразу циклом.
$spec = New-Object VMware.Vim.VirtualMachineConfigSpec
$spec.ScheduledHardwareUpgradeInfo = New-Object VMware.Vim.ScheduledHardwareUpgradeInfo
$spec.ScheduledHardwareUpgradeInfo.UpgradePolicy = 'never'

Get-VM | Where-Object {
    $p = $_.ExtensionData.Config.ScheduledHardwareUpgradeInfo.UpgradePolicy
    $p -and $p -ne 'never' } |
  ForEach-Object { $_.ExtensionData.ReconfigVM($spec); Write-Host "fixed: $($_.Name)" }
Если vCenter недоступен или его вообще нет, то же самое можно посмотреть прямо на хосте по SSH — версия записана параметром virtualHW.version в каждом .vmx. Заодно этот прогон покажет машины, зарегистрированные не там, где вы думали.
# На хосте ESXi/ESX
grep -H 'virtualHW.version' /vmfs/volumes/*/*/*.vmx | sort -t'"' -k2 -n

# Версия и билд самого хоста
vmware -vl
Результат этого аудита — простой список: сколько машин уже на version 22 и сколько из них обязаны уметь заводиться на резерве. Если пересечение пустое, вы просто фиксируете политику и живёте дальше. Если нет — планируете окно на пересборку по способу с новой ВМ и существующим диском, пока в бэкапах ещё лежат старые точки восстановления.
- Три запроса PowerCLI дают полную картину: версии хостов, распределение версий виртуального железа по ВМ и список машин с отложенным апгрейдом.
- Отдельный запрос находит машины, уже превысившие потолок совместимости резервного хоста.
- Политику отложенного апгрейда нужно выставить в never — массово это делается через ReconfigVM циклом по всем ВМ, а не вручную по одной машине.
- Без vCenter то же самое проверяется прямо на хосте по SSH: версия виртуального железа читается из параметра virtualHW.version в файлах .vmx.
- Итог аудита — простой список: сколько машин уже на новой версии и есть ли среди них обязанные заводиться на резерве; по результату либо фиксируют политику, либо планируют окно на пересборку.
Если резервный хост уже не тянет: что делать по приоритетам
Ситуация «половина парка на version 22, резерв на восьмёрке» лечится в три хода, и порядок тут важен. Сначала — зафиксировать урон: выяснить, какие именно критичные сервисы потеряли резервную площадку, и на бумаге, а не в голове. Обычно это домен-контроллер, сервер 1С и почта, и по ним у бизнеса есть заявленное время восстановления, которое вы сейчас не выполняете. Это разговор с руководителем, а не техническая задача.
Дальше — быстрое временное решение. Не трогая боевые машины, убедитесь, что в цепочке бэкапов есть хотя бы одна точка восстановления с совместимой версией железа, и заморозьте её ретеншен (в Veeam — отдельная задача GFS или ручной экспорт полной точки на отдельный том). Это костыль на неделю-две, но он возвращает вам хоть какой-то план Б на время, пока вы разбираетесь по-настоящему.
И третий ход — выбрать стратегическое направление. Вариантов ровно два, и оба нормальные. Либо вы поднимаете резервный хост до ESX 9.0 — тогда проверяйте железо по списку совместимости девятки заранее, у Broadcom с каждым релизом список сокращается, и старый сервер туда может просто не попасть. Либо вы принимаете, что резерв остаётся на восьмёрке, и опускаете весь парк обратно на version 21 через пересоздание ВМ — по 2–3 машины за выходные, начиная с самых критичных. Второй путь дешевле и его я советую чаще, потому что он не требует ни новых лицензий, ни закупки железа, а функционально вы не теряете ничего.
Чего точно не надо делать — оставлять всё как есть в надежде, что не пригодится. Резервный хост, который не может запустить нужную ВМ, хуже отсутствующего: он занимает место в схеме отказоустойчивости, на него смотрят при планировании и на него рассчитывают в аварии. Пусть лучше в документации честно стоит «резерва по 1С сейчас нет», чем строчка про DL380, который в час икс откажется включать виртуалку.
- определить, какие сервисы фактически остались без резервной площадки;
- заморозить совместимую точку восстановления как временный план Б;
- проверить резервный хост по списку совместимости ESX 9.0 — попадает ли он туда вообще;
- выбрать: поднимать резерв до девятки или опускать парк до version 21;
- обновить документацию по DR, чтобы схема отражала реальность.
Частые вопросы
Можно ли понизить hardware version прямо из веб-клиента vSphere?
Нет. В интерфейсе есть только Upgrade VM Compatibility, пункта понижения не существует ни в одной версии клиента. Broadcom в KB 339998 предлагает три обходных пути на выключенной машине: откат на снимок, сделанный до апгрейда, клонирование через vCenter Converter с выбором целевой версии на шаге Specify Destination или создание новой ВМ нужной совместимости с подключением существующего VMDK.
Что будет, если просто поправить строку virtualHW.version в .vmx с 22 на 21?
Такой сценарий не поддерживается. Строка версии — это только заголовок конфигурации: устройства и параметры, добавленные при апгрейде, из файла никуда не денутся, и старый гипервизор либо откажется регистрировать машину, либо не сможет её включить. В лаборатории попробовать можно, на продуктиве — не стоит, восстанавливать потом дольше, чем пересобрать ВМ правильно.
Обязательно ли обновлять виртуальное железо после перехода на ESX 9.0?
Нет. ESX 9.0 обратно совместим с более ранними версиями виртуального оборудования, и машины на version 19 или 21 работают на нём штатно. Предупреждение в vCenter о том, что совместимость ВМ ниже поддерживаемой хостом, — информационное. Обновлять версию имеет смысл только под конкретную функцию, которая её требует.
Почему после апгрейда перестали работать реплики Veeam на старом хосте?
Потому что реплика несёт конфигурацию источника, включая версию виртуального оборудования. Если источник уехал на version 22, а хост-приёмник работает на ESXi 8.0 U3 с потолком version 21, то по KB 315655 такой хост машину просто не включит — задание или запуск реплики падает. Ресурсы приёмника при этом ни при чём: не хватает не памяти и не дисков, а поддержки версии железа. Итог всегда проверяйте тестовым запуском реплики на резерве.
Какую версию виртуального оборудования выбрать, если в парке есть и ESX 9.0, и ESXi 8.0 U3?
Version 21 — потолок ESXi 8.0 U2/U3. Зафиксируйте её в параметре Default VM Compatibility на уровне кластера и датацентра, чтобы новые ВМ и машины из шаблонов не создавались сразу на version 22. Так весь парк остаётся мобильным между хостами обеих версий.
Как быстро найти машины с отложенным апгрейдом совместимости?
Через PowerCLI: отфильтровать ВМ, у которых ExtensionData.Config.ScheduledHardwareUpgradeInfo.UpgradePolicy задан и отличается от never. Значение always означает апгрейд при следующей перезагрузке, onSoftPowerOff — при следующем корректном выключении гостя, например в ночь установки обновлений Windows, когда никто этого не ждёт.
Источники
- Broadcom KB 315655 — Virtual machine hardware versions — Таблица максимальных версий виртуального железа по хостам: ESX 9.0 — 22, ESXi 8.0 U2 — 21, ESXi 8.0 — 20, ESXi 7.0 U2 — 19; продукт VMware не может включить ВМ с версией выше поддерживаемой. https://knowledge.broadcom.com/external/article/315655
- Broadcom KB 312100 — ESXi hosts and compatible virtual machine hardware versions — Детальная матрица: version 22 работает только на ESX 9.0; version 21 — на ESX 9.0 и ESXi 8.0 U2/U3; version 20 — начиная с ESXi 8.0 U1. https://knowledge.broadcom.com/external/article/312100/esxiesx-hosts-and-compatible-virtual-mac.html
- vSphere 9.0 Virtual Machine Administration — Virtual Machine Compatibility (techdocs.broadcom.com) — Совместимость ESX 9.0 and later = hardware version 22, не запускается на ESX 6.5–8.0 U3; дефолтная совместимость зависит от версии хоста и настройки на хосте, кластере или датацентре. https://techdocs.broadcom.com/us/en/vmware-cis/vsphere/vsphere/9-0/vsphere-virtual-machine-administration/configuring-virtual-machine-hardware/virtual-machine-compatibility.html
- vSphere 9.0 — Upgrading Virtual Machines (techdocs.broadcom.com) — Обновление виртуального железа — тяжёлая операция, требует выключения ВМ; ручной и запланированный апгрейд совместимости. https://techdocs.broadcom.com/us/en/vmware-cis/vsphere/vsphere/9-0/vsphere-virtual-machine-administration/upgrading-virtual-machines.html
- Broadcom KB 339998 — Downgrading the virtual machine hardware version in ESXi — Три метода на выключенной ВМ: откат на снимок до апгрейда; vCenter Converter с выбором версии в Specify Destination; новая ВМ нужной версии с подключением существующего диска. https://knowledge.broadcom.com/external/article/339998
- Performance Best Practices for VMware vSphere 9.0 — ВМ на hardware version 22 не работают на ESXi до 9.0 и переносятся vMotion только на ESX 9.0+, что сужает выбор для DRS/DPM; UPTv2 и latency sensitivity High with Hyperthreading требуют version 20. https://www.vmware.com/docs/vsphere-esxi-vcenter-server-90-performance-best-practices
- vSphere Web Services API — ScheduledHardwareUpgradeInfo — Свойства upgradePolicy, versionKey, scheduledHardwareUpgradeStatus; политики never, onSoftPowerOff, always. https://developer.broadcom.com/xapis/vsphere-web-services-api/latest/vim.vm.ScheduledHardwareUpgradeInfo.html
- VMware OVF Tool User Guide — Ключи ovftool, в том числе --lax и --targetType=OVF. https://developer.broadcom.com/tools/open-virtualization-format-ovf-tool/latest