
После обновления до vCenter 9.0 остались ВМ vCLS: включать Retreat Mode или нет
Обновили vCenter до 9.0, а в инвентаре по-прежнему висят служебные ВМ vCLS-xxxxxxxx. Гуглите — и получаете две прямо противоположные инструкции: одна кричит «никогда не трогайте vCLS, развалите DRS», вторая говорит «Broadcom сам рекомендует Retreat Mode». Обе правы, просто написаны для разных версий. Ниже — где проходит граница, как я включаю Retreat Mode на боевых кластерах, какие грабли ломают vpxd намертво и что проверять после.
Одна и та же кнопка, два противоположных смысла
Ситуация, которую вижу почти на каждом апгрейде: инженер закончил обновление vCenter, зашёл в инвентарь и увидел там ВМ вида vCLS-4f2a9c1e-... — без сетевой карты, без консоли, которые нельзя нормально выключить, потому что они тут же поднимаются заново. Дальше он идёт в поиск, находит статью 2022 года с жирным предупреждением «Retreat Mode ломает DRS, использовать только по указанию поддержки», и оставляет всё как есть. И это правильное решение — для vSphere 7.0 и 8.0. Но не для 9.0.
Разберём по порядку. vCLS (vSphere Cluster Services) появился в vSphere 7.0 Update 1. Идея была такая: control plane кластера не должен зависеть от доступности vCenter. В исходной реализации, которую теперь называют External vCLS, на каждый кластер разворачивается от одной до трёх крошечных агентских ВМ на Photon OS. Каждая — 1 vCPU с резервом 100 МГц, 128 МБ памяти с резервом 100 МБ, диск 2 ГБ (thin, реально около 500 МБ) и без сетевого адаптера вообще. В vSphere 8.0 Update 3 архитектуру поменяли: когда и vCenter, и хосты обновлены до 8.0 U3, вместо агентов появляется Embedded vCLS — ВМ на технологии vSphere Pod с контейнерным рантаймом, два экземпляра на кластер, 1 vCPU и 160 МБ памяти с полным резервом, без диска: образ статический, данные в ramdisk хоста, datastore не используется. vMotion для них не поддерживается — при эвакуации хоста экземпляр уничтожается и создаётся заново на другом узле. И те и другие едят копейки ресурсов, но они есть, они попадают в бэкап-задания, в алармы и в отчёты, и управлять ими руками как обычными ВМ нельзя.
До vSphere 9.0 Retreat Mode был аварийным механизмом. Он честно удаляет агентские ВМ, но, как прямо написано в KB 316514, после этого «vSphere DRS will not function on that cluster» — то есть нагрузка перестаёт балансироваться, а vSphere HA перестаёт делать оптимальное размещение при отказе хоста. На кластерах vSAN здоровье кластерных служб уходит в Degraded. Именно поэтому все старые инструкции пишут про Retreat Mode как про крайнюю меру: включил, починил зависшие агенты, выключил обратно.
В vCenter 9.0 архитектура изменилась. vCLS объявлен устаревшим, и KB 312147 формулирует это без обиняков: «vCenter 9.0 deprecates vCLS, and the service will be removed in a future vCenter release», а требование держать vCLS активным на кластере снято, с прямой рекомендацией перевести службу в Retreat Mode, чтобы не тратить ресурсы на избыточный сервис. И самое важное для нашей темы — та же KB явно перебивает все прежние формулировки: деактивация vCLS не влияет на работу vSphere DRS и vSphere HA для vCenter версий 9.0 и выше. Технически это стало возможным потому, что в ESX 9 состояние кластера хранится в распределённом встроенном key-value store прямо на хостах, внешние служебные ВМ ему больше не нужны.
- vSphere 7.0 U1 — 8.0 U2: External vCLS (до трёх агентских ВМ), Retreat Mode выключает DRS. Не трогать.
- vSphere 8.0 U3 (vCenter и хосты): Embedded vCLS на vSphere Pod, два экземпляра на кластер, без datastore; правила Retreat Mode прежние — DRS без vCLS не работает. Не трогать.
- vSphere 9.0 и выше: vCLS deprecated, Retreat Mode рекомендован, DRS и HA не страдают.
- External-агент = 1 vCPU / 128 МБ RAM / 2 ГБ thin-диска; Embedded-экземпляр = 1 vCPU / 160 МБ RAM без диска.
Сначала определите, какой у вас vCLS и какая версия кластера
Прежде чем что-то включать, надо честно ответить на два вопроса: какая версия vCenter и какая версия ESX на хостах конкретного кластера. Это не одно и то же. Я регулярно вижу схему, где vCenter уже 9.0, а хосты в паре кластеров ещё на 8.0 U3 — типичное состояние в середине окна апгрейда. Логика простая: правила про DRS и HA завязаны на версию vCenter, поэтому именно её надо смотреть в первую очередь, но окончательное решение по конкретному кластеру я принимаю только когда и vCenter, и все его хосты приехали на 9.x.
Версию vCenter смотрю в веб-клиенте (Administration → Deployment → System Configuration) или из шелла командой vpxd -v. Версии хостов — быстрее всего скриптом. Сами vCLS-ВМ в представлении Hosts and Clusters спрятаны, их видно в VMs and Templates внутри отдельной папки vCLS в корне датацентра, а также в корневом пуле ресурсов кластера; Embedded-экземпляры помечены в интерфейсе как CRX. Не пугайтесь, если папка выглядит пустой: агенты могли быть уже сняты Retreat Mode'ом ранее либо ещё не развернулись после перезапуска vpxd.
Инвентаризацию делаю через VCF PowerCLI (актуальная линейка на 2026 год — 9.1) или через govc. Мне нужен список кластеров с их domain-id, потому что именно domain-c<номер> станет частью имени advanced setting, если придётся идти через продвинутые настройки, а не через UI:
# Список кластеров с moref (domain-cNN) и числом vCLS-агентов
Connect-VIServer vcenter.corp.local

Get-Cluster | Select-Object Name,
  @{n='DomainId';e={$_.ExtensionData.MoRef.Value}},
  @{n='vCLS';e={ (Get-VM -Location $_ -Name 'vCLS*' -ErrorAction SilentlyContinue).Count }},
  DrsEnabled, HAEnabled | Format-Table -AutoSize

# Версии хостов по кластерам
Get-VMHost | Select-Object Name, Version, Build,
  @{n='Cluster';e={$_.Parent.Name}} | Sort-Object Cluster | Format-Table
То же самое через govc, если PowerShell под рукой нет:
export GOVC_URL='https://vcenter.corp.local'
export GOVC_USERNAME='administrator@vsphere.local'
export GOVC_INSECURE=1

govc find / -type c            # пути кластеров
govc ls -i /DC/host/PROD-CL    # вывод: ClusterComputeResource:domain-c8 /DC/host/PROD-CL
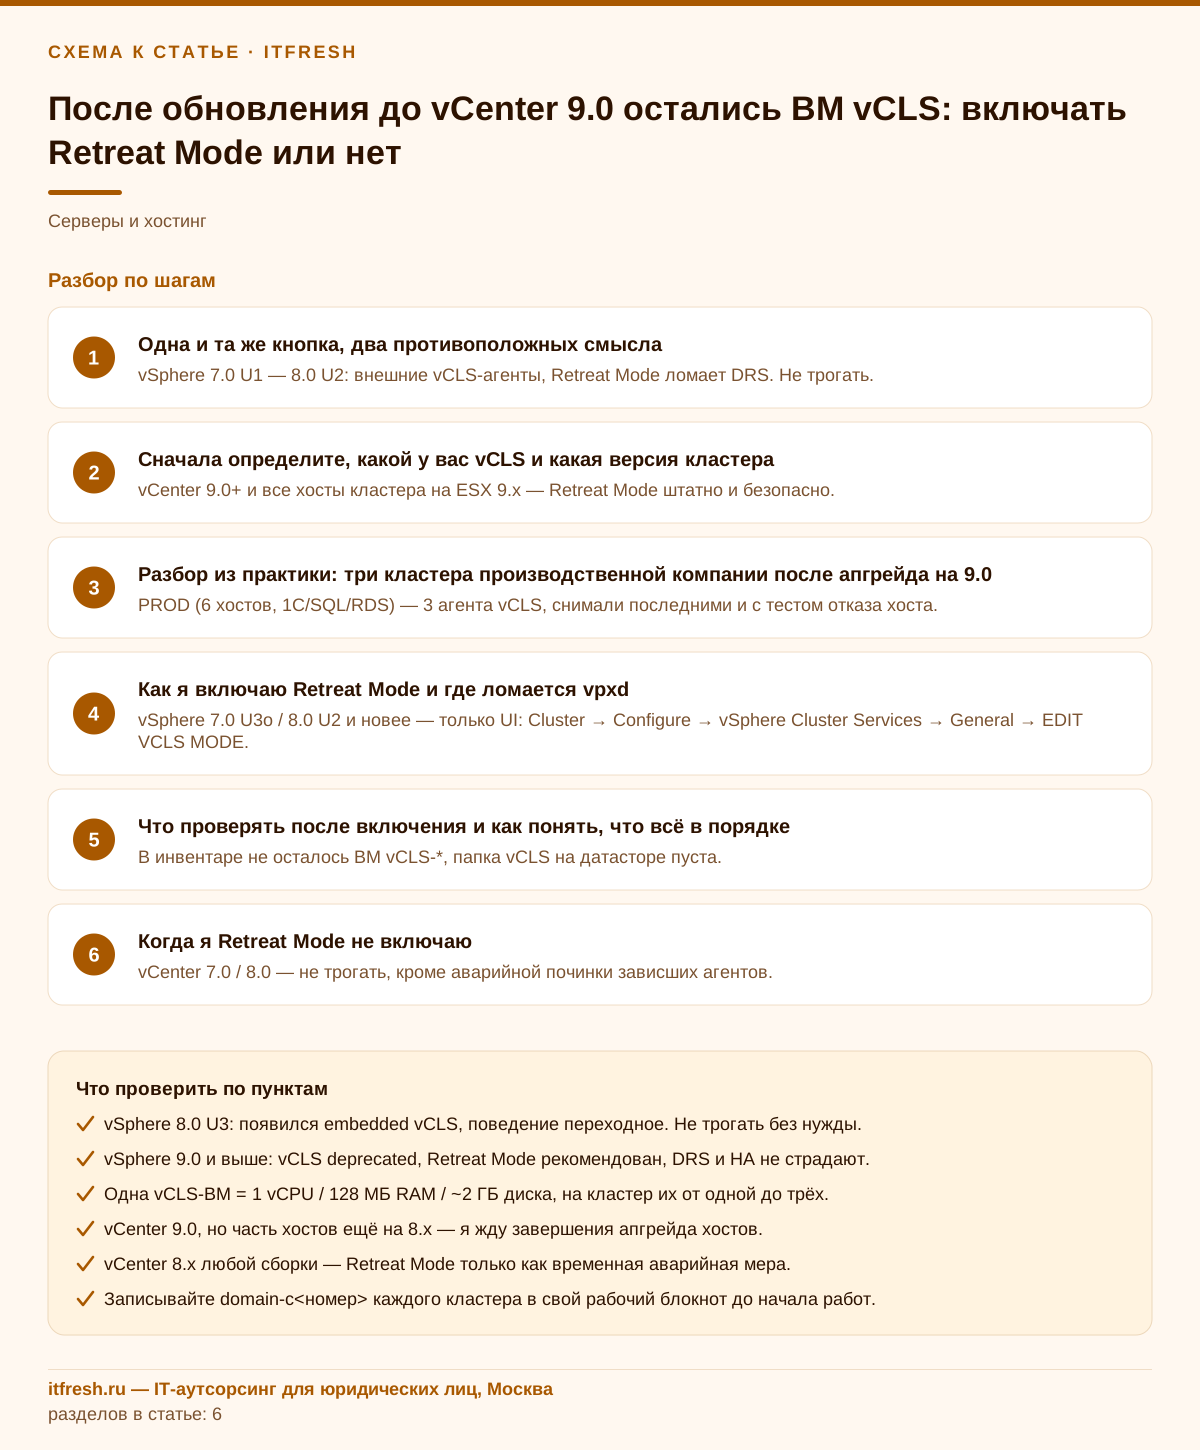
govc find / -type m -name 'vCLS*' # сами агентские ВМ- vCenter 9.0+ и все хосты кластера на ESX 9.x — Retreat Mode штатно и безопасно.
- vCenter 9.0, но часть хостов ещё на 8.x — я жду завершения апгрейда хостов.
- vCenter 8.x любой сборки — Retreat Mode только как временная аварийная мера.
- Записывайте domain-c<номер> каждого кластера в свой рабочий блокнот до начала работ.
Разбор из практики: два кластера кейтеринговой компании после апгрейда на 9.0
Условно — кейтеринговая компания «Горячий стол», 31 рабочее место: офис, производственная кухня, логистика доставки. Инфраструктура на нашей площадке, два кластера в одном vCenter. PROD — три хоста: 1С (бухгалтерия, производственный учёт и калькуляция блюд), SQL, терминальный сервер для менеджеров и диспетчеров доставки, файловый сервер. DRS в режиме Fully Automated с порогом 3, HA с Admission Control на 1 хост. TEST — два хоста под тестовые копии баз 1С и сервер видеонаблюдения цеха. Апгрейд vCenter с 8.0 U3 на 9.0 прошёл штатно, хосты доехали на ESX 9.0 в течение следующих двух недель.
Так как стенд ещё на 8.0 U3 перешёл на Embedded vCLS, после апгрейда в инвентаре было четыре экземпляра vCLS — по два на кластер. По ресурсам это смешные цифры: 4 vCPU и около 640 МБ зарезервированной памяти на весь vCenter, на датасторах — ноль. Если бы дело было только в ресурсах, я бы вообще не стал этим заниматься. Проблема была в другом, и она типовая.
Первое: бэкап. Задания резервного копирования собраны по контейнерам — «весь кластер PROD», — и служебные ВМ из корневого пула ресурсов попадали в выборку, давая в отчётах предупреждения о пропущенных объектах без сети и гостевой ОС. Бэкапить их вендор не рекомендует, так что это чистый шум. Второе: события. При каждом вводе хоста в Maintenance Mode Embedded-экземпляр не мигрирует, а уничтожается и создаётся на соседнем хосте — в Recent Tasks и журнале сыпались задачи удаления и развёртывания vCLS, и дежурный каждый раз выяснял заново, авария это или норма. Третье: мониторинг и инвентарные отчёты, где «ВМ без сетевой карты» годами висели в исключениях. Суммарно за квартал эти мелочи стоили нам больше времени, чем все сэкономленные мегабайты.
Порядок работ был такой. Сначала TEST: включили Retreat Mode через UI, дождались, пока экземпляры корректно снимутся, и оставили кластер на трое суток под нагрузкой тестовых баз. DRS продолжил мигрировать ВМ по порогу, событий про недоступность кластерных служб не было, здоровье кластера осталось зелёным. PROD — только на третьей неделе и с обязательным тестом в окно после вечерней смены кухни: жёстко обесточили один хост через iDRAC и убедились, что HA перезапустил 1С, SQL и терминальный сервер на двух оставшихся, а DRS в течение получаса выровнял нагрузку. Итог: служебные экземпляры убраны, шум в задачах и событиях исчез, бэкап-отчёты стали чистыми. За четыре месяца ни одного отката.
Скажу честно про спорное место. Я не советую включать Retreat Mode в тот же день, когда вы закончили обновление vCenter. Не потому, что это опасно по документации — по документации всё чисто. А потому, что после мажорного апгрейда неделю-другую всплывают посторонние сюрпризы, и вам не нужен лишний изменённый параметр в списке подозреваемых. Дайте кластеру постоять как есть, закройте хвосты по хостам, а потом отдельным маленьким изменением снимайте vCLS.
- PROD (3 хоста, 1С/SQL/RDS) — 2 экземпляра Embedded vCLS, снимали последними и с тестом отказа хоста.
- TEST (2 хоста, тестовые базы и видеонаблюдение) — 2 экземпляра, пилотный кластер, наблюдение 72 часа.
- Тест отказа хоста на PROD — в окно, когда кухня не принимает заказы, с проверкой перезапуска 1С и терминального сервера.
- Реальная выгода — не ресурсы, а чистые бэкап-отчёты и отсутствие ложных событий по кластерным службам.
Как я включаю Retreat Mode и где ломается vpxd
Начиная с vSphere 7.0 U3o и 8.0 U2 для Retreat Mode есть штатный переключатель в интерфейсе, и в 9.0 я пользуюсь только им. Путь: выбираем кластер в Hosts and Clusters, вкладка Configure, раздел vSphere Cluster Services → General, кнопка EDIT VCLS MODE, переключатель Retreat Mode, OK. Всё. Через минуту-две агентские ВМ выключаются и удаляются штатным механизмом, а не «убиваются» — это важно, потому что при ручном удалении из инвентаря vCenter просто развернёт их заново.
Старый способ через продвинутые настройки vCenter нужен только на сборках ниже 7.0 U3o / 8.0 U2. Там выбираем объект vCenter в инвентаре, Configure → Settings → Advanced Settings → Edit Settings, добавляем новую запись с именем config.vcls.clusters.domain-c<номер>.enabled и значением False. Вот здесь и живёт главная граблина всей темы: в имя параметра надо подставить ровно domain-c<номер> и ничего больше. Если скопировать из адресной строки браузера кусок с лишними символами — например, целиком domain-c8:9c1a... вместе с UUID кластера, — vpxd после применения настройки не стартует, и вы получите неработающий vCenter на ровном месте.
Broadcom в KB 316514 даёт лечение этой ситуации: зайти в шелл VCSA и вырезать секцию vcls из конфига vpxd, после чего служба поднимется. Держите команду под рукой заранее, а не ищите её, когда веб-клиент уже недоступен:
# только если vpxd не стартует после кривой advanced setting
ssh root@vcenter.corp.local
shell

cp /etc/vmware-vpx/vpxd.cfg /root/vpxd.cfg.bak
sed '/<vcls>/,/<\/vcls>/d' -i /etc/vmware-vpx/vpxd.cfg

service-control --restart vmware-vpxd
service-control --status vmware-vpxd
Если кластеров много, делаю через VCF PowerCLI — быстрее и без риска промахнуться мышкой. Обратите внимание: advanced setting вешается на объект подключённого vCenter, а не на кластер:
$vc  = Connect-VIServer vcenter.corp.local
$cl  = Get-Cluster 'TEST-CL'
$dom = $cl.ExtensionData.MoRef.Value      # ожидаем строго domain-cNN
if ($dom -notmatch '^domain-c\d+$') { throw "Неверный domain-id: $dom" }

$name = "config.vcls.clusters.$dom.enabled"
$s = Get-AdvancedSetting -Entity $vc -Name $name -ErrorAction SilentlyContinue
if ($s) { $s | Set-AdvancedSetting -Value 'False' -Confirm:$false }
else    { New-AdvancedSetting -Entity $vc -Name $name -Value 'False' -Confirm:$false }

# вернуть как было
# Get-AdvancedSetting -Entity $vc -Name $name | Set-AdvancedSetting -Value 'True' -Confirm:$false
Проверка $dom -notmatch '^domain-c\d+$' в скрипте — не украшательство. Это ровно та защита, которая не даёт скрипту записать в конфиг vpxd строку с посторонними символами. На кластере в двадцать хостов цена такой опечатки — упавший vCenter в рабочее время.
- vSphere 7.0 U3o / 8.0 U2 и новее — только UI: Cluster → Configure → vSphere Cluster Services → General → EDIT VCLS MODE.
- Более старые сборки — advanced setting config.vcls.clusters.domain-c<номер>.enabled = False.
- Никогда не удаляйте vCLS-ВМ вручную: vCenter развернёт их заново, а для External-агентов ещё и оставит мусор на датасторе.
- Снимайте резервную копию /etc/vmware-vpx/vpxd.cfg до правки advanced settings.
Что проверять после включения и как понять, что всё в порядке
Retreat Mode отрабатывает не мгновенно. На кластере с тремя агентами у меня уходило от одной до пяти минут: ВМ сначала корректно выключаются, потом удаляются из инвентаря; у External-агентов затем ещё чистятся папки на датасторе, у Embedded-экземпляров чистить нечего — они жили в ramdisk хоста. Если через десять минут агенты всё ещё висят выключенными и не удаляются — это не норма, ищите блокировку файлов на датасторе или незавершённые задачи в клиенте. Насильно ничего не сносим, сначала смотрим Recent Tasks и events.
Дальше — проверка того, ради чего мы всё затевали: что DRS и HA живы. На vCenter 9.0 они и должны быть живы, но верить надо не документации, а своему кластеру. Мой набор проверок ниже. Отдельно смотрю на здоровье vSAN, если он есть: на версиях до 9.0 при снятых агентах кластерные службы уходили в Degraded, и надо убедиться, что на 9.0 в вашей конкретной конфигурации этого не происходит.
Последнее, о чём почти все забывают, — прибрать хвосты в обвязке. Если в бэкапе, в мониторинге или в самописных отчётах есть исключения и фильтры под имена vCLS-*, их пора убирать: объектов больше нет, а правила остаются и потом путают следующего дежурного. То же самое с алармами, которые вы когда-то заглушили из-за шума кластерных служб.
# 1. Агентов не осталось
Get-VM -Name 'vCLS*' | Select-Object Name, PowerState, VMHost

# 2. DRS живой: смотрим рекомендации и историю миграций
Get-Cluster 'PROD-CL' | Select-Object Name, DrsEnabled, DrsAutomationLevel, HAEnabled, HAAdmissionControlEnabled
Get-DrsRecommendation -Cluster 'PROD-CL'

# 3. События за сутки: нет ли жалоб на кластерные службы
Get-VIEvent -Start (Get-Date).AddDays(-1) -MaxSamples 500 |
  Where-Object { $_.FullFormattedMessage -match 'vCLS|Cluster Services|DRS|HA' } |
Select-Object CreatedTime, FullFormattedMessage | Sort-Object CreatedTime- В инвентаре не осталось ВМ vCLS-*; для External-агентов — папка vCLS на датасторе пуста.
- DRS выдаёт рекомендации и выполняет миграции при перекосе нагрузки.
- HA: тестовый отказ хоста приводит к перезапуску ВМ на оставшихся узлах.
- Здоровье кластера и, при наличии, Skyline/vSAN health — без новых предупреждений.
- Из бэкап-заданий и мониторинга убраны исключения по именам vCLS-*.
Когда я Retreat Mode не включаю
Первое и главное — если vCenter ещё не 9.0. На 7.0 и 8.0 всё, что написано в старых инструкциях, остаётся в силе: снятые агенты означают неработающий DRS на этом кластере и неоптимальное размещение при отказе хоста. Там Retreat Mode — инструмент разовой починки зависших агентов, после которой режим возвращают обратно. Если очень чешется убрать пару-тройку маленьких ВМ с 8.0 — не чешитесь, дождитесь апгрейда.
Второе — смешанные окружения. Если vCenter уже 9.0, а хосты конкретного кластера ещё на 8.x, я жду. Формально запрета нет, но проверять поведение кластера в переходном состоянии на боевой нагрузке 1С. К тому же на смешанном кластере vCenter может откатиться с Embedded на External vCLS, если совместимые хосты станут недоступны, и на это время DRS может оказаться недоступен — не та экономия, ради которой стоит рисковать. То же самое касается кластеров vSAN: там кластерные службы завязаны глубже, и я сначала прогоняю пилот на непродуктивном vSAN-кластере, а уже потом трогаю боевой.
Третье — кластеры из одного хоста, включая одно-узловые лаборатории и площадки филиалов. Там vCLS и так ведёт себя особым образом: агентская ВМ автоматически выключается при вводе единственного хоста в Maintenance Mode. Практической пользы от Retreat Mode на таком кластере нет вообще, DRS там тоже нечего балансировать. Оставьте как есть и займитесь более полезными вещами.
И честно про риск, который часто раздувают: сам по себе Retreat Mode — не разрушительная операция. Это переключатель, он обратим, агенты разворачиваются обратно за пару минут после возврата в System Managed. Опасность в этой теме одна и вполне конкретная — некорректно записанная advanced setting, роняющая vpxd. Если вы идёте через UI на поддерживаемой сборке, вы этот риск вообще не встречаете.
- vCenter 7.0 / 8.0 — не трогать, кроме аварийной починки зависших агентов.
- vCenter 9.0 + хосты 8.x в кластере — дождаться апгрейда хостов.
- Боевой vSAN — только после пилота на непродуктивном кластере.
- Кластер из одного хоста — смысла нет, оставить как есть.
Приоритеты: куда это вписать в план апгрейда
Если смотреть трезво, снятие vCLS — это гигиена, а не оптимизация. Несколько сотен мегабайт памяти и пара vCPU не спасут ни один кластер. Поэтому в плане миграции на vSphere 9.x я ставлю эту задачу далеко не первой. Первыми идут вещи, которые в 9.0 объявлены устаревшими и способны реально сломать процессы: Auto Deploy и Host Profiles, если вы на них раскатываете хосты; vVols, если у вас на них лежат тома; Enhanced Linked Mode, если у вас связка из нескольких vCenter; Image Builder, Storage I/O Control, Host Cache, baseline-подход в vSphere Lifecycle Manager, интегрированная аутентификация Windows. Вот там надо считать сроки и искать замену.
vCLS в этом списке — самый дешёвый пункт. Это двадцать минут работы на кластер плюс наблюдение, и он не требует ни закупок, ни переработки процессов. Я обычно закрываю его последним, когда все хосты приехали на 9.x и инфраструктура устоялась. Хорошая привычка — оформить это отдельной строкой в чеклисте пост-апгрейда, чтобы не всплыло через год вопросом «а что это за странные ВМ без сети».
И держите в голове горизонт: Broadcom обещает удалить vCLS в будущем релизе vCenter. То есть рано или поздно вопрос решится сам, без вашего участия. Всё, что даёт Retreat Mode сегодня, — это возможность привести инвентарь и мониторинг в порядок раньше, чем это сделает за вас следующий апгрейд. Ни срочности, ни героизма тут нет.
Мой практический вывод простой. На 9.0 включайте Retreat Mode спокойно — документация вендора это прямо рекомендует и явно снимает старую зависимость DRS и HA от vCLS. На 8.0 и ниже не включайте вообще. И в обоих случаях единственное место, где надо быть предельно аккуратным, — это domain-id при работе через advanced settings.
- Приоритет 1 при переходе на 9.x: Auto Deploy, Host Profiles, vVols, Enhanced Linked Mode — то, что требует замены процессов.
- Приоритет 2: пересбор бэкап-заданий и алармов под новую версию.
- Приоритет 3: Retreat Mode для vCLS — гигиена на 20 минут, делается последней.
- На чём можно сэкономить силы: подсчёт высвобожденных ресурсов от снятия vCLS — их там почти нет.
Частые вопросы
Можно ли просто удалить ВМ vCLS вручную?
Нет. vCenter отследит их отсутствие и развернёт заново; у External-агентов на датасторе к тому же останется мусор и, в неудачном случае, залоченные файлы. Выключение тоже не поможет — выключенный экземпляр vCLS считается сбоем и запускается снова. Поддерживаемый способ убрать vCLS — Retreat Mode, он снимает ВМ штатным механизмом.
У меня vCenter 9.0, но хосты ещё на ESXi 8.0 U3. Включать Retreat Mode?
Я жду завершения апгрейда хостов. Формального запрета нет, снятие зависимости DRS и HA от vCLS заявлено на уровне vCenter 9.0, но проверять поведение переходной конфигурации на боевом кластере — плохая идея при нулевой выгоде. Отложите на пару недель.
Как вернуть vCLS обратно, если что-то пошло не так?
Переключить кластер обратно в System Managed в том же разделе Configure → vSphere Cluster Services → General, либо выставить advanced setting config.vcls.clusters.domain-c<номер>.enabled в True. Агенты развернутся заново за несколько минут, ничего дополнительно делать не нужно.
Сколько ресурсов реально освобождается?
Мало. External-агент (до 8.0 U2) — 1 vCPU с резервом 100 МГц, 128 МБ памяти с резервом 100 МБ и тонкий диск 2 ГБ (реально около 500 МБ), на кластер от одной до трёх. Embedded-экземпляр (8.0 U3 и 9.x) — 1 vCPU и 160 МБ памяти с полным резервом, без диска, два на кластер. Делайте это ради чистого инвентаря, бэкап-отчётов и отсутствия ложных событий, а не ради ресурсов.
Почему после правки advanced settings перестал запускаться vpxd?
Почти всегда — из-за неверного имени параметра: в него подставили не чистый domain-c<номер>, а строку с лишними символами из адресной строки браузера. Лечение из KB 316514: в шелле VCSA вырезать секцию vcls из /etc/vmware-vpx/vpxd.cfg и перезапустить службу vmware-vpxd.
Что будет с vCLS дальше?
Broadcom заявил, что служба будет удалена в одном из будущих релизов vCenter. То есть на 9.x вы можете снять её сами через Retreat Mode, а можете дождаться, когда апгрейд уберёт её без вашего участия. Срочности нет.
Источники
- Broadcom KB 312147 — «vSphere Cluster Services (vCLS) in vSphere 7.0 Update 1 and newer versions» — раздел про vCenter 9.0: vCLS объявлен устаревшим и будет удалён в будущем релизе; рекомендован перевод в Retreat Mode; деактивация vCLS не влияет на vSphere DRS и vSphere HA для версий 9.0 и выше. https://knowledge.broadcom.com/external/article/312147/vsphere-cluster-services-vcls-in-vsphere.html
- Broadcom KB 316514 — «Disable vCLS on a Cluster via Retreat Mode» — шаги через UI (vSphere 7.0 U3o / 8.0 U2 и новее: Configure → vSphere Cluster Services → General → EDIT VCLS MODE) и через advanced setting config.vcls.clusters.domain-c<номер>.enabled = False; предупреждение о запуске vpxd при неверном значении и команда чистки секции vcls в /etc/vmware-vpx/vpxd.cfg. https://knowledge.broadcom.com/external/article/316514/disable-vcls-on-a-cluster-via-retreat-mo.html
- StarWind Blog — «VMware Cloud Foundation 9: Deprecated Features in vSphere & NSX» — список устаревших функций vSphere 9.0 (Auto Deploy, Host Profiles, Image Builder, vVols, Enhanced Linked Mode, vCLS, SIOC, vLCM Baselines, IWA) и пояснение про распределённое встроенное хранилище состояния кластера на хостах ESX 9. https://www.starwindsoftware.com/blog/vcf9-deprecated-vsphere-nsx/
- Broadcom Developer Portal — VCF PowerCLI — Актуальная линейка VCF PowerCLI 9.1 (2026), командлеты Get-AdvancedSetting / New-AdvancedSetting / Set-AdvancedSetting для работы с продвинутыми настройками vCenter. https://developer.broadcom.com/powercli
- Broadcom TechDocs — Embedded vCLS (vSphere 9.0) — vSphere Resource Management → vSphere Cluster Services → Embedded vCLS: ВМ на vSphere Pod, два экземпляра на кластер против трёх у External vCLS, признак vCLSCRX.agent, поведение при выключении и эвакуации хоста, Retreat Mode. https://techdocs.broadcom.com/us/en/vmware-cis/vsphere/vsphere/9-0/vsphere-resource-management/vsphere-cluster-services-vcls/embedded-vcls.html
- VMware Cloud Foundation Blog — Embedded vSphere Cluster Services Deep Dive — 17.07.2024: требования (vCenter и ESXi 8.0 U3+), 1 vCPU / 160 МБ с резервом, статический образ и ramdisk без datastore, откат на External vCLS в смешанных кластерах, отказ от бэкапа vCLS. https://blogs.vmware.com/cloud-foundation/2024/07/17/embedded-vsphere-cluster-services-deep-dive/