
Включили Optimized Locking — и параллельные UPDATE стали давать другой результат
Вы мигрировали базу на SQL Server 2025, включили Accelerated Database Recovery и Optimized Locking, порадовались упавшим ожиданиям на блокировках — а через неделю бухгалтерия говорит, что часть документов «не провелась», и в логах приложения при этом ни одной ошибки. Никаких дедлоков, никаких таймаутов, просто другой набор обработанных строк. Виноват не баг, а компонент Optimized Locking под названием Lock After Qualification: он проверяет условие UPDATE по последней зафиксированной версии строки ещё до взятия блокировки и молча проходит мимо той строки, которую прямо сейчас меняет соседняя транзакция. Ниже — что именно ломается, как это выглядит на живом стенде, как доказать вину LAQ по расширенным событиям и какими четырьмя способами это лечится, не выключая всю оптимизацию целиком.
Тихая потеря заданий: как это выглядит из окопа
Самый неприятный класс проблем — тот, где нет ошибки. Приложение отработало, транзакция закоммитилась, метрики зелёные, а данные не те. Именно так выглядит переезд очереди заданий или конечного автомата статусов на базу с включённым Optimized Locking. Разработчик писал код в предположении, что второй UPDATE подождёт первый, увидит уже изменённое значение и отработает по нему. Пятнадцать лет это предположение исполнялось само собой — не потому что так гарантировано стандартом, а потому что движок брал U-блокировку на строке при проверке предиката, и вторая сессия честно висела в очереди.
В SQL Server 2025 (17.x) появилась возможность включить оптимизированные блокировки, и вот эта неявная зависимость отваливается. Условие WHERE проверяется без блокировки, по последней зафиксированной версии строки. Если строка под условие не подходит — сессия идёт дальше по скану и даже не узнает, что рядом кто-то её прямо сейчас доводит до нужного состояния. Никакого ожидания, никакой ошибки, ноль затронутых строк.
Дальше срабатывает вторая мина, уже в коде приложения. Практически в каждой самописной очереди есть строчка вида «если @@ROWCOUNT = 0, значит задание уже забрал другой воркер — снимаем его с обработки». Раньше нулевой rowcount действительно означал «кто-то опередил и довёл до конца». Теперь он означает ещё и «кто-то в этот момент только начал, и я решил не ждать». Задание выкидывается из обработки в состоянии, из которого оно уже никогда не выйдет.
Скажу прямо: это не поломка движка и не регрессия, которую починят кумулятивным обновлением. Microsoft прямым текстом пишет, что при изоляции с версионированием строк приложение вообще не должно рассчитывать на строгий порядок транзакций без явных хинтов. Просто до 2025-й наша неправильная вера в порядок работала.
- Ошибок в логах нет — операция завершается успешно, но с другим набором строк
- Счётчики обработанных документов расходятся с числом входящих на доли процента
- Ожидания LCK_M_U и лок-эскалации при этом действительно упали — оптимизация работает как обещано
- Воспроизводится нестабильно: ниже расскажу, почему один и тот же скрипт то ловит эффект, то нет
Что вы включаете на самом деле: TID-блокировки, LAQ и три обязательных условия
Optimized locking состоит из двух разных механизмов, и путать их нельзя, потому что ломает семантику только один из них. Первый — TID locking, блокировка по идентификатору транзакции. Каждая строка внутри штампуется идентификатором последней изменившей её транзакции; вместо тысячи X-блокировок на ключах до конца транзакции держится одна X-блокировка на ресурсе XACT, а построчные и постраничные блокировки снимаются сразу после изменения строки. Это чистая экономия: меньше памяти под блокировки, практически нет эскалации, меньше дедлоков. Семантику TID-блокировки не меняют.
Второй механизм — Lock After Qualification, LAQ. Он надстроен над TID и меняет порядок действий при DML. Без него движок сначала берёт U-блокировку на строке, потом проверяет предикат, и если тот выполнился — конвертирует блокировку в X и держит её до конца транзакции. С LAQ предикат проверяется оптимистично, по последней зафиксированной версии строки, вообще без блокировок; X-блокировка берётся только на подошедшую строку и снимается сразу после изменения, не дожидаясь коммита. Отсюда и рост параллельности — и отсюда же изменение поведения.
Жёстких требований два, плюс одна особенность, о которой забывают. Optimized locking включается только на базе, где уже включён Accelerated Database Recovery. Компонент LAQ работает только при включённом READ_COMMITTED_SNAPSHOT и только на уровне изоляции READ COMMITTED — без RCSI вы получите одни TID-блокировки. А особенность в том, что в SQL Server 2025 всё это по умолчанию выключено и включается на уровне отдельной базы, в отличие от Azure SQL Database, SQL database в Microsoft Fabric и Azure SQL Managed Instance с политиками обновления Always-up-to-date и SQL Server 2025, где оптимизированные блокировки включены всегда. Это отдельный повод для внимания при переносе базы из Azure на локальный сервер и обратно: поведение конкурентных UPDATE может отличаться между средами.
Порядок включения такой (все три команды требуют, чтобы к базе не было других активных подключений, кроме вашего — отсюда ROLLBACK IMMEDIATE; переводить базу в single-user режим при этом не нужно):
ALTER DATABASE optika_orders SET ACCELERATED_DATABASE_RECOVERY = ON WITH ROLLBACK IMMEDIATE;
ALTER DATABASE optika_orders SET READ_COMMITTED_SNAPSHOT ON WITH ROLLBACK IMMEDIATE;
ALTER DATABASE optika_orders SET OPTIMIZED_LOCKING = ON WITH ROLLBACK IMMEDIATE;
Проверка текущего состояния — одним запросом, я держу его в закладках SSMS и прогоняю на каждой базе перед разбором любого «странного» инцидента:
SELECT database_id, name,
       is_accelerated_database_recovery_on,
       is_read_committed_snapshot_on,
       is_optimized_locking_on
FROM sys.databases
WHERE name = DB_NAME();
И короткий вариант для скриптов: SELECT DATABASEPROPERTYEX(DB_NAME(), 'IsOptimizedLockingOn'); — вернёт 1, 0 или NULL, если на этой платформе фича вообще недоступна.
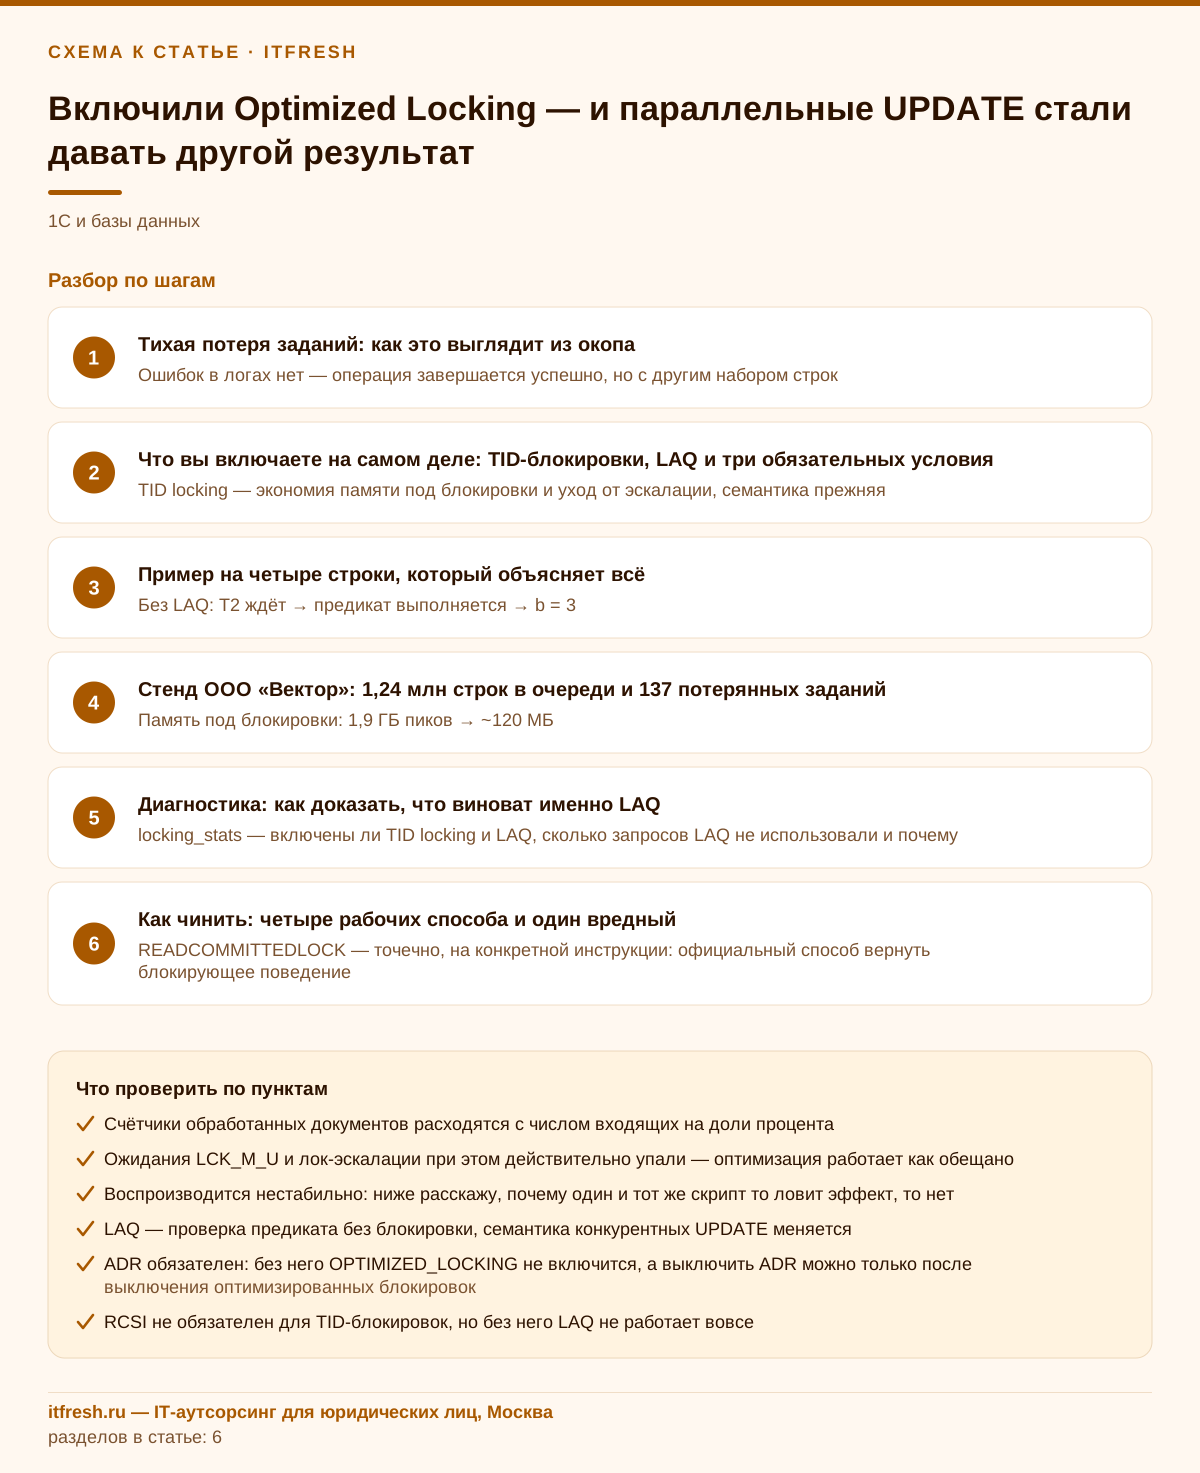
- TID locking — экономия памяти под блокировки и уход от эскалации, семантика прежняя
- LAQ — проверка предиката без блокировки, семантика конкурентных UPDATE меняется
- ADR обязателен: без него OPTIMIZED_LOCKING не включится, а выключить ADR можно только после выключения оптимизированных блокировок
- RCSI не обязателен для TID-блокировок, но без него LAQ не работает вовсе
Пример на четыре строки, который объясняет всё
Microsoft приводит в документации предельно честный пример, и я советую прогнать его руками на тестовой базе прежде, чем принимать решение по проду. Таблица из двух колонок и одной строки:
CREATE TABLE t4 (a int NOT NULL, b int NULL);
INSERT INTO t4 VALUES (1, 1);
Дальше две сессии. Первая: BEGIN TRANSACTION T1; UPDATE t4 SET b = 2 WHERE a = 1; — и транзакция остаётся открытой. Вторая: BEGIN TRANSACTION T2; UPDATE t4 SET b = 3 WHERE b = 2;. Потом коммитим первую, потом вторую.
Без LAQ вторая транзакция блокируется и ждёт первую. Как только T1 закоммитилась, T2 видит b = 2, предикат выполняется, строка обновляется. В таблице остаётся a = 1, b = 3. Именно на это поведение опирается 90 % самописных конечных автоматов: «дождись предыдущего шага и продолжи с того места».
С LAQ вторая транзакция берёт последнюю зафиксированную версию строки, а там ещё b = 1. Предикат b = 2 не выполняется, строка пропускается, оператор завершается мгновенно и без единой блокировки. В таблице остаётся a = 1, b = 2. Разный итог данных при одном и том же тексте запросов и одном и том же порядке команд — вот вся суть проблемы на четырёх строках кода.
Отдельно про требалификацию, потому что её часто понимают наоборот. Движок действительно перепроверяет предикат — но только для строки, которая уже прошла квалификацию, и если строку успела изменить другая транзакция. То есть повторная проверка спасает от записи по устаревшим данным в подошедшей строке, но она принципиально не возвращает строку, которая под условие не подошла с первого раза. Пропущенная строка пропущена окончательно. Более того, если план запроса использует оператор, который требалификацию не поддерживает, движок внутренне прерывает выполнение оператора и перезапускает его уже без LAQ — при этом срабатывает расширенное событие lock_after_qual_stmt_abort.
- Без LAQ: T2 ждёт → предикат выполняется → b = 3
- С LAQ: T2 читает последнюю зафиксированную версию → предикат не выполняется → b = 2, ноль затронутых строк
- Требалификация перепроверяет только подошедшие строки, не подошедшие она не «догоняет»
Стенд салона оптики «Зоркий глаз»: очередь заказов в мастерскую и 137 потерянных заданий
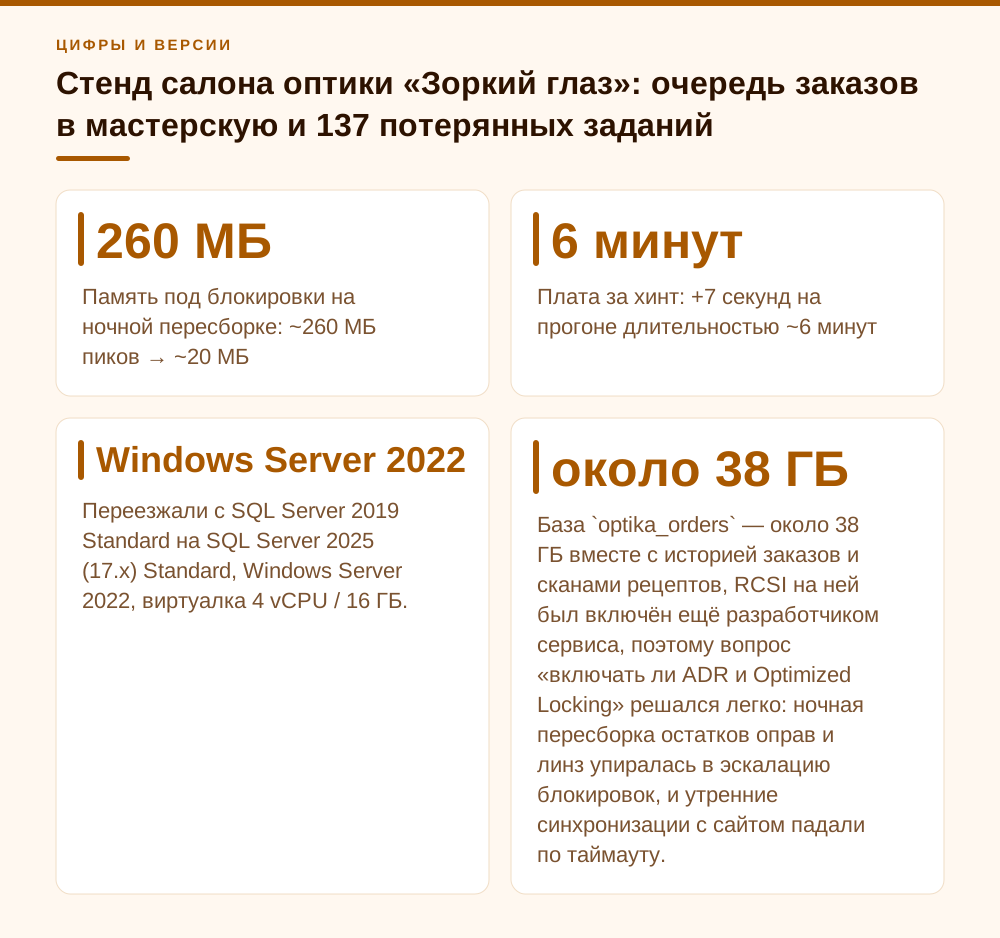
Разбор из практики. Салон оптики «Зоркий глаз», 11 рабочих мест: консультанты в зале, оптометрист, мастер по сборке очков и бухгалтер. Помимо 1С у салона есть самописный сервис заказов поверх SQL Server — заказ на линзы и сборку очков проходит путь от приёма в зале до выдачи клиенту, параллельно синхронизируется с сайтом и с поставщиком линз. Переезжали с SQL Server 2019 Standard на SQL Server 2025 (17.x) Standard, Windows Server 2022, виртуалка 4 vCPU / 16 ГБ. База optika_orders — около 38 ГБ вместе с историей заказов и сканами рецептов, RCSI на ней был включён ещё разработчиком сервиса, поэтому вопрос «включать ли ADR и Optimized Locking» решался легко: ночная пересборка остатков оправ и линз упиралась в эскалацию блокировок, и утренние синхронизации с сайтом падали по таймауту.
Включили ADR (PVS оставили на PRIMARY — отдельная файловая группа под версии на таком объёме не нужна), затем OPTIMIZED_LOCKING = ON. Эффект по метрикам был ровно тот, за которым шли: пиковое потребление памяти под блокировки на ночной пересборке упало примерно с 260 МБ до 20 МБ, ожидания LCK_M_U в этом окне ушли практически в ноль, лок-эскалаций на таблице остатков за неделю — ноль вместо 10–15 за ночь. Ночной регламент стал укладываться в окно примерно на 18 % быстрее. Пока всё прекрасно.
Через шесть дней администратор салона заметила, что несколько готовых заказов не ушли клиентам в SMS «очки готовы», а бухгалтер — что они не выгрузились в 1С. Таблица dbo.job_queue, около 90 тысяч строк за три года, статусы 0 (новое) → 1 (взято) → 2 (готово к выгрузке) → 3 (выгружено и отправлено уведомление), три фоновых воркера на .NET в бесконечном цикле. Воркер, который переводит 2 → 3, делал так:
UPDATE dbo.job_queue
   SET status = 3, done_at = SYSUTCDATETIME()
 WHERE job_id = @id AND status = 2;
-- в коде: if (rowsAffected == 0) { MarkHandledByPeer(id); return; }
Строка MarkHandledByPeer и есть та самая мина. Раньше при нулевом rowcount задание действительно было уже проведено другим воркером. Теперь ноль возвращался и в ситуации, когда воркер, переводящий 1 → 2, ещё держал транзакцию открытой: LAQ проверял status = 2 по последней зафиксированной версии, видел там 1, строку пропускал.
Замерили честно. Синтетический прогон на копии базы: 20 000 заданий (это больше, чем салон набирает за полгода), три воркера, средняя длительность транзакции этапа 1 → 2 около 40 мс. С LAQ 137 заданий (0,69 %) уехали в «обработано соседом», не будучи обработанными вообще. После того как в этот один запрос добавили хинт READCOMMITTEDLOCK, повторный прогон дал ровно ноль потерь при том же профиле нагрузки и практически той же длительности прогона — 6 минут 12 секунд против 6 минут 05 секунд. То есть цена локальной защиты — семь секунд на двадцати тысячах заданий, а не откат всей оптимизации на всей базе.
- Память под блокировки на ночной пересборке: ~260 МБ пиков → ~20 МБ
- LCK_M_U в окне ночного регламента: заметные ожидания → околонулевые значения
- Лок-эскалации на таблице остатков: 10–15 за ночь → 0
- Потери в очереди до правки: 137 из 20 000 заданий; после хинта на одном запросе — 0
- Плата за хинт: +7 секунд на прогоне длительностью ~6 минут
Диагностика: как доказать, что виноват именно LAQ
Первое, что нужно понять: обычными средствами вы этого не увидите. Нет ошибки, нет дедлока, нет длинного ожидания — наоборот, ожидания исчезли. Поэтому диагностика строится не на поиске проблем, а на подтверждении гипотезы: «в момент X оператор отработал без блокировки и вернул ноль строк».
Штатный инструмент — расширенные события. Событие locking_stats срабатывает по каждой базе раз в несколько минут и отдаёт агрегированную статистику: сколько было эскалаций, включены ли компоненты TID locking и LAQ, и сколько запросов не использовали LAQ и по каким причинам. Именно последняя часть отвечает на вопрос «а вообще работает ли у меня LAQ на этой инструкции». Событие locking_stats2 (есть в SQL Server и Azure SQL Managed Instance) добавляет статистику по skip index locks и по эвристикам LAQ. Событие lock_after_qual_stmt_abort срабатывает при внутреннем перезапуске оператора из-за конфликта с другой транзакцией — на нашем стенде за десять минут нагрузки оно отработало 4 812 раз, и это было первым внятным сигналом, что LAQ действительно активен именно на этом коде.
CREATE EVENT SESSION [laq_watch] ON SERVER
ADD EVENT sqlserver.lock_after_qual_stmt_abort,
ADD EVENT sqlserver.locking_stats,
ADD EVENT sqlserver.locking_stats2
ADD TARGET package0.event_file (SET filename = N'C:\xe\laq_watch.xel', max_file_size = 64)
WITH (MAX_MEMORY = 8MB, EVENT_RETENTION_MODE = ALLOW_SINGLE_EVENT_LOSS, STARTUP_STATE = ON);
GO
ALTER EVENT SESSION [laq_watch] ON SERVER STATE = START;
Второе место — блокировки в динамических представлениях. При включённых оптимизированных блокировках в sys.dm_tran_locks вы увидите ресурс типа XACT вместо привычной россыпи KEY и PAGE: на пишущей транзакции ровно одна X-блокировка на XACT. Ожидания тоже переименовались — вместо LCK_M_U и LCK_M_X появляются LCK_M_S_XACT_READ (ждём с намерением прочитать) и LCK_M_S_XACT_MODIFY (ждём с намерением изменить). Если вы поддерживаете свой мониторинг блокировок с фильтром по типам ожиданий, его надо править: старые правила при OPTIMIZED_LOCKING = ON просто перестанут срабатывать, и вам покажется, что блокировок в базе не осталось. В графе дедлоков появился элемент <xactlock>, раскрывающий, какие реальные ресурсы стоят за блокировкой TID, — без него разбор дедлока на 2025 превращается в гадание.
Третье — Query Store. Движок ведёт обратную связь по LAQ на уровне плана запроса, и найти планы, где LAQ был выключен эвристикой, можно в sys.query_store_plan_feedback: у таких записей feature_id = 4 и feature_desc = 'LAQ Feedback'. Эта же обратная связь переживает перезапуск базы, если запрос попал в Query Store. Отсюда следует практический вывод, который сбивает с толку половину тех, кто пытается воспроизвести проблему на тесте: на одном и том же сервере один и тот же запрос может выполниться и с LAQ, и без него.
SELECT plan_id, feature_id, feature_desc, state_desc, create_time
FROM sys.query_store_plan_feedback
WHERE feature_desc = 'LAQ Feedback'
ORDER BY create_time DESC;- locking_stats — включены ли TID locking и LAQ, сколько запросов LAQ не использовали и почему
- locking_stats2 — статистика skip index locks и эвристик LAQ
- lock_after_qual_stmt_abort — внутренний перезапуск оператора из-за конфликта
- sys.dm_tran_locks: ресурс XACT; ожидания LCK_M_S_XACT_READ / LCK_M_S_XACT_MODIFY
- sys.query_store_plan_feedback: feature_id = 4, 'LAQ Feedback'
Как чинить: четыре рабочих способа и один вредный
Способ первый и основной — хинт READCOMMITTEDLOCK на той таблице, где нужен старый блокирующий порядок. Это официально рекомендованный Microsoft ответ на вопрос «как заставить запросы блокироваться, несмотря на оптимизированные блокировки», и работает он именно при включённом RCSI. LAQ на такой инструкции не применяется, поведение возвращается к дособытийному: движок берёт U-блокировку, ждёт соседнюю транзакцию, перепроверяет предикат уже по её результату.
UPDATE q
   SET status = 3, done_at = SYSUTCDATETIME()
  FROM dbo.job_queue AS q WITH (READCOMMITTEDLOCK)
 WHERE q.job_id = @id AND q.status = 2;
Важный нюанс: хинт на одной таблице не отключает оптимизированные блокировки для остальных таблиц того же запроса, и не влияет на другие запросы к этой же таблице. Это не рубильник, это скальпель — за что я его и люблю.
Способ второй — переписать предикат так, чтобы он не зависел от колонки, которую параллельно меняет другая транзакция. Если условие стоит на первичном ключе, а изменяемая колонка в WHERE не участвует, LAQ ничего не ломает: строка квалифицируется по стабильному значению. В сервисе заказов салона часть переходов мы так и переделали: вместо WHERE status = 2 берём пачку job_id отдельным запросом, а UPDATE выполняем по ключам с проверкой rowversion. Дольше по коду, зато поведение перестаёт зависеть от настроек базы.
Способ третий — классический паттерн очереди с WITH (UPDLOCK, READPAST). Он и раньше был правильным способом разбирать очередь несколькими воркерами, а теперь получил бонус: UPDLOCK входит в список конфликтующих хинтов, при которых LAQ не применяется, а READPAST заставляет пропускать занятые строки явно и предсказуемо, а не по стечению обстоятельств. Способ четвёртый — более строгий уровень изоляции, REPEATABLE READ или SERIALIZABLE на конкретной транзакции; это официальная рекомендация для нагрузок, завязанных на строгий порядок, но цена в параллельности выше, чем у точечного хинта, поэтому я его держу как запасной.
А теперь вредный способ, который встречается чаще всех перечисленных: навесить READCOMMITTEDLOCK или UPDLOCK на все запросы через шаблон в ORM или через план-гайд. Смысл включения оптимизированных блокировок при этом теряется полностью — locking-хинты заставляют движок брать построчные и постраничные блокировки и держать их до конца транзакции, ровно как раньше. Вы получите старую производительность, но уже с накладными расходами ADR и версионного хранилища. Если после аудита выяснилось, что хинты нужны почти везде, — честнее выключить OPTIMIZED_LOCKING на базе и вернуться к вопросу после рефакторинга приложения.
- READCOMMITTEDLOCK — точечно, на конкретной инструкции: официальный способ вернуть блокирующее поведение
- Предикат по стабильному ключу + rowversion — самое устойчивое решение, но требует правок в коде
- UPDLOCK + READPAST — правильный паттерн разбора очереди, попутно отключает LAQ на инструкции
- REPEATABLE READ / SERIALIZABLE — рекомендация Microsoft для нагрузок со строгим порядком, дороже по параллельности
- Глобальные хинты через ORM — так делать не надо: убивает всю выгоду и добавляет накладные расходы
Где LAQ не работает вовсе, почему он не воспроизводится и как внедрять
Половина писем в духе «мы прогнали ваш сценарий, у нас всё как раньше» объясняется тем, что LAQ в этом сценарии просто не применялся. Список случаев, когда он выключается, довольно длинный, и его стоит знать наизусть — он же служит подсказкой при разборе инцидента: если ваш проблемный запрос попадает в список, ищите причину в другом месте. Отдельно отмечу самый частый пункт для очередей: если у инструкции есть предложение OUTPUT, вставляющее данные в табличную переменную или возвращающее результирующий набор, LAQ не используется. То есть классический паттерн UPDATE TOP (1) ... SET status = 1 OUTPUT inserted.job_id ... WHERE status = 0 от этой проблемы защищён по построению. Хорошая новость для тех, кто писал очередь по канону.
Второй источник «невоспроизводимости» — эвристики. Движок ведёт обратную связь: измеряет в логических чтениях объём потенциально впустую сделанной работы и долю перезапущенных операторов, и если пороги превышены — LAQ отключается автоматически, для конкретного плана запроса или для всей базы. Когда показатели возвращаются в норму, LAQ включается обратно. Обратная связь по плану живёт в Query Store и переживает перезапуск базы, а обратная связь уровня базы пересобирается после каждого старта. Практический вывод: не пытайтесь воспроизвести эффект на «прогретой» базе, где нагрузка уже успела отключить LAQ. Тест делайте на свежем экземпляре и обязательно проверяйте через locking_stats, что LAQ реально включён.
Теперь про порядок внедрения, раз уж мы дошли до конца. Я не отговариваю от Optimized Locking — на массовых UPDATE выигрыш реальный и измеримый. Я отговариваю включать его в пятницу вечером одной командой на боевой базе. Мой чек-лист: сначала аудит кода — грепом по репозиторию ищем UPDATE и DELETE, у которых в WHERE стоит колонка, изменяемая другими транзакциями (статусы, флаги, признаки занятости, остатки), и отдельно места, где нулевой rowcount трактуется как бизнес-решение; в сервисе заказов «Зоркого глаза» таких нашлось четыре инструкции на примерно шесть тысяч строк кода. Потом стенд с копией прода, сессия расширенных событий и нагрузка реальным профилем, а не синтетикой на трёх строках, с проверкой бизнес-инвариантов, а не только времени выполнения. Потом точечные хинты и повторный прогон. И только потом прод — с включённым Query Store и обновлёнными правилами мониторинга под ожидания XACT. Про откат помните главное: сначала OPTIMIZED_LOCKING = OFF, только потом ADR, обратный порядок движок не пропустит.
Отдельно про 1С, потому что в небольших компаниях на том же SQL Server почти всегда крутится ещё и бухгалтерия. Запросы платформы 1С вы не правите, хинты в них не расставите, а управление блокировками платформа частично берёт на себя. Поэтому для баз 1С порядок у меня простой: проверить, какие версии SQL Server заявлены вендором как поддерживаемые для вашей версии платформы, посмотреть в sys.databases фактическое состояние READ_COMMITTED_SNAPSHOT и ADR, и не включать OPTIMIZED_LOCKING на рабочей базе 1С без прогона типовых регламентов (закрытие месяца, проведение документов пакетом, обмены) на копии. Базу самописного сервиса и базу 1С на одном экземпляре можно и нужно настраивать по-разному — опция задаётся на уровне базы, а не сервера.
И про честность формулировок. Единого мнения в сообществе по поводу «включать ли по умолчанию» пока нет: в Azure SQL Database выбора вообще не дают, и весь мир там живёт с LAQ давно и без катастроф, а на локальных серверах Microsoft осознанно оставила фичу выключенной именно из-за таких изменений поведения. Моя позиция: включать стоит, но только после аудита кода и только на базах, где вы контролируете приложение. Для покупных систем, где вы не можете поправить ни одного запроса, я оставляю OPTIMIZED_LOCKING выключенным, пока вендор явно не подтвердит поддержку.
- LAQ отключён эвристиками по плану запроса или по базе
- Использованы конфликтующие хинты: UPDLOCK, READCOMMITTEDLOCK, XLOCK, HOLDLOCK
- Уровень изоляции отличен от READ COMMITTED либо READ_COMMITTED_SNAPSHOT выключен
- У изменяемой таблицы есть columnstore-индекс
- В инструкции DML есть присваивание переменной
- Есть предложение OUTPUT во временную табличную переменную или в результирующий набор
- Инструкция читает изменяемые строки более чем одним оператором поиска или сканирования по индексу
- Это инструкция MERGE
- Изменения в tempdb и во временных таблицах — оптимизированные блокировки там пока не применяются
- Чек-лист внедрения: аудит кода → стенд с копией прода и xEvents → точечные хинты → прод с Query Store и обновлённым мониторингом
- Порядок отката: сначала OPTIMIZED_LOCKING = OFF, только потом ADR
Частые вопросы
Нужно ли включать Optimized Locking сразу после переезда на SQL Server 2025?
Нет, и торопиться не надо. В SQL Server 2025 (17.x) оптимизированные блокировки по умолчанию выключены, и это осознанное решение Microsoft именно из-за изменения поведения конкурентных UPDATE. Сначала аудит кода на предикаты по изменяемым колонкам и на трактовку нулевого @@ROWCOUNT, потом стенд с нагрузкой, и только потом прод.
Как быстро проверить, включён ли LAQ на моей базе?
Одним запросом: SELECT database_id, name, is_accelerated_database_recovery_on, is_read_committed_snapshot_on, is_optimized_locking_on FROM sys.databases WHERE name = DB_NAME(). LAQ активен только если включены все три: ADR, RCSI и OPTIMIZED_LOCKING, и при этом транзакция выполняется на уровне изоляции READ COMMITTED. Дополнительно фактическое состояние компонентов показывает расширенное событие locking_stats.
Затронет ли это базы 1С?
Зависит от состояния READ_COMMITTED_SNAPSHOT на конкретной базе, и гадать тут нельзя: у баз 1С 8.3 на MS SQL RCSI нередко включён. Если RCSI выключен, OPTIMIZED_LOCKING даст только TID-блокировки — меньше памяти под блокировки и меньше эскалаций без изменения семантики. Если включён — активируется и LAQ, а запросы платформы вы править не можете. Поэтому сначала запрос к sys.databases, проверка поддержки SQL Server 2025 вашей версией платформы у вендора и прогон регламентов на копии базы, и только потом решение по боевой.
Спасёт ли переход на SERIALIZABLE?
Да, но это тяжёлое лекарство. LAQ не применяется на любом уровне изоляции, отличном от READ COMMITTED, поэтому REPEATABLE READ и SERIALIZABLE возвращают блокирующее поведение — это официальная рекомендация Microsoft для нагрузок, зависящих от строгого порядка транзакций. Только цена в параллельности выше, чем у точечного хинта READCOMMITTEDLOCK на одной инструкции.
А MERGE и OUTPUT затронуты?
Нет. LAQ не используется в инструкциях MERGE, а также если в DML есть предложение OUTPUT, вставляющее данные в табличную переменную или возвращающее результирующий набор, и если в инструкции есть присваивание переменной. Классический паттерн разбора очереди через UPDATE ... OUTPUT inserted.id от этой проблемы защищён по построению.
Можно ли просто выключить обратно, если что-то пошло не так?
Можно, но помните порядок: сначала ALTER DATABASE ... SET OPTIMIZED_LOCKING = OFF, и только затем при необходимости выключается ADR — обратный порядок движок не пропустит. Обе команды требуют, чтобы к базе не было других активных подключений, кроме выполняющего, поэтому планируйте окно и добавляйте WITH ROLLBACK IMMEDIATE.
Источники
- Microsoft Learn — Optimized locking — Раздел «Lock after qualification (LAQ)», «LAQ limitations», «Query behavior changes with optimized locking and RCSI», FAQ по READCOMMITTEDLOCK. SQL Server 2025 (17.x). https://learn.microsoft.com/en-us/sql/relational-databases/performance/optimized-locking?view=sql-server-ver17
- Microsoft Learn — ALTER DATABASE SET Options (Transact-SQL) — Параметры OPTIMIZED_LOCKING { ON | OFF } (SQL Server 2025 и выше, по умолчанию OFF), ACCELERATED_DATABASE_RECOVERY = { ON | OFF }, READ_COMMITTED_SNAPSHOT { ON | OFF }; требование отсутствия других активных подключений. https://learn.microsoft.com/en-us/sql/t-sql/statements/alter-database-transact-sql-set-options?view=sql-server-ver17
- Microsoft Learn — Accelerated database recovery management — Включение ADR, размещение Persistent Version Store, влияние на базу; ADR — обязательное условие для OPTIMIZED_LOCKING. https://learn.microsoft.com/en-us/sql/relational-databases/accelerated-database-recovery-management?view=sql-server-ver17
- Microsoft Learn — Deadlocks guide — Раздел «Optimized locking and deadlocks»: элемент <xactlock> в отчёте о дедлоке при включённых оптимизированных блокировках. https://learn.microsoft.com/en-us/sql/relational-databases/sql-server-deadlocks-guide?view=sql-server-ver17
- Microsoft Learn — sys.dm_os_wait_stats — Типы ожиданий LCK_M_S_XACT_READ / LCK_M_S_XACT_MODIFY / LCK_M_S_XACT при включённых оптимизированных блокировках. https://learn.microsoft.com/en-us/sql/relational-databases/system-dynamic-management-views/sys-dm-os-wait-stats-transact-sql?view=sql-server-ver17