
Обновил образ до postgres:18 — база создаётся заново, хотя старый том на месте
Вы поменяли в docker-compose.yml тег postgres:16 на postgres:18, контейнер поднялся, приложение отрапортовало «база пустая, накатываю миграции». Том на месте, docker volume ls его показывает, размер прежний — а данных нет. Это не баг вашего приложения и не порча тома. В восемнадцатом образе поменялись PGDATA и объявленный VOLUME, и ваше старое монтирование теперь указывает мимо каталога данных. Ниже — что именно изменилось и почему, как за минуту понять, в каком из трёх сценариев вы находитесь, как вытащить данные из анонимного тома, если контейнер уже пересоздали, и как правильно готовить переход с 17-й версии, чтобы потом сработал быстрый pg_upgrade --link и не споткнуться о контрольные суммы, которые initdb 18 включает по умолчанию.
Что поменялось в образе: две строки Dockerfile, ломающие привычку
Начну с фактуры, потому что дальше всё крутится вокруг неё. Официальный образ postgres до 17-й версии включительно объявляет каталог данных прямо в корне тома: PGDATA равен /var/lib/postgresql/data, и VOLUME объявлен на тот же путь. Все compose-файлы последних десяти лет написаны под это: монтируем именованный том на /var/lib/postgresql/data и живём спокойно. В 18-й версии обе строки изменились.
# 17/trixie/Dockerfile
ENV PG_MAJOR 17
ENV PGDATA /var/lib/postgresql/data
VOLUME /var/lib/postgresql/data

# 18/trixie/Dockerfile — на момент написания PG_VERSION 18.6-1.pgdg13+2
# NOTE: in 18+, PGDATA has changed to match the pg_ctlcluster standard
#       directory structure, and the VOLUME has moved from
#       /var/lib/postgresql/data to /var/lib/postgresql
ENV PG_MAJOR 18
ENV PGDATA /var/lib/postgresql/18/docker
VOLUME /var/lib/postgresql
Сделано это осознанно, в pull request №1259 репозитория docker-library/postgres, влитом 5 июня 2025 года. Мотив честный и технически правильный: pg_upgrade с ключом --link требует, чтобы старый и новый каталоги данных лежали в пределах одной точки монтирования — иначе жёсткие ссылки между ними просто не создаются. При старой раскладке каталог данных был корнем тома, и уложить рядом два кластера разных мажорных версий было невозможно без плясок с двумя томами и ручными пробросами. Теперь том монтируется на /var/lib/postgresql, а внутри лежат подкаталоги вида 18/docker, 19/docker — ровно как это делает pg_ctlcluster в Debian и Ubuntu. То есть образ наконец стал похож на нормальную пакетную установку PostgreSQL.
И сразу важная оговорка, которую я слышу как вопрос от каждого второго: это изменение самого образа, а не PostgreSQL 18. Если вы ставите восемнадцатую версию пакетами на голый Debian, PGDATA у вас будет там же, где и был — /var/lib/postgresql/18/main. Никакой каталог docker в мире вне Docker Official Image не появляется. Не переносите этот путь в свои bare-metal инструкции и не ищите его в документации PostgreSQL — его там нет.
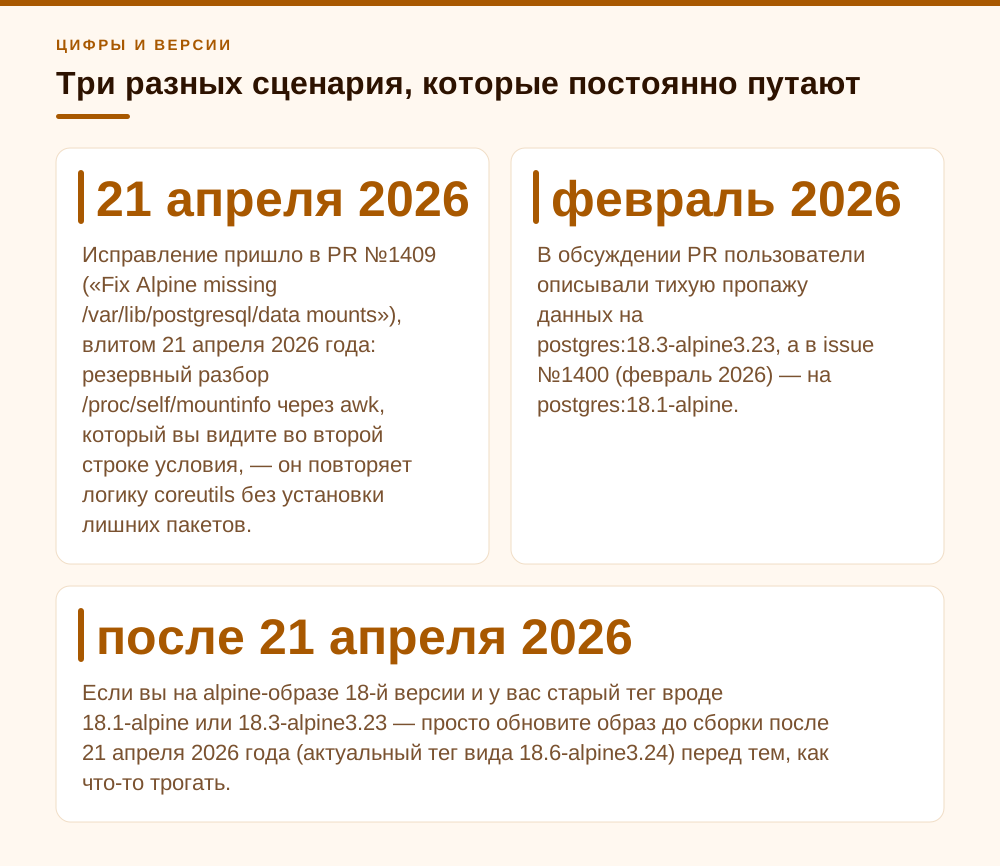
- postgres:17 и старше — PGDATA=/var/lib/postgresql/data, VOLUME=/var/lib/postgresql/data.
- postgres:18 и новее — PGDATA=/var/lib/postgresql/18/docker, VOLUME=/var/lib/postgresql.
- postgres:19 в своё время будет /var/lib/postgresql/19/docker — схема с номером мажорной версии закреплена, а не одноразовая.
- На bare-metal PostgreSQL 18 ничего не поменялось: Debian/Ubuntu по-прежнему кладут кластер в /var/lib/postgresql/18/main.
Механика: откуда берётся анонимный том и почему ваш именованный не при делах
Дальше чистая механика Docker, без магии. Инструкция VOLUME в Dockerfile означает: если при запуске контейнера на этот путь ничего не смонтировано явно, Docker сам создаст анонимный том, смонтирует его туда и скопирует внутрь содержимое каталога из образа. Анонимный — значит с именем в виде шестидесяти четырёх шестнадцатеричных символов, без метки, без принадлежности к compose-проекту.
Теперь наложите на это ваш старый compose. Вы монтируете именованный том pgdata на /var/lib/postgresql/data. Образ объявляет VOLUME на /var/lib/postgresql — путь уровнем выше, и на нём у вас ничего не смонтировано. Docker послушно создаёт анонимный том и вешает его на /var/lib/postgresql, а ваш pgdata монтируется поверх, во вложенный каталог data. Внутри контейнера получается вот такая картинка: каталог /var/lib/postgresql — анонимный том, /var/lib/postgresql/data — ваш именованный том, а PGDATA указывает на /var/lib/postgresql/18/docker, то есть в анонимный. Ваш том формально смонтирован, физически цел, размер прежний — и полностью не при делах.
Пока контейнер жив, всё работает: база пишется, приложение довольно. Важная деталь, которую часто упускают: docker compose up -d при пересоздании контейнера (сменили переменную окружения, обновили образ) по умолчанию переносит анонимные тома из предыдущего контейнера — в документации Compose ключ -V/--renew-anon-volumes описан именно как «пересоздать анонимные тома вместо того, чтобы брать данные из предыдущих контейнеров». Поэтому ловушка часто молчит неделями. Беда приходит, когда старого контейнера уже нет: docker compose down и затем up -d, docker rm плюс docker run, up -V, redeploy в CI через down/up, пересоздание стека из Portainer. Новый контейнер получает новый пустой анонимный том, entrypoint не находит в нём PG_VERSION и запускает initdb. Приложение видит чистую базу и радостно накатывает миграции с нуля. Старый анонимный том при этом остаётся висеть без владельца — и если где-то в конвейере есть docker volume prune (с Docker 23 он по умолчанию удаляет как раз неиспользуемые анонимные тома) или docker compose down -v (сносит и именованные тома проекта, и анонимные тома контейнеров), данных больше нет вообще.
Диагностика занимает три команды. Первая показывает, сколько на самом деле томов у контейнера и куда они смонтированы; вторая — куда реально смотрит PGDATA; третья — какие анонимные тома болтаются без дела.
# 1. все монтирования контейнера: имя тома -> точка внутри
docker inspect pg --format '{{range .Mounts}}{{.Type}} {{.Name}}{{.Source}} -> {{.Destination}}{{"\n"}}{{end}}'

# 2. фактический PGDATA и есть ли там кластер
docker exec pg sh -c 'echo "PGDATA=$PGDATA"; ls -la "$PGDATA" | head'
docker exec pg sh -c 'cat "$PGDATA/PG_VERSION"'

# 3. висячие тома — кандидаты в потеряшки
docker volume ls -qf dangling=true
Признак, по которому я опознаю проблему мгновенно: в выводе первой команды у контейнера с базой два тома вместо одного, и один из них — безымянный хеш на /var/lib/postgresql. Если видите такое — вы уже в этой истории, просто ещё не пересоздавали контейнер.
- Два тома у одного контейнера postgres, второй — анонимный хеш на /var/lib/postgresql.
- PGDATA внутри контейнера = /var/lib/postgresql/18/docker, а ваш том висит на /var/lib/postgresql/data.
- В именованном томе на хосте лежат старые файлы 17-й версии (или он пуст), а свежая база — где-то в /var/lib/docker/volumes/<хеш>/_data/18/docker.
- docker volume ls показывает лишние висячие тома примерно с датой перехода на 18-ю версию.
Три разных сценария, которые постоянно путают
«Поломка при обновлении на postgres:18» — это на самом деле три разные ситуации с разными последствиями. Разводить их важно, потому что в двух из трёх у вас всё в порядке и паниковать не нужно.
Сценарий первый, самый частый и самый безобидный: у вас была рабочая база 17-й версии в томе на /var/lib/postgresql/data, вы поменяли тег на 18 и запустили. Контейнер не стартует и падает с внятной ошибкой. Это защита в entrypoint: он проверяет, что PGDATA пуст, но при этом видит PG_VERSION по старым путям — и отказывается инициализировать новую базу поверх. Данные целы, вы просто ещё не сделали pg_upgrade.
Error: in 18+, these Docker images are configured to store database data in a
       format which is compatible with "pg_ctlcluster" (specifically, using
       major-version-specific directory names).  This better reflects how
       PostgreSQL itself works, and how upgrades are to be performed.

       Counter to that, there appears to be PostgreSQL data in:
         /var/lib/postgresql/data

       This is usually the result of upgrading the Docker image without
       upgrading the underlying database using "pg_upgrade"...
Сценарий второй — тот, ради которого написана статья. База создаётся с нуля уже на 18-м образе, но со старым монтированием на /var/lib/postgresql/data. Никаких PG_VERSION по старым путям нет, значит первая проверка молчит. В актуальных образах есть вторая: если PGDATA стандартный, старых баз не нашлось, а на /var/lib/postgresql/data при этом что-то смонтировано — entrypoint ругается на «unused mount/volume» и тоже отказывается стартовать. Логика в коде выглядит так:
# 18/trixie/docker-entrypoint.sh, функция docker_setup_env
if [ -s "$PGDATA/PG_VERSION" ]; then
    DATABASE_ALREADY_EXISTS='true'
elif [ "$PGDATA" = "/var/lib/postgresql/$PG_MAJOR/docker" ]; then
    for d in /var/lib/postgresql /var/lib/postgresql/data /var/lib/postgresql/*/docker; do
        if [ -s "$d/PG_VERSION" ]; then
            OLD_DATABASES+=( "$d" )
        fi
    done
    if [ "${#OLD_DATABASES[@]}" -eq 0 ] && [ "$PG_MAJOR" -ge 18 ] && {
        mountpoint -q /var/lib/postgresql/data \
        || awk '$5 == "/var/lib/postgresql/data" { found = 1 } END { exit !found }' /proc/self/mountinfo
    }; then
        OLD_DATABASES+=( '/var/lib/postgresql/data (unused mount/volume)' )
    fi
fi
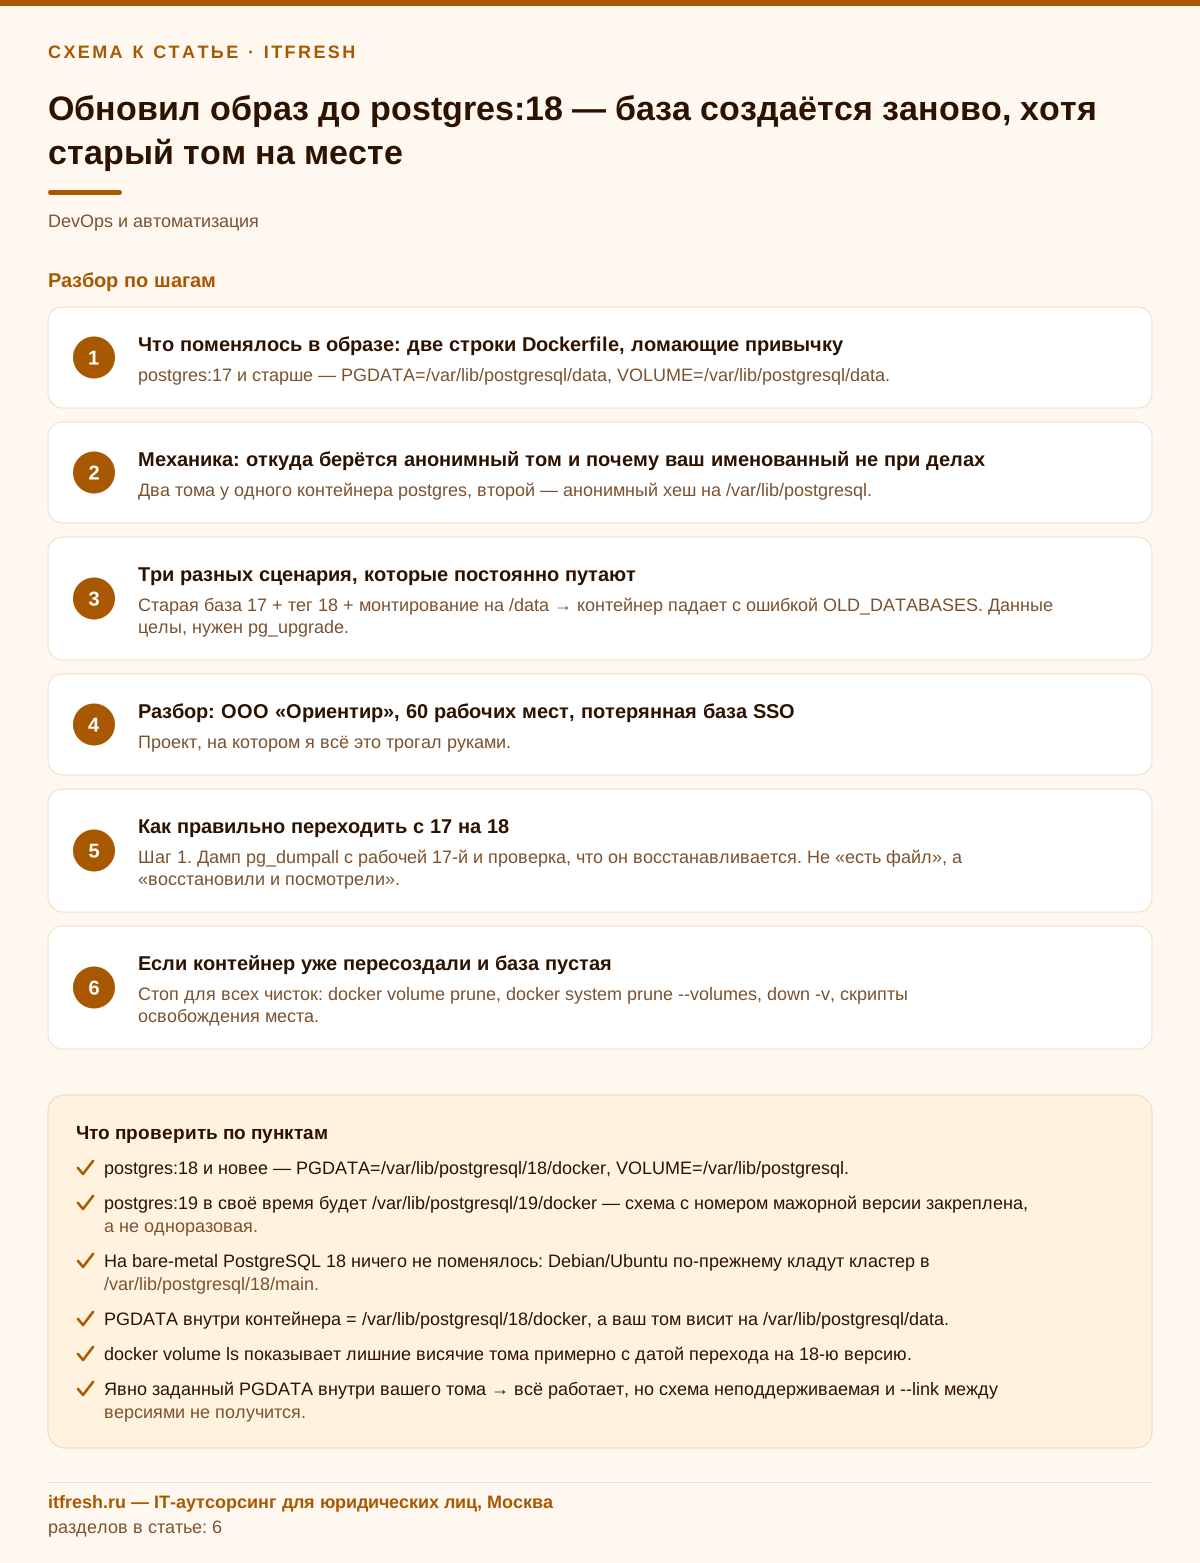
И вот тут была дыра, из-за которой люди теряли данные. В alpine-вариантах нет coreutils, и mountpoint там — апплет BusyBox, который определяет точку монтирования по смене устройства относительно родительского каталога. Тома Docker с драйвером local — это bind-монтирования каталогов из /var/lib/docker/volumes, часто на той же файловой системе, и такая эвристика их не распознаёт. Проверка молча возвращала «не смонтировано», контейнер стартовал, initdb отрабатывал в анонимном томе. Исправление пришло в PR №1409 («Fix Alpine missing /var/lib/postgresql/data mounts»), влитом 21 апреля 2026 года: резервный разбор /proc/self/mountinfo через awk, который вы видите во второй строке условия, — он повторяет логику coreutils без установки лишних пакетов. В обсуждении PR пользователи описывали тихую пропажу данных на postgres:18.3-alpine3.23, а в issue №1400 (февраль 2026) — на postgres:18.1-alpine. Мораль простая: если вы застряли на alpine-образе, собранном до этого исправления, защита вас не прикрывает.
Сценарий третий — экзотика, но встречается. Кто-то заранее прописал PGDATA руками, например /var/lib/postgresql/data/pgdata (популярный паттерн из старых compose-файлов) или, начитавшись форумов, /var/lib/postgresql/data/18/docker. В этом случае PGDATA не равен стандартному пути, вся ветка проверок вообще не выполняется, и база спокойно живёт внутри вашего именованного тома. Работать будет. Но вы теряете ровно то, ради чего затевался переезд — возможность pg_upgrade --link внутри одного монтирования, — и остаётесь вне поддерживаемой схемы. Вариант с /var/lib/postgresql/data/18/docker к тому же не входит в рекомендуемую схему: цикл поиска старых баз в entrypoint смотрит только /var/lib/postgresql/*/docker, и такой вложенный путь он не видит — ровно этому посвящён issue №1400. Рекомендация в README образа одна: один том на /var/lib/postgresql.
- Старая база 17 + тег 18 + монтирование на /data → контейнер падает с ошибкой OLD_DATABASES. Данные целы, нужен pg_upgrade.
- Новая база на 18 + монтирование на /data → в свежих образах ошибка «unused mount/volume»; в старых alpine — тихая инициализация в анонимном томе.
- Явно заданный PGDATA внутри вашего тома → всё работает, но схема неподдерживаемая и --link между версиями не получится.
- PGDATA не равен стандартному пути → защитные проверки образа выключены целиком. Помните об этом.
Разбор: «Внутренний компас», 11 рабочих мест, потерянная база записи клиентов
Проект, на котором я всё это трогал руками. Центр психологического консультирования «Внутренний компас», 11 рабочих мест: психологи, администратор ресепшена и бухгалтер; инфраструктуру обслуживаем целиком. Есть небольшой внутренний сервер на Ubuntu 24.04 в виртуалке — Docker 27, docker compose v2, несколько контейнеров: сервис онлайн-записи клиентов с расписанием специалистов, внутренняя вики с методичками и Nextcloud для документов, и рядом с каждым свой postgres. Всё поднято compose-файлами, тома именованные, бэкап — ночной pg_dumpall в сетевую шару, хранение 14 копий. Для консультационного центра база записи — это персональные данные клиентов и график приёмов, так что её потеря — не просто неудобство.
В феврале 2026-го приходящий администратор в рамках планового обновления поменял в трёх compose-файлах postgres:16-alpine на postgres:18-alpine. Compose-файлы были типовые, со строкой volumes: - pgdata:/var/lib/postgresql/data. Базы вики и Nextcloud были не пустые: оба контейнера честно упали с ошибкой про OLD_DATABASES — админ увидел, вернул тег 16 и отложил разбирательство. А третий, база нового сервиса записи, был поднят с нуля неделей раньше на пустом томе, и в alpine-варианте того времени проверка «unused mount/volume» не срабатывала. Контейнер стартовал. Сервис работал. Три недели, пока ресепшен вносил туда записи.
# было — и это ровно та строка, которая всё ломает
services:
  db:
    image: postgres:18-alpine
    volumes:
      - pgdata:/var/lib/postgresql/data   # <-- мимо PGDATA

# стало
services:
  db:
    image: postgres:18.6-alpine3.24
    volumes:
      - pgdata:/var/lib/postgresql        # <-- том накрывает 18/docker
Дальше — плановое обслуживание в пятницу вечером: обновление ядра, и перед перезагрузкой скрипт выполнил docker compose down, после неё — docker compose up -d. Контейнер создан заново, получил новый анонимный том, initdb, миграции сервиса на пустой базе. Утром понедельника администратор ресепшена написала: «пропало расписание и все клиенты, ошибок никаких». Классика: система не сломана, она просто новая.
Восстановление заняло сорок минут и прошло гладко ровно потому, что никто не успел выполнить docker volume prune. Висячих томов на хосте было три, нужный опознали по дате создания и по размеру — около 1,8 ГБ против сотен килобайт у соседей. Дальше подняли спасательный контейнер поверх найденного тома и сняли дамп.
# кандидаты
docker volume ls -qf dangling=true \
  | xargs -I{} docker volume inspect {} --format '{{.CreatedAt}} {{.Name}} {{.Mountpoint}}'

# размеры (нужны права root на /var/lib/docker)
sudo du -sh /var/lib/docker/volumes/*/_data 2>/dev/null | sort -h | tail -5

# проверяем, что это действительно кластер 18-й версии
sudo cat /var/lib/docker/volumes/<hash>/_data/18/docker/PG_VERSION

# спасательный контейнер: том монтируем на /var/lib/postgresql
docker run --rm -d --name pgrescue \
  -v <hash>:/var/lib/postgresql \
  -e POSTGRES_PASSWORD=irrelevant \
  postgres:18.6-alpine3.24

# ждём, пока сервер примет подключения
until docker exec pgrescue pg_isready -U postgres; do sleep 1; done

# без -t: TTY испортит переводы строк в дампе
docker exec pgrescue pg_dumpall -U postgres > /backup/booking-rescue.sql
docker stop pgrescue
Дамп снялся примерно за минуту, восстановили его в пересозданный по правильной схеме контейнер, сервис поднялся с данными на момент пятничного обслуживания. Потеряли ровно ноль записей: новая пустая база прожила выходные, центр в субботу и воскресенье не работает, и в неё никто ничего не внёс. Итог по проекту: во всех compose-файлах монтирование переведено на /var/lib/postgresql, теги зафиксированы до патч-версии, в скрипт обслуживания добавлена простая проверка — если у контейнера с базой больше одного тома, скрипт останавливается. И отдельная строчка в регламенте: ночной pg_dumpall теперь проверяется восстановлением раз в месяц, а не «мы же его настроили».
- Причина: тег postgres:18-alpine при старом монтировании на /var/lib/postgresql/data и сборка alpine-образа без фикса проверки монтирования.
- Спусковой крючок: `docker compose down` в скрипте обслуживания — Compose больше не мог перенести анонимный том из старого контейнера.
- Спасло: висячий анонимный том не удалили, его нашли по дате и размеру (1,8 ГБ).
- Восстановление: отдельный спасательный контейнер, pg_dumpall, заливка в контейнер с томом на /var/lib/postgresql.
- Профилактика: патч-версии в compose, проверка «один том на базу» в скрипте обслуживания, ежемесячный тест восстановления дампа.
Как правильно переходить с 17 на 18
Здесь надо развести две вещи, которые сливают в одну и потом удивляются. Смена монтирования — это про раскладку каталогов. Смена мажорной версии PostgreSQL — это про формат данных, и её всё равно надо делать либо через pg_upgrade, либо через дамп и восстановление. Образ за вас апгрейд не сделает и делать не должен: в контейнере с 18-й версией нет бинарников 17-й, а pg_upgrade требует обеих.
Мой порядок такой. Сначала переводим существующую 17-ю на новую раскладку, оставаясь на 17-й версии — это обратимая, дешёвая операция без изменения формата. Документация образа предлагает ровно это: явно задать PGDATA=/var/lib/postgresql/17/docker и монтировать том на /var/lib/postgresql, предварительно переложив файлы в подкаталог PG_MAJOR/docker. Я делаю это не переименованием внутри старого тома, а копированием в новый — чтобы в любой момент можно было откатиться на прежний compose.
# 0. останавливаем базу штатно, не kill
docker compose stop db

# 1. новый том и перекладка. uid проверяем у своего же образа:
#    alpine -> 70, debian/trixie -> 999
docker run --rm postgres:17.11-alpine3.24 id postgres

docker volume create pgdata_new
docker run --rm -v pgdata_old:/old:ro -v pgdata_new:/new alpine:3.22 sh -c '
  mkdir -p /new/17/docker &&
  cp -a /old/. /new/17/docker/ &&
  chown -R 70:70 /new'

# 2. compose: тот же тег 17, но новый том и явный PGDATA
#    image: postgres:17.11-alpine3.24
#    environment:
#      PGDATA: /var/lib/postgresql/17/docker
#    volumes:
#      - pgdata_new:/var/lib/postgresql
docker compose up -d db
docker compose logs -f db
Убедились, что 17-я поднялась на новом томе и приложение работает — старый том пока не трогаем, он ваш откат. Дальше сам апгрейд до 18-й. Внутри одного тома /var/lib/postgresql теперь лежит 17/docker, и pg_upgrade может создать рядом 18/docker с жёсткими ссылками, не упираясь в границу файловой системы. Ради этого всё и затевалось. Практических путей два: собрать одноразовый образ, где есть бинарники обеих версий, либо взять готовый образ tianon/postgres-upgrade с тегами вида 17-to-18 — его автор сам называет proof of concept, так что сначала прогоните на копии тома. Для маленьких баз я честно предпочитаю третий вариант — pg_dumpall со старого контейнера и восстановление в чистый 18-й. На базе до 20–30 ГБ это укладывается в то же окно и не требует ни одного нестандартного образа.
Здесь есть подводный камень, который в Docker-инструкциях почти не упоминают. В PostgreSQL 18 initdb по умолчанию включает контрольные суммы страниц (отключаются ключом --no-data-checksums), а pg_upgrade, согласно release notes 18, требует, чтобы настройка контрольных сумм у старого и нового кластера совпадала. Кластеры, созданные образами 17 и старше без POSTGRES_INITDB_ARGS=--data-checksums, контрольных сумм не имеют — и апгрейд упадёт на проверке совместимости. Выхода два: передать новому кластеру --no-data-checksums или заранее включить суммы на остановленной 17-й утилитой pg_checksums (она переписывает все файлы, на больших базах это долго). Проверить текущее состояние можно запросом SHOW data_checksums;.
# 1. у старого кластера checksums выключены?
docker compose exec db psql -U postgres -c 'SHOW data_checksums;'
docker compose stop db

# 2. апгрейд внутри одного тома; новый кластер — без checksums, как старый
docker run --rm \
  -v pgdata_new:/var/lib/postgresql \
  -e PGDATAOLD=/var/lib/postgresql/17/docker \
  -e PGDATANEW=/var/lib/postgresql/18/docker \
  -e POSTGRES_INITDB_ARGS='--no-data-checksums' \
  tianon/postgres-upgrade:17-to-18 --link

# 3. compose: тег 18, PGDATA из переменных убрать, том тот же
#    image: postgres:18.6-alpine3.24
#    volumes:
#      - pgdata_new:/var/lib/postgresql
Образ tianon собран на Debian, а uid пользователя postgres в alpine (70) и в debian (999) различается — если основной образ у вас alpine, проверьте владельца каталогов после апгрейда. Если выбираете дамп и восстановление, вопрос контрольных сумм снимается сам: новый кластер 18 получит их по умолчанию. Заодно в 18-й pg_upgrade по умолчанию переносит статистику планировщика (кроме расширенной), так что после апгрейда vacuumdb --analyze-in-stages нужен уже не для всего подряд.
И ещё одно, что экономит нервы: после успешного запуска 18-й не спешите удалять каталог 17/docker и старый том. Если апгрейд шёл с --link, старый кластер после запуска нового считается непригодным к использованию — в документации pg_upgrade прямо сказано, что после запуска нового кластера к старому доступа уже не будет: файлы общие, и записи 18-й версии портят 17-ю. То же относится к новому режиму --swap из PostgreSQL 18 — он разрушает старый каталог уже на этапе переноса. Ваш настоящий откат в этом случае — не старый каталог, а дамп, снятый до начала работ. Снимайте его всегда, даже если уверены в --link.
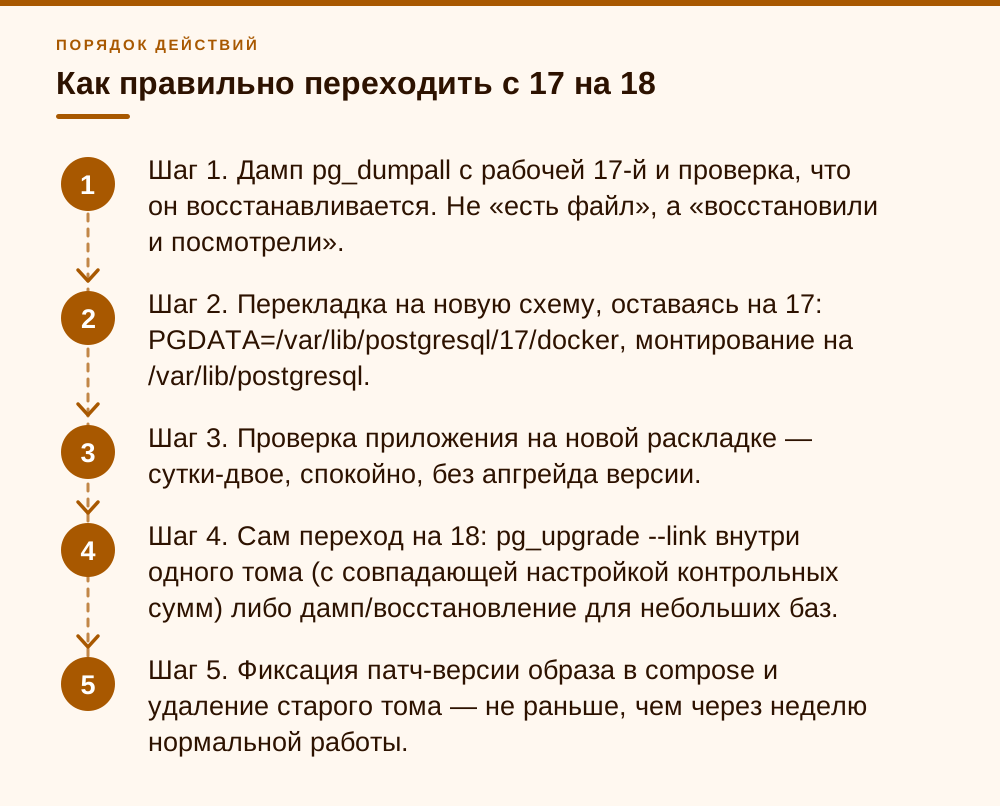
- Шаг 1. Дамп pg_dumpall с рабочей 17-й и проверка, что он восстанавливается. Не «есть файл», а «восстановили и посмотрели».
- Шаг 2. Перекладка на новую схему, оставаясь на 17: PGDATA=/var/lib/postgresql/17/docker, монтирование на /var/lib/postgresql.
- Шаг 3. Проверка приложения на новой раскладке — сутки-двое, спокойно, без апгрейда версии.
- Шаг 4. Сам переход на 18: pg_upgrade --link внутри одного тома (с совпадающей настройкой контрольных сумм) либо дамп/восстановление для небольших баз.
- Шаг 5. Фиксация патч-версии образа в compose и удаление старого тома — не раньше, чем через неделю нормальной работы.
Если контейнер уже пересоздали и база пустая
Порядок действий в аварийном режиме, по убыванию срочности. Первое и главное — остановить всё, что может подчистить тома. Никаких prune, никаких down -v, не запускать плановые скрипты уборки, не давать мониторингу «освободить место на диске». Ваши данные с высокой вероятностью живы и лежат в висячем анонимном томе, у которого нет владельца. Ровно по этому признаку его и убивают все автоматические чистилки.
Второе — снять слепок состояния, пока никто ничего не трогал: список томов с датами и размерами, вывод docker inspect по контейнеру, логи контейнера с момента подозрительного старта. В логах ищите строки инициализации — «The files belonging to this database system will be owned by user» и «PostgreSQL init process complete; ready for start up» — — она покажет, когда именно база родилась заново. Это ваша граница потерянного периода.
Третье — поиск нужного тома. Опознаём по трём признакам сразу: дата создания около момента перехода на 18-й образ, размер, сопоставимый с ожидаемым размером базы, и наличие файла 18/docker/PG_VERSION внутри. На загруженном хосте с десятками контейнеров висячих томов бывает много, поэтому смотрите именно на комбинацию, а не на что-то одно.
Четвёртое — не поднимайте найденный том сразу в боевой compose. Запустите отдельный спасательный контейнер, снимите pg_dumpall, положите дамп в надёжное место вне хоста и только потом собирайте прод по правильной схеме. Соблазн «сейчас просто поправлю путь в compose и перезапущу» велик, но если вы промахнётесь ещё раз, вы получите второй анонимный том и потеряете ориентацию в том, где какая база.
# слепок состояния до любых действий
docker volume ls > /root/vol-before.txt
docker inspect pg > /root/pg-inspect.json
docker logs pg --since 720h 2>&1 | grep -iE 'init process complete|files belonging|initdb|PG_VERSION' | head -40

# восстановление в чистый контейнер, собранный по правильной схеме
docker compose up -d db
docker compose exec -T db psql -U postgres < /backup/booking-rescue.sql
И отдельно про то, чего делать не надо. Не пытайтесь скопировать файлы кластера из анонимного тома в именованный «пофайлово, чтобы быстрее» при работающем контейнере — получите неконсистентный каталог. Не восстанавливайте дамп поверх базы, куда приложение уже накатило свои миграции с нуля: сначала уроните и пересоздайте базу, потом лейте дамп. И не выключайте бэкапы «на время разбирательства» — именно в такие моменты они и нужны.
- Стоп для всех чисток: docker volume prune, docker system prune --volumes, down -v, скрипты освобождения места.
- Слепок: docker volume ls, docker inspect, логи контейнера. До любых действий.
- Поиск тома: дата ≈ момент перехода на 18, подходящий размер, файл 18/docker/PG_VERSION внутри.
- Спасательный контейнер отдельно от прода, дамп pg_dumpall, выгрузка дампа с хоста.
- Пересборка прода с монтированием на /var/lib/postgresql и фиксированной патч-версией образа.
Что я делаю по умолчанию и на что можно забить
Соберу приоритеты, потому что список рекомендаций всегда длиннее, чем есть времени. В первую очередь — инвентаризация. Пройдите по всем хостам с Docker и найдите контейнеры с постгресом, у которых больше одного тома. Это делается одной командой и сразу показывает, где вы уже стоите на мине. Дальше — фиксация патч-версий в compose. Не мажорной, а именно патч: postgres:18.6-trixie, а не postgres:18. Оба пункта закрываются за час на десяток хостов и снимают процентов девяносто риска.
# инвентаризация: контейнеры postgres с более чем одним томом
for c in $(docker ps -aq); do
  img=$(docker inspect "$c" --format '{{.Config.Image}}')
  case "$img" in *postgres*) ;; *) continue ;; esac
  n=$(docker inspect "$c" --format '{{len .Mounts}}')
  [ "$n" -gt 1 ] && echo "ПРОВЕРИТЬ: $(docker inspect "$c" --format '{{.Name}}') $img томов=$n"
done
Во вторую очередь — бэкапы, и не в смысле «настроены», а в смысле «проверены восстановлением». В истории с «Внутренним компасом» всё закончилось хорошо не потому, что мы умные, а потому что висячий том никто не удалил. Это везение, а не процесс. Ночной pg_dumpall с хранением двух недель и ежемесячной проверкой восстановления стоит копейки и закрывает не только эту проблему, но и десяток других — от dropped table руками разработчика до сдохшего NVMe.
В третью очередь — сам переезд на новую раскладку. Он не горит. Если у вас сейчас работает postgres:17 с монтированием на /var/lib/postgresql/data — ничего не сломано и ломаться не собирается, 17-я версия поддерживается до ноября 2029 года. Переезжайте спокойно, когда будете планово идти на 18-ю, и делайте это в два отдельных шага, как я описал выше. Спешить и совмещать смену раскладки со сменой мажорной версии в одном окне — плохая идея.
И то, на что можно забить со спокойной душой. Не надо переписывать раскладку на dev-стендах и в CI, где база живёт минуты и создаётся из фикстур — там потеря анонимного тома ничего не стоит, а времени на аккуратный переезд уйдёт столько же. Не надо мигрировать managed-базы у облачных провайдеров: там свой запуск, PGDATA образа Docker Official Image к ним отношения не имеет. И не надо бояться самой схемы с подкаталогами версий — она правильная, она давно принята в Debian, и через год-два все compose-файлы будут написаны под неё, а сегодняшняя боль забудется как боль перехода с links на networks.
- Сейчас: найти контейнеры с двумя томами, зафиксировать патч-версии образов, выключить автоматические чистки томов на хостах с базами.
- На этой неделе: проверить восстановление ночного дампа. Реально восстановить, а не посмотреть на размер файла.
- В плановом окне: перекладка на /var/lib/postgresql на текущей мажорной версии, отдельно — апгрейд до 18.
- Можно не делать: миграция dev-стендов и CI, где база одноразовая; ручные правки в managed-базах провайдеров.
Частые вопросы
Это изменение PostgreSQL 18 или только Docker-образа?
Только образа Docker Official Image. Путь /var/lib/postgresql/18/docker придуман мейнтейнерами образа, чтобы раскладка соответствовала pg_ctlcluster. Если вы ставите PostgreSQL 18 пакетами на Debian или Ubuntu, кластер будет в /var/lib/postgresql/18/main, как и раньше. В документации самого PostgreSQL каталога docker нет.
У меня работает postgres:17 с монтированием на /var/lib/postgresql/data. Надо срочно всё менять?
Нет. На 17-й версии старая раскладка — штатная и поддерживаемая, поддержка ветки 17 идёт до ноября 2029 года. Проблема возникает только в момент перехода на образ 18-й версии. Спокойно переезжайте в плановое окно, отдельно перекладку каталогов и отдельно апгрейд мажорной версии.
Можно просто задать PGDATA=/var/lib/postgresql/data и оставить старый compose?
Технически заработает: PGDATA окажется внутри вашего именованного тома. Но при этом полностью отключаются защитные проверки образа (они выполняются только когда PGDATA равен стандартному пути), и вы теряете возможность pg_upgrade --link при следующем мажорном обновлении. Я так не делаю — это откладывание проблемы на год.
Как понять, где сейчас лежат мои данные?
Выполните docker exec <контейнер> sh -c 'echo $PGDATA' и сравните с выводом docker inspect <контейнер> --format '{{range .Mounts}}{{.Name}} -> {{.Destination}}{{"\n"}}{{end}}'. Если PGDATA не находится внутри пути, куда смонтирован ваш именованный том, — данные пишутся в анонимный том и исчезнут при следующем пересоздании контейнера.
Контейнер падает с ошибкой про OLD_DATABASES. Это уже потеря данных?
Наоборот — это защита сработала, и данные целы. Образ увидел кластер старой версии по прежнему пути и отказался инициализировать поверх него новую базу. Вам нужно выполнить апгрейд самой базы через pg_upgrade или дамп с восстановлением; смены тега образа для этого недостаточно.
Помогает ли обновление патч-версии образа?
От тихой потери — да, существенно. В ранних 18-х alpine-образах проверка «unused mount/volume» не срабатывала из-за особенностей mountpoint в BusyBox, и контейнер стартовал молча. В образах, собранных после PR №1409 (влит 21 апреля 2026), добавлен резервный разбор /proc/self/mountinfo, и такая конфигурация теперь останавливает запуск с ошибкой. Обновиться стоит до того, как начинать разбирательство.
pg_upgrade с 17 на 18 падает на проверке контрольных сумм. Что делать?
В PostgreSQL 18 initdb по умолчанию включает data checksums, а кластеры из образов 17 и старше обычно созданы без них; pg_upgrade требует совпадения этой настройки. Инициализируйте новый кластер с --no-data-checksums (в tianon/postgres-upgrade — через POSTGRES_INITDB_ARGS) или включите суммы на остановленной 17-й утилитой pg_checksums --enable. При переходе через дамп и восстановление проблемы нет.
Источники
- Docker Official Image postgres — описание образа, раздел PGDATA и «Where to Store Data» — Официальное описание образа: PGDATA в 18+ равен /var/lib/postgresql/18/docker, VOLUME изменён на /var/lib/postgresql, приведена подготовка на 17 через PGDATA=/var/lib/postgresql/17/docker с переносом файлов в подкаталог PG_MAJOR/docker. https://hub.docker.com/_/postgres (исходник текста: https://github.com/docker-library/docs/blob/master/postgres/content.md)
- docker-library/postgres, PR #1259 — «use pg_ctlcluster-compatible directory layout» — Pull request, влитый 5 июня 2025 года: смена PGDATA на /var/lib/postgresql/MAJOR/docker и VOLUME на /var/lib/postgresql ради возможности pg_upgrade --link без пересечения границ монтирования. https://github.com/docker-library/postgres/pull/1259
- docker-library/postgres, issue #1400 — «PostgreSQL 18: OLD_DATABASES detection fails» — Issue, открытый 7 февраля 2026: postgres:18.1-alpine, вложенный путь /var/lib/postgresql/data/18/docker не находится циклом поиска старых баз, тихая инициализация при пересоздании контейнера. https://github.com/docker-library/postgres/issues/1400
- docker-library/postgres, PR #1409 — «Fix Alpine missing /var/lib/postgresql/data mounts» — Влит 21 апреля 2026: резервная проверка монтирования через /proc/self/mountinfo (awk) для alpine-вариантов, где mountpoint из BusyBox не видел том на /var/lib/postgresql/data. https://github.com/docker-library/postgres/pull/1409
- docker-library/postgres — 18/trixie/Dockerfile и docker-entrypoint.sh — Первоисточник по значениям ENV PGDATA /var/lib/postgresql/18/docker, VOLUME /var/lib/postgresql, PG_VERSION 18.6, а также функции docker_error_old_databases и логике определения OLD_DATABASES. https://github.com/docker-library/postgres/blob/master/18/trixie/Dockerfile и https://github.com/docker-library/postgres/blob/master/18/trixie/docker-entrypoint.sh
- PostgreSQL 18 Documentation — pg_upgrade, ключ --link — Документация по pg_upgrade: требование к расположению старого и нового кластеров при использовании жёстких ссылок и предупреждение о непригодности старого кластера после запуска нового с --link. https://www.postgresql.org/docs/18/pgupgrade.html
- Roman Diachenko — «Postgres 18 Docker Silently Ignores Your Named Volume» — Практический разбор с таблицей изменений PGDATA/VOLUME между 16 и 18, диагностикой через docker inspect и исправленным вариантом compose. https://rdiachenko.com/posts/databases/postgresql/postgres-18-docker-silently-ignores-your-named-volume/
- PostgreSQL 18 Release Notes — Раздел Migration to Version 18 и pg_upgrade: initdb включает data checksums по умолчанию (--no-data-checksums), pg_upgrade требует совпадения настройки checksums, перенос статистики, режим --swap. https://www.postgresql.org/docs/18/release-18.html
- tianon/docker-postgres-upgrade — Образы tianon/postgres-upgrade:OLD-to-NEW для pg_upgrade в Docker, переменные PGDATAOLD/PGDATANEW, POSTGRES_INITDB_ARGS, раскладка DIR/OLD/docker и DIR/NEW/docker для --link. https://github.com/tianon/docker-postgres-upgrade
- Docker Docs — docker compose up — Ключ -V/--renew-anon-volumes: «Recreate anonymous volumes instead of retrieving data from the previous containers». https://docs.docker.com/reference/cli/docker/compose/up/