Почему «поставили и забыли» не работает
Это третья статья серии про Odoo: в первой разбирали, что Odoo Community — не «урезанная бесплатная CRM», а полноценная модульная ERP, во второй разворачивали Odoo 19 на VPS (Docker, PostgreSQL, nginx, SSL). Сейчас — о самом недооценённом: как с этой системой жить дальше, на площадках IT-аутсорсинга для компаний до 50 рабочих мест в Москве.
Поставить Odoo — это вечер работы. Развернуть контейнер, поднять базу, накатить сертификат, включить нужные модули — к утру у вас работающая CRM. А вот жить с ней годами, чтобы она не легла в самый неподходящий момент и не утекла наружу, — вот где начинается настоящая инженерия. Установка — это старт, а не финиш. И именно на этом отрезке я вижу больше всего боли, когда к нам приходят на аудит чужие внедрения.
Что мы находим в чужих внедрениях
За последние годы мы приняли на сопровождение не один десяток серверов Odoo, которые до нас ставил кто-то другой — фрилансер, «знакомый айтишник» или сам собственник по видео на YouTube. Картина повторяется с пугающим постоянством:
- Мастер-пароль по умолчанию. Параметр
admin_passwdв конфиге так и остался равнымadmin— то есть значению из первого попавшегося туториала. Это пароль, который открывает доступ к созданию, удалению и выгрузке любой базы данных на сервере. - Менеджер баз данных торчит наружу. Страница
/web/database/managerоткрыта всему интернету. В связке с дефолтным мастер-паролем это означает, что любой желающий может зайти и скачать вашу базу целиком — со всеми лидами, договорами и персональными данными клиентов. - Бэкапов нет или они не восстанавливаются. Либо резервное копирование не настроено вовсе, либо настроено «наполовину»: копится дамп базы, но без файлового хранилища, или дампы складываются на тот же диск, что и сама система. А чаще всего — их просто ни разу не пробовали восстановить, и в час икс выясняется, что архивы битые.
Дальше я разложу по полочкам весь наш регламент сопровождения: как мы строим бэкапы в три уровня, чем минорное обновление отличается от мажорного апгрейда 18→19, как закрываем систему от посторонних и что делает self-hosted для соответствия 152-ФЗ. Всё — из живой практики, с конфигами и скриптами, которые можно брать и применять.
Бэкапы — три уровня защиты
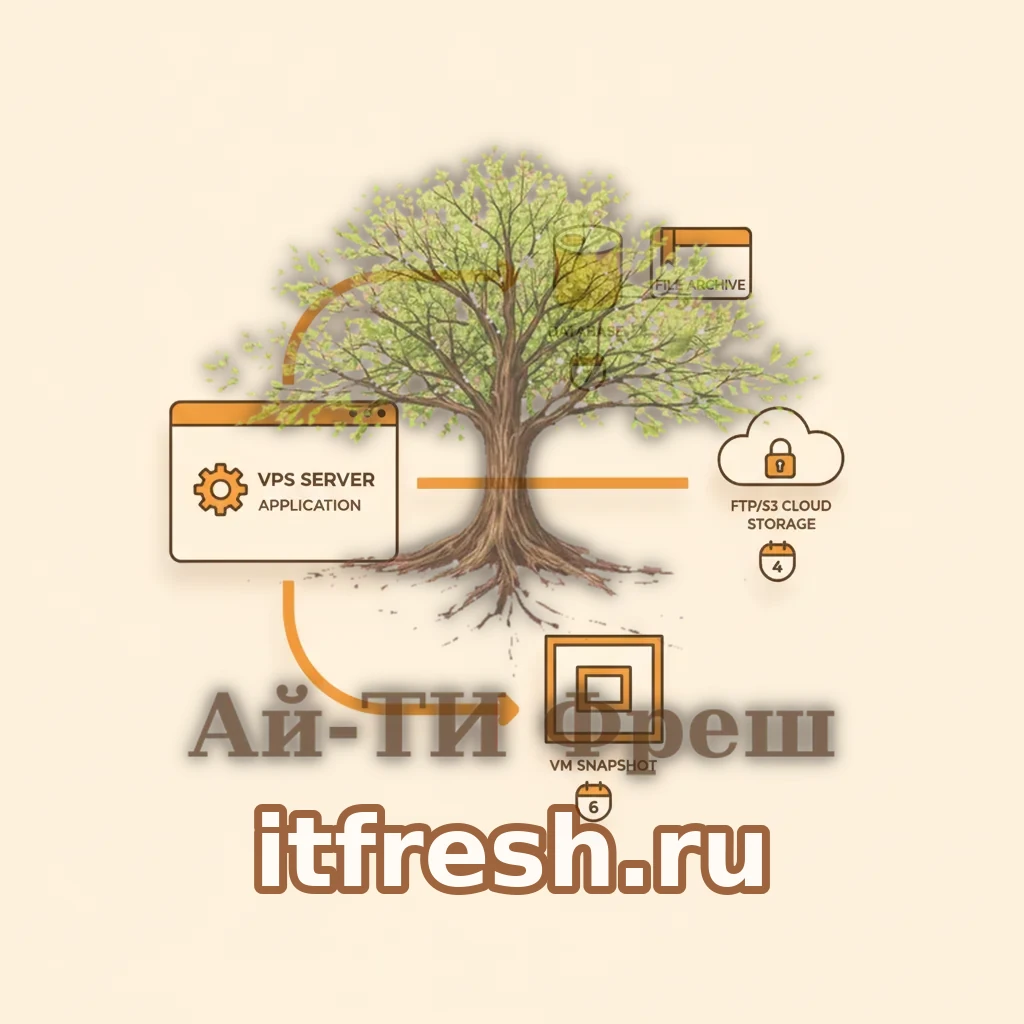
Начну с бэкапов, потому что это единственное, что реально спасает бизнес, когда всё пошло не так: упал диск, зашифровал шифровальщик, кто-то удалил не ту базу, обновление встало колом. Один уровень резервного копирования — это иллюзия защиты. Мы строим три, и каждый закрывает свой класс аварий.
Уровень 1 — логический бэкап: pg_dump + filestore
Здесь кроется главная грабля, на которой спотыкаются почти все самоучки. Odoo хранит вложения не в базе данных. Договоры, коммерческие предложения, фотографии, сканы, картинки товаров — всё это лежит в отдельном каталоге на диске, который называется filestore. По умолчанию это /var/lib/odoo/filestore/<имя_базы>, а в Docker-развёртывании — соответствующий том с data_dir. В самой базе PostgreSQL хранятся только метаданные и контрольные суммы файлов.
pg_dump каждую ночь, всё было хорошо». Диск умирает, человек разворачивает дамп на новом сервере — и обнаруживает, что в карточках сделок вместо вложений битые ссылки. База цела, а всех документов нет, потому что они лежали в filestore, который никто не копировал. Запомните железно: полный логический бэкап Odoo = дамп базы + архив каталога filestore. Одно без другого бессмысленно.Вот боевой bash-скрипт, который мы ставим клиентам. Он делает дамп базы, архивирует filestore, кладёт всё в датированную папку и разгребает старьё по схеме ротации «7 дневных / 4 недельных / 6 месячных»:
#!/usr/bin/env bash
set -euo pipefail

# --- параметры ---
DB_NAME="odoo_prod"
DB_USER="odoo"
FILESTORE="/var/lib/odoo/filestore/${DB_NAME}"
BACKUP_ROOT="/backup/odoo"
DATE=$(date +%Y-%m-%d)
DOW=$(date +%u)      # день недели 1..7
DOM=$(date +%d)      # день месяца
DEST="${BACKUP_ROOT}/daily/${DATE}"

mkdir -p "${DEST}"

# 1. Логический дамп базы (формат custom, сжатый)
pg_dump -U "${DB_USER}" -F c -f "${DEST}/${DB_NAME}.dump" "${DB_NAME}"

# 2. Архив filestore (вложения!)
tar czf "${DEST}/filestore.tar.gz" -C "$(dirname "${FILESTORE}")"     "$(basename "${FILESTORE}")"

# 3. Контрольная сумма — чтобы ловить битые архивы
sha256sum "${DEST}"/* > "${DEST}/SHA256SUMS"

# --- ротация ---
# воскресенье -> недельная копия
[ "${DOW}" = "7" ] && cp -al "${DEST}" "${BACKUP_ROOT}/weekly/${DATE}"
# 1-е число -> месячная копия
[ "${DOM}" = "01" ] && cp -al "${DEST}" "${BACKUP_ROOT}/monthly/${DATE}"

# чистим: 7 дневных, 4 недельных, 6 месячных
find "${BACKUP_ROOT}/daily"   -maxdepth 1 -type d -mtime +7   -exec rm -rf {} +
find "${BACKUP_ROOT}/weekly"  -maxdepth 1 -type d -mtime +28  -exec rm -rf {} +
find "${BACKUP_ROOT}/monthly" -maxdepth 1 -type d -mtime +186 -exec rm -rf {} +

echo "OK ${DATE}: $(du -sh "${DEST}" | cut -f1)"
Скрипт вешается в cron на ночь, лог пишется в файл и заворачивается в наш мониторинг, чтобы молчание («задача не отработала») тоже было сигналом. Формат -F c у pg_dump выбран не случайно: он сжатый и позволяет восстанавливать выборочно через pg_restore.
Уровень 2 — выгрузка на внешнее хранилище
Бэкап, который лежит на том же сервере, что и сама система, защищает ровно ни от чего серьёзного. Сгорел VPS, зашифровал шифровальщик весь диск, хостер потерял ноду — и локальные архивы ушли вместе с боевой базой. Поэтому второй уровень — обязательный вынос копий за пределы сервера.
У нас для этого свой FTP-сервер на собственном железе в дата-центре — данные клиента не покидают контролируемый нами периметр. Если у клиента своя политика, направляем в S3-совместимое хранилище (их сейчас много у российских провайдеров). Ключевое правило: наружу копия уходит только в зашифрованном виде. База лидов и договоров, улетающая по сети в открытом виде, — это готовая утечка персональных данных.
# Шифруем свежий бэкап симметричным ключом и льём на внешний хранитель
cd /backup/odoo/daily/$(date +%Y-%m-%d)

# GPG-шифрование пароль-фразой (ключ хранится отдельно, НЕ на сервере)
for f in *.dump *.tar.gz; do
    gpg --batch --yes --symmetric --cipher-algo AES256         --passphrase-file /root/.backup_key "$f"
done

# Выгрузка на внешний FTP (или aws s3 cp --sse для S3)
lftp -u "$FTP_USER,$FTP_PASS" "$FTP_HOST" <<'EOF'
mirror -R --only-newer --include-glob *.gpg        . /odoo-backups/$(date +%Y-%m)/
bye
EOF
Файл с паролем-фразой /root/.backup_key держим с правами 600 и, что важнее, ключ дешифрования хранится отдельно от сервера — иначе шифрование теряет смысл. Для S3 всё аналогично: aws s3 cp с серверным шифрованием и версионированием бакета.
Уровень 3 — снапшот VPS перед обновлением
Третий уровень — снимок всей виртуальной машины целиком. Логический бэкап восстанавливает данные, но не восстанавливает состояние системы: версию Odoo, установленные модули, конфиги, зависимости. А снапшот VPS замораживает всё разом на уровне гипервизора. Панель почти любого нормального хостера умеет делать снапшоты в пару кликов или по API.
Мы делаем снапшот обязательно перед каждым обновлением — минорным или мажорным, неважно. Это наша «кнопка отмены»: если после обновления что-то пошло не так, откат к снапшоту возвращает систему в рабочее состояние за минуты, а не за часы восстановления из дампа с последующей переустановкой модулей. Снапшот — это страховка не от потери данных, а от неудачного изменения.
Правило, без которого всё вышесказанное — театр
Поэтому в наш регламент жёстко зашит ежемесячный тестовый restore на staging-окружение. Раз в месяц инженер берёт свежую внешнюю (зашифрованную) копию, разворачивает её на отдельном тестовом сервере, поднимает Odoo, логинится и проверяет: база открывается, вложения на месте, отчёты строятся. Только пройденный тест восстановления превращает «мы делаем бэкапы» в «мы защищены». Всё остальное — самоуспокоение.
Обновления: минорные против мажорных
Второй столп эксплуатации — обновления. И здесь надо чётко разделять два принципиально разных процесса, которые в разговоре часто путают: рутинное минорное обновление внутри одной версии и мажорный апгрейд на следующую версию. Первое — плановая двухминутная операция. Второе — полноценный проект.
Минорные обновления — смена тега образа
Внутри версии 19 регулярно выходят исправления: багфиксы, патчи безопасности, мелкие улучшения. В Docker-развёртывании обновление до свежего билда той же версии — это смена тега образа и пересоздание контейнера. Схема отработана и почти не несёт риска, потому что структура базы не меняется. Наш порядок действий:
- Снапшот VPS — та самая кнопка отмены из уровня 3.
docker compose pull— тянем свежий образodoo:19.docker compose up -d— пересоздаём контейнер на новом образе, том с данными и filestore остаются на месте.- Smoke-тест: открывается страница входа, логинимся, открываем воронку CRM, создаём тестовую сделку, строим отчёт. Три минуты — и мы убедились, что живое.
Реальный простой на пересоздании контейнера — около двух минут. Мы делаем это в согласованное окно (обычно рано утром или в выходной) и всегда после снапшота. Если smoke-тест что-то показал — откат к снапшоту, разбор в спокойном режиме.
Мажорный апгрейд 18→19 — это отдельный проект
А вот переход между версиями — совсем другая история, и я хочу, чтобы это прозвучало предельно чётко, потому что именно здесь у людей самые опасные заблуждения.
Что делать Community-пользователю? Официальная рекомендация самой Odoo — использовать OpenUpgrade от сообщества OCA (Odoo Community Association). Это открытый проект на GitHub (github.com/OCA/OpenUpgrade), набор скриптов миграции под каждую версию — например, модуль odoo-addon-openupgrade-scripts ветки 19.0. Лицензия AGPL-3.0, распространяется бесплатно. OpenUpgrade прогоняет базу через набор преобразований, приводя её структуру к новой версии.
Но это только половина задачи. Вторая половина — кастомные модули. Если под вас дописывали функциональность (а под многих дописывали — то поле в карточке, то отчёт, то интеграция), каждый такой модуль надо портировать под новую версию вручную: API Odoo между версиями меняется, и код, работавший на 18-й, на 19-й может просто не запуститься. Плюс всё это обязательно прогоняется на staging-копии, тестируется и только потом накатывается на прод. Поэтому мажорный апгрейд у нас — это всегда отдельная смета, отдельное окно и отдельный план отката.
Обновления ОС и PostgreSQL
Odoo живёт не в вакууме — под ней операционная система и СУБД, и их тоже надо поддерживать. Здесь у нас два разных режима.
Security-обновления ОС ставим автоматически. На Debian/Ubuntu включаем unattended-upgrades, настроенный ставить только обновления безопасности — не все подряд, а именно security-репозиторий. Это закрывает свежие уязвимости в системных пакетах без ручного вмешательства и без риска, что автообновление притащит поломку в прикладной софт.
Мажорное обновление PostgreSQL (например, с 14-й ветки на 16-ю) — только руками и только в плановое окно, никакой автоматики. Смена мажорной версии СУБД требует миграции кластера (pg_upgrade или дамп-восстановление), проверки совместимости и, разумеется, свежего бэкапа перед стартом. Минорные же обновления PostgreSQL (внутри одной ветки) безопасны и приезжают с системными апдейтами.
Hardening: чек-лист безопасности
Теперь про защиту периметра. Odoo из коробки настроена на удобство запуска, а не на безопасность в бою. Превратить «работает» в «работает и закрыто» — это конкретный набор действий. Ниже наш чек-лист, который мы прогоняем на каждом сервере, а затем — конфиги и таблица.
Уровень приложения: odoo.conf
Первым делом закрываем менеджер баз данных — тот самый, что мы находим открытым в чужих внедрениях. В odoo.conf:
[options]
; НЕ показывать список баз и запретить выбор БД снаружи
list_db = False
; жёстко привязать домен к базе — одна база, одно имя
db_filter = ^odoo_prod$
; длинный случайный мастер-пароль вместо admin
admin_passwd = k7Qm2_xR9pLf4Wz-Vt6Nc8Hy3Bs1Dj0
; воркеры и лимиты памяти (см. раздел про производительность)
workers = 4
limit_memory_soft = 2147483648
limit_memory_hard = 2684354560
limit_time_cpu = 600
limit_time_real = 1200
list_db = False убирает выпадающий список баз на экране входа, db_filter намертво привязывает сервер к одной базе, а admin_passwd меняем на длинную случайную строку — этот пароль нужен только для операций с базами и вводится редко, так что делайте его максимально длинным.
Уровень nginx: reverse-proxy как фильтр
Odoo всегда прячем за nginx. Он же — второй рубеж защиты: ограничивает частоту попыток входа и запрещает доступ к менеджеру баз с любых внешних адресов.
# --- ограничение частоты запросов к странице входа ---
limit_req_zone $binary_remote_addr zone=odoo_login:10m rate=6r/m;

server {
    listen 443 ssl http2;
    server_name crm.example.ru;

    # ... ssl_certificate и прочее ...

    # rate-limit на форму входа: 6 попыток в минуту с IP
    location = /web/login {
        limit_req zone=odoo_login burst=3 nodelay;
        proxy_pass http://127.0.0.1:8069;
    }

    # менеджер баз — только из офисной сети, остальным 403
    location /web/database {
        allow 203.0.113.0/24;   # ваш офисный IP/подсеть
        deny all;
        proxy_pass http://127.0.0.1:8069;
    }

    location / {
        proxy_set_header Host $host;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
        proxy_set_header X-Forwarded-Proto $scheme;
        proxy_pass http://127.0.0.1:8069;
    }
}
Уровень ОС: fail2ban и ufw
Против перебора паролей и брутфорса ставим fail2ban с правилом на лог Odoo: несколько неудачных входов подряд — и IP уходит в бан на уровне файрвола. Odoo пишет неудачные попытки аутентификации в свой лог, fail2ban их ловит по регулярному выражению.
Файрвол ufw закрываем по принципу «запрещено всё, что не разрешено явно». Наружу открыты только веб-порты, SSH — по ключам и с нестандартного порта:
ufw default deny incoming
ufw default allow outgoing
ufw allow 80/tcp          # http (редирект на https)
ufw allow 443/tcp         # https
ufw allow 2222/tcp        # ssh на нестандартном порту
ufw enable
Порт 8069, на котором слушает сам Odoo, наружу не открываем никогда — к нему ходит только nginx с локалхоста. SSH переводим на ключи и отключаем вход по паролю в sshd_config (PasswordAuthentication no), предварительно убедившись, что ключ работает.
Уровень пользователей: 2FA и аудит прав
В Odoo из коробки (в том числе в Community) встроена двухфакторная аутентификация по TOTP — та самая, что работает с Google Authenticator и аналогами. Мы включаем её обязательно для всех, у кого есть доступ к чувствительным данным: от руководителя отдела продаж и выше, а по-хорошему — всем менеджерам. Один слитый или подобранный пароль без второго фактора уже не даёт войти.
И отдельно — аудит прав. Раз в месяц проходим по списку пользователей: сотрудник уволился — учётку отключаем немедленно, а не «когда-нибудь»; проверяем, нет ли «мёртвых душ» и лишних прав администратора у тех, кому они не нужны. Уволенный менеджер с активным доступом к базе клиентов — это не гипотетический, а вполне реальный канал утечки.
Сводный чек-лист
| Рубеж | Мера | Зачем |
|---|---|---|
| odoo.conf | list_db = False + db_filter | Скрыть список баз, привязать домен к базе |
| odoo.conf | Длинный случайный admin_passwd | Закрыть управление базами |
| nginx | Rate-limit на /web/login | Замедлить перебор паролей |
| nginx | deny на /web/database снаружи | Менеджер баз только из офиса |
| ОС | fail2ban на лог Odoo | Бан IP за брутфорс |
| ОС | ufw: наружу только 80/443/SSH | Закрыть 8069 и всё лишнее |
| ОС | SSH по ключам, нестандартный порт | Убрать вход по паролю |
| Пользователи | 2FA/TOTP для менеджеров и выше | Защита от слитого пароля |
| Пользователи | Ежемесячный аудит учёток | Убрать уволенных и «мёртвые души» |
152-ФЗ и персональные данные в CRM
Тема, которую нельзя обойти, когда речь про CRM: любая база лидов и клиентов — это персональные данные. Имя, телефон, email, должность, история переписки — всё это ПДн в терминах Федерального закона № 152-ФЗ «О персональных данных». А значит, компания, которая ведёт такую базу, автоматически становится оператором персональных данных со всеми вытекающими обязанностями.
Локализация ПДн — главный аргумент self-hosted
Закон требует, чтобы обработка (в том числе хранение) персональных данных россиян велась в базах данных, физически расположенных на территории РФ. Это то самое требование о локализации, из-за которого в своё время было столько шума вокруг зарубежных сервисов. И вот здесь self-hosted Odoo решает вопрос элегантно: когда система развёрнута на VPS у российского хостера, локализация ПДн выполняется автоматически. Данные лежат на сервере в российском дата-центре, под российской юрисдикцией — требование закрыто самой архитектурой. Мы держим клиентские серверы в дата-центре МТС, и вопрос «а где физически лежат данные наших клиентов» имеет чёткий, проверяемый ответ.
Что писать про self-hosted в модели угроз
Оператор ПДн обязан определить модель угроз и уровень защищённости. Self-hosted-развёртывание даёт для этого удобную опору: у вас контролируемый периметр. Вы точно знаете, где физически находятся данные, кто имеет к ним административный доступ, как настроен файрвол и шифрование. Это выгодно отличается от ситуации «данные в чужом облаке, а мы верим на слово в их сертификаты». В модели угроз self-hosted позволяет честно описать реальные меры: изоляция сети, ограничение доступа, журналирование, шифрование резервных копий — всё то, что мы и так делаем в рамках hardening из предыдущего раздела.
Журналирование, шифрование, доступ
Технические меры, которые напрямую работают на соответствие и которые мы реализуем штатными средствами:
- Журналирование доступа. Odoo штатно ведёт лог входов и действий пользователей; на уровне ОС и nginx — свои access-логи. Вместе они дают ответ на вопрос «кто, когда и откуда обращался к данным» — это требование к учёту действий с ПДн.
- Шифрование бэкапов. Про это я подробно писал в разделе про Уровень 2: копии базы уходят за периметр только в зашифрованном виде (AES-256). Незашифрованный бэкап с ПДн — это потенциальный инцидент утечки.
- Ограничение доступа. 2FA, ролевая модель прав внутри Odoo, закрытый файрволом периметр, аудит учёток — всё это и есть «разграничение доступа к ПДн» на языке закона.
Ещё раз подчеркну границу ответственности: технически self-hosted Odoo на российском VPS закрывает существенную часть требований 152-ФЗ — локализацию, разграничение доступа, защиту при передаче и хранении. Но документальную обвязку — политику обработки, приказ о назначении ответственного, согласия субъектов ПДн — оформляет клиент со своими юристами. Мы даём надёжный технический фундамент, на котором эту обвязку удобно строить.
Мониторинг и типовые инциденты
Хороший бэкап спасает после аварии. Хороший мониторинг помогает до аварии не доводить. Мы не ждём, пока клиент позвонит с «у нас всё легло», — мы стараемся узнать о проблеме первыми и починить до того, как её заметит бизнес. Вот что мониторим на каждом сервере Odoo.
Что под наблюдением
- Доступность страницы входа (
/web/login) — простой HTTP-чек каждую минуту. Не открылась — алерт, не дожидаясь жалоб. - Срок действия TLS-сертификата — предупреждение за две недели до истечения. Просроченный сертификат = «ваш сайт небезопасен» у всех сотрудников разом.
- Свободное место на диске — с порогами. Filestore и логи растут незаметно, а забитый диск валит и Odoo, и PostgreSQL.
- Длина очереди почты — Odoo рассылает уведомления и письма из CRM; растущая очередь означает, что письма не уходят.
- Медленные запросы PostgreSQL —
log_min_duration_statementловит запросы, которые начали тормозить, — ранний сигнал проблем с производительностью.
Топ-3 инцидента из практики
Три поломки, которые встречаются чаще всего. Для каждой — симптом, диагностика, фикс.
1. Диск забит filestore и логами.
- Симптом: Odoo отдаёт ошибки, не сохраняются записи, иногда падает PostgreSQL.
- Диагностика:
df -hпоказывает 100% на разделе с данными;du -shпо каталогам находит виновника — разросшийся filestore или гигабайты логов Odoo/nginx. - Фикс: подчистить и настроить ротацию логов (
logrotate), при необходимости расширить диск. В долгую — вынести бэкапы на отдельный том и следить за ростом filestore мониторингом.
2. Воркеры съели всю оперативную память.
- Симптом: сервер тормозит, срабатывает OOM-killer, Odoo периодически «отваливается» под нагрузкой.
- Диагностика:
free -mиhtopпоказывают, что процессы Odoo сожрали память; в конфиге не выставлены лимиты. - Фикс: задать
limit_memory_softиlimit_memory_hard, а также разумное числоworkersпод реальный объём RAM. Воркер, перешагнувший hard-лимит, корректно перезапускается вместо того, чтобы утащить сервер в своп.
3. «Письма перестали уходить» после смены пароля SMTP.
- Симптом: уведомления и письма из CRM не доходят, очередь исходящей почты растёт.
- Диагностика: в логах Odoo — ошибки аутентификации SMTP; чаще всего это следствие смены пароля на почтовом ящике, про который забыли обновить настройки исходящего сервера в Odoo.
- Фикс: обновить пароль в настройках исходящего почтового сервера, отправить тестовое письмо, разгрести накопившуюся очередь. Профилактика — мониторинг длины очереди, который ловит это в первый же час.
Отдельно следите за тихими падениями плановых задач
Самое коварное в системе со складом и закупками — это беззвучно падающие плановые задачи (cron). Упавшее правило автоматического пополнения запасов не создаёт черновик заказа поставщику, и об этом узнают через пару недель, когда склад уже пуст, а поставка едет месяц. Поэтому в мониторинг стоит добавить отдельную проверку: искать в логе строки ERROR и Traceback рядом с модулем планировщика заданий — любое совпадение должно сразу уходить алертом, а не тонуть среди прочих записей лога.
План восстановления при аварии: RTO/RPO и порядок действий
Отдельно стоит проговорить не только как делать бэкапы, но и что конкретно делать, когда сервер уже погиб — диск, гипервизор или шифровальщик, неважно. Для бизнеса до 50 рабочих мест реалистичная цель — восстановление за 2–4 часа (RTO) с потерей данных не больше суток (RPO), то есть до последнего ночного бэкапа. Порядок действий стоит отработать заранее, а не изобретать в панике:
- Оценка ситуации: если жив гипервизор — откат на снапшот и накат свежего дампа поверх; если площадка потеряна целиком — поднимаем новую VM из готового шаблона (Odoo + PostgreSQL + nginx).
- Забираем последний комплект бэкапа с внешнего хранилища, пересоздаём базу и восстанавливаем дамп через
pg_restore, затем возвращаем каталог filestore на место с правильными правами и запускаем службу. - Проверка перед открытием доступа: вход администратором, складские остатки совпадают с вчерашним вечером, вложения к последним документам открываются, отложенные задачи — в статусе «готово к запуску».
- Переключение DNS или проброса на новый сервер и понятное объявление пользователям, за какой день данные восстановлены.
Отдельное правило для копии, которая поднимается не вместо прода, а рядом с ним — например, стейджинг для разбора инцидента: её обязательно нейтрализуют штатной командой odoo-bin neutralize, иначе копия начинает жить как боевая система — рассылает письма клиентам и порождает закупки по правилам автопополнения склада.
Производительность на горизонте 2–3 лет
Свежеразвёрнутая Odoo на небольшой базе летает. Но система живёт годами, база растёт, и через два-три года «то же самое» начинает подтормаживать. Разберём, что с этим делать — и, что важнее, чего делать не надо.
Обслуживание базы: VACUUM и reindex
PostgreSQL умеет обслуживать себя автоматически (autovacuum), и на большинстве нагрузок этого достаточно. Но по мере роста и активной перезаписи данных иногда требуется вмешательство руками: полный VACUUM для возврата места после массовых удалений, REINDEX для раздувшихся индексов, регулярный ANALYZE для актуальной статистики планировщика. Это не рутина «каждую неделю», а точечная мера, когда мониторинг медленных запросов показывает деградацию. Делается в окно низкой нагрузки, после бэкапа.
Архивация вместо удаления
Старые лиды и закрытые сделки со временем превращаются в балласт: они замедляют выборки и раздувают отчёты, хотя в оперативной работе не нужны. Правильный ход — не удалять их (данные могут понадобиться для аналитики или по закону), а архивировать. В Odoo есть штатный механизм архивации записей: заархивированные лиды исчезают из рабочих списков, но остаются в базе и доступны по фильтру. Воронка становится легче и чище, а история сохраняется.
Когда выносить PostgreSQL на отдельный сервер
До определённого масштаба Odoo и PostgreSQL прекрасно живут на одном VPS. Но ближе к потолку в 50 рабочих мест с активной одновременной работой они начинают конкурировать за одни и те же ресурсы — процессор и память делятся между приложением и СУБД. Тогда мы выносим PostgreSQL на отдельный VPS: база получает свои ресурсы, приложение — свои, и оба перестают друг другу мешать. Это плановое архитектурное решение, а не экстренная мера, — принимается по данным мониторинга, когда видно приближение к пределу.
Регламент сопровождения одним листом
Соберу весь разговор в компактный регламент — то, что мы фактически делаем на сопровождении и что можно взять за основу, даже если вы обслуживаете систему сами. Разбивка по частоте, чтобы ничего не потерялось.
| Периодичность | Что делаем |
|---|---|
| Ежедневно | Автоматический трёхуровневый бэкап (pg_dump + filestore, шифрованная выгрузка наружу); мониторинг доступности, диска, очереди почты, TLS |
| Еженедельно | Разбор логов Odoo/nginx/PostgreSQL; установка security-обновлений ОС; проверка, что бэкапы реально пишутся |
| Ежемесячно | Тестовое восстановление бэкапа на staging; аудит пользователей и прав (уволенные, «мёртвые души», лишний админ); минорное обновление образа Odoo при необходимости |
| Ежегодно | Решение о мажорном апгрейде версии (нужен ли, OpenUpgrade + портирование модулей, отдельный проект); ревизия архитектуры и производительности |
Сколько это стоит по времени
Честная оценка трудозатрат: сопровождение одной системы Odoo до 50 рабочих мест — это примерно 2–4 часа работы инженера в месяц в штатном режиме, без учёта разовых проектов вроде мажорного апгрейда. Сюда входит контроль бэкапов, реакция на алерты мониторинга, security-обновления, ежемесячный тестовый restore и аудит прав.
Сравните это с ежемесячной подпиской на облачную CRM, которая на 20–50 пользователях набегает в заметную сумму и растёт с каждым новым сотрудником — а вопросами бэкапов, локализации ПДн и тонкой настройки под ваш процесс вы всё равно управляете не полностью. Self-hosted Odoo на сопровождении — это предсказуемые часы инженера против непредсказуемо растущей подписки, плюс полный контроль над своими данными.
Если у вас уже крутится Odoo и вы не уверены, что бэкапы восстановятся, а менеджер баз закрыт от посторонних, — мы проведём аудит и возьмём систему на сопровождение по этому самому регламенту. Разворачиваем Odoo под ключ, настраиваем безопасность и резервное копирование, держим инфраструктуру в российском дата-центре МТС. Пишите в Telegram @ITfresh_Boss или звоните +7 903 729-62-41 — разберём вашу ситуацию без обязательств.
Оставить комментарий