
Почему события SSE через nginx приходят пачкой в самом конце
Приложение честно шлёт события каждые двести миллисекунд, в логах бэкенда всё видно, а в браузере прогресс-бар стоит на нуле — и через сорок секунд разом падают все накопленные сообщения. Виноват почти всегда не код, а nginx между ними. Ниже — как именно он это делает, какой конфиг я ставлю на боевых стендах, где эта схема ломается второй и третий раз подряд, и как за десять минут понять, кто из пяти слоёв буферит ваш поток.
Что на самом деле происходит между приложением и браузером
Ситуация узнаваемая до зубовного скрежета. Разработчик открывает вкладку, жмёт «Сформировать отчёт», в консоли браузера EventSource в состоянии OPEN. В логах бэкенда видно: события уходят, по одному каждые двести миллисекунд, сто восемьдесят семь штук. В браузере — ровно ничего. Сорок секунд тишины, потом одним махом прилетают все сто восемьдесят семь, и почти сразу соединение закрывается. Локально, на dev-сервере без прокси, всё летает. Разница ровно одна: на бою перед приложением стоит nginx.
Дальше обычно начинается охота не на того зверя. Правят таймауты в приложении, меняют sync-воркер на async, добавляют flush() после каждого write, читают про Nagle и TCP_NODELAY. Всё мимо. Причина написана прямым текстом в официальной документации модуля ngx_http_proxy_module, в описании директивы proxy_buffering: по умолчанию она включена. И пока она включена, nginx работает не как труба, а как накопитель.
Формулировка из русской документации nginx: «Если буферизация включена, то nginx принимает ответ проксируемого сервера как можно быстрее, сохраняя его в буферы, заданные директивами proxy_buffer_size и proxy_buffers. Если ответ не вмещается целиком в память, то его часть может быть записана на диск во временный файл». Проще говоря — nginx забирает у апстрима данные так быстро, как может, складывает их в память, а клиенту отдаёт, когда буфер набрался или когда апстрим закрыл ответ. Дефолты буферов тоже в мануале: proxy_buffer_size — 4k или 8k в зависимости от платформы, proxy_buffers — 8 буферов того же размера. То есть под ответ отведено порядка тридцати двух — шестидесяти четырёх килобайт памяти, а всё, что сверху, уедет во временный файл в proxy_temp_path.
Теперь считаем. Типичное SSE-событие с прогрессом — это строки event: progress, data: {"done":142,"total":15000} и пустая строка. Байт семьдесят-восемьдесят. Чтобы набить первый четырёхкилобайтный буфер, нужно около полусотни таких событий. При частоте пять событий в секунду это десять секунд до первого байта у клиента. А если события мельче или реже — полминуты, минута, сколько угодно. И «пачкой в конце» они приходят потому, что закрытие соединения с апстримом заставляет nginx сбросить всё, что он накопил, независимо от заполненности буфера.
- Симптом не зависит от языка бэкенда: одинаково ловится на FastAPI, Django+ASGI, Node, PHP-FPM и Spring.
- Локально не воспроизводится — потому что локально вы ходите на порт приложения напрямую.
- Это не Nagle: tcp_nodelay в nginx по умолчанию уже on.
- Это не keepalive и не «медленный питон» — данные до nginx доходят вовремя, что видно по curl напрямую в апстрим.
- Размер задержки прямо пропорционален размеру буфера и обратно — размеру и частоте событий.
Разбор из практики: трикотажное производство «ТрикоДом», 39 рабочих мест
Клиент — трикотажное производство «ТрикоДом», 39 рабочих мест: цех, склад пряжи и полотна, снабжение, бухгалтерия. Внутренний портал на FastAPI под uvicorn, перед ним nginx из стабильной ветки на Debian 12, TLS терминируется там же. Есть тяжёлая операция: выгрузка номенклатуры из 1С в портал — модели, размерные сетки, артикулы пряжи, около восьми тысяч позиций, две-четыре минуты работы. Чтобы технолог или менеджер не сидел в неведении, сделали SSE-эндпоинт /api/jobs/{id}/stream с прогрессом.
Жалоба пришла не от разработчика, а от снабжения и бухгалтерии: «выгрузка не работает, ничего не происходит». Прогресс-бар честно стоял на нуле, люди ждали секунд двадцать и жали «Выгрузить» ещё раз. И ещё. По журналу задач выходило в среднем 3,2 запуска на одну реальную выгрузку. Три параллельные выгрузки в 1С на небольшом сервере — это уже блокировки в регистрах, rphost на ста процентах одного ядра и звонки «1С тормозит» из цеха, где в это же время проводят выпуск продукции. То есть невинная буферизация в прокси превратилась в деградацию учётной системы.
Диагностика заняла минут пятнадцать. Сначала curl без буферизации прямо в uvicorn на 127.0.0.1:8080 — события капают ровно как задумано, по пять в секунду. Тот же curl через nginx по HTTPS — тишина около тридцати секунд, потом простыня. Дальше смотрим заголовки ответа: Content-Encoding: gzip. То есть буферило не в один слой, а в два — сам proxy_buffering и модуль gzip, которому кто-то заботливо добавил text/event-stream в gzip_types вместе с application/json.
И третья находка, ради которой я вообще люблю разбирать такие кейсы. В приложении уже был выставлен заголовок X-Accel-Buffering: no — предыдущий подрядчик прочитал ту же статью, что и вы сейчас. Не работало. Потому что в http-блоке, этажом выше, стояла строка proxy_ignore_headers X-Accel-Expires X-Accel-Buffering Expires Cache-Control;. Её поставили когда-то в борьбе с кэшированием статики. Директива унаследовалась во все server и location, и nginx честно, по документации, игнорировал заголовок приложения. Мануал об этой возможности прямо предупреждает: «Эту возможность можно запретить с помощью директивы proxy_ignore_headers».
Итог после правки: время до первого события у клиента — около 100 миллисекунд вместо тридцати секунд. Среднее число запусков на одну выгрузку упало с 3,2 до 1,05. Пиковая нагрузка на rphost 1С в рабочие часы снизилась примерно втрое, потому что исчезли паразитные параллельные выгрузки. Ни строчки в коде приложения при этом не тронули — только конфиг nginx и снятие лишнего proxy_ignore_headers.
- Было: первое событие через 28–35 с, gzip поверх SSE, X-Accel-Buffering игнорировался глобальной директивой.
- Стало: отдельный location под стрим, proxy_buffering off, gzip off, proxy_read_timeout 3600s, heartbeat раз в 15 с.
- Побочный эффект: примерно минус две трети паразитной нагрузки на сервер 1С.
- Время работ — около часа вместе с тестами и перезагрузкой конфига.
Конфиг, который я ставлю под SSE
Главный принцип: не выключать буферизацию глобально. Для обычных JSON-ручек и статики буферизация полезна — она прикрывает медленных клиентов, экономит соединения к апстриму и позволяет nginx быстрее освободить бэкенд. Выключать её надо точечно, в location, который отдаёт поток. Вот блок, который я копирую из проекта в проект:
location /api/jobs/ {
    proxy_pass http://127.0.0.1:8080;

    # явно нужно на nginx до 1.29.7 (там дефолт 1.0)
    proxy_http_version 1.1;
    proxy_set_header Connection "";

    # собственно лечение
    proxy_buffering off;
    proxy_cache off;
    gzip off;
    chunked_transfer_encoding on;
    add_header Cache-Control no-cache;

    # поток живёт долго
    proxy_read_timeout 3600s;
    send_timeout 3600s;

    proxy_set_header Host $host;
    proxy_set_header X-Real-IP $remote_addr;
    proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
    proxy_set_header X-Forwarded-Proto $scheme;
}
Построчно. proxy_buffering off — то самое: «Если буферизация выключена, то ответ синхронно передаётся клиенту сразу же по мере его поступления. nginx не пытается считать весь ответ проксируемого сервера». Важная оговорка из того же абзаца мануала: proxy_buffer_size при выключенной буферизации не исчезает, он задаёт «максимальный размер данных, который nginx может принять от сервера за один раз». Уменьшать его ради «ещё меньшей задержки» бессмысленно, увеличивать — тоже. add_header Cache-Control no-cache — страховка на случай, если приложение забыло этот заголовок, а по дороге стоит кэширующий посредник; если приложение его уже отдаёт, строку можно убрать, чтобы не получить дубль.
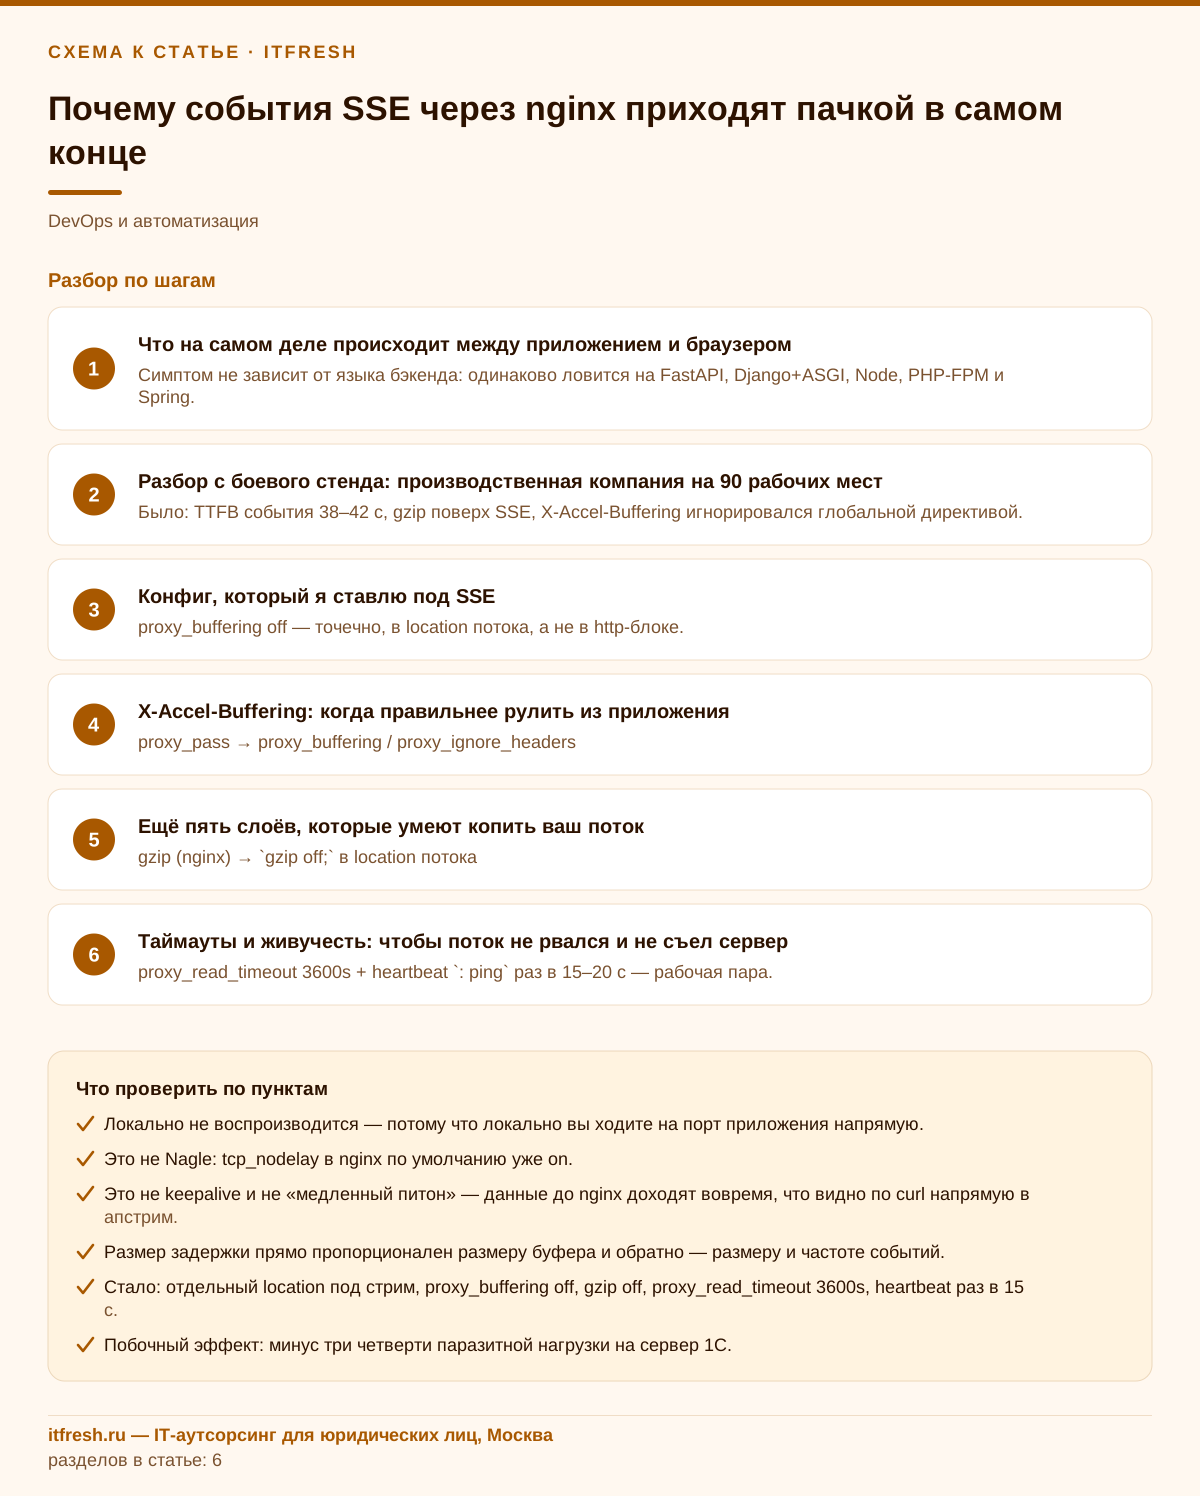
proxy_http_version 1.1 и пустой Connection. Тут в 2026 году есть нюанс, который многие пропустили: в nginx 1.29.7 (24 марта 2026) поведение изменилось — в changelog записано «now ngx_http_proxy_module supports keepalive by default; the default value for proxy_http_version is 1.1; the Connection proxy header is not sent by default anymore». Стабильная ветка 1.30 это унаследовала, и на свежих сборках эти две строки уже не нужны. Но в репозиториях Debian 12 и Ubuntu 22.04 живут 1.22 и 1.18, где к апстриму по умолчанию уходит HTTP/1.0 с Connection: close. Сам nginx при proxy_buffering off отдаст клиенту и такой ответ по мере поступления, но апстрим на запрос HTTP/1.0 не имеет права отвечать chunked и вынужден сигнализировать конец тела закрытием соединения — часть серверов приложений и middleware в таком режиме ведут себя иначе, а keepalive к апстриму не работает вовсе. Пишу явно — стоит копейки, спасает от «а почему на другом сервере не работает». Пустой Connection "" нужен ровно затем, чтобы nginx до 1.29.7 не передавал апстриму close.
gzip off — про это ниже отдельно, но в двух словах: сжатый поток отдаётся порциями по мере наполнения gzip-буфера, а он по умолчанию 32 4k|16 8k (директива gzip_buffers задаётся только на уровне http), то есть заметно больше одного события. proxy_cache off — кэшировать бесконечный ответ нельзя в принципе, а если у вас в server-блоке включён общий proxy_cache, стрим-локейшн надо из него явно выключить. chunked_transfer_encoding on — это дефолт модуля ngx_http_core_module, я пишу его как страховку от чужих правок: без chunked nginx не сможет отдать клиенту по HTTP/1.1 ответ неизвестной длины иначе как с закрытием соединения. По HTTP/2 chunked не используется вовсе — там данные идут DATA-фреймами, и эта директива на h2-клиентов не влияет.
Отдельно про postpone_output. В ядре у него дефолт 1460 байт: «If possible, the transmission of client data will be postponed until nginx has at least size bytes of data to send». Звучит как виновник, и в интернете его регулярно советуют ставить в ноль. По моему опыту — в подавляющем большинстве случаев он не нужен: при выключенной proxy_buffering данные уходят по мере получения и так. Я добавляю postpone_output 0; только если после всех правок первое событие всё ещё заметно запаздывает и события совсем крошечные, меньше сотни байт. Считайте это шестым пунктом чек-листа, а не первым.
- proxy_buffering off — точечно, в location потока, а не в http-блоке.
- proxy_cache off — обязательно, если кэш включён уровнем выше.
- gzip off — второй по частоте виновник после буферизации.
- proxy_http_version 1.1 и Connection "" — пишем явно, если версия nginx младше 1.29.7.
- proxy_read_timeout и send_timeout — под реальную длительность операции, но только вместе с heartbeat.
- postpone_output 0 — опционально, по факту замера, а не «на всякий случай».
X-Accel-Buffering: когда правильнее рулить из приложения
Иногда location один, а ручек в нём много: и обычные JSON-ответы, и стрим. Городить регулярку под каждый путь — плохая идея, конфиг быстро становится нечитаемым. В этом случае решение принимает само приложение, отдавая в ответе заголовок X-Accel-Buffering: no. Возможность появилась ещё в nginx 1.1.6 и описана в мануале: «Буферизация может быть также включена или выключена путём передачи “yes” или “no” в поле “X-Accel-Buffering” заголовка ответа. Эту возможность можно запретить с помощью директивы proxy_ignore_headers».
На практике это одна строка. В Python на FastAPI/Starlette — StreamingResponse(gen(), media_type="text/event-stream", headers={"X-Accel-Buffering": "no", "Cache-Control": "no-cache"}). В PHP — header('X-Accel-Buffering: no'); до первого вывода. В Node на Express — res.setHeader('X-Accel-Buffering', 'no'). Поля X-Accel-* nginx по умолчанию не передаёт клиенту (это описано в proxy_hide_header), так что до браузера заголовок не доходит, так что бояться его нечего.
Две ловушки, на которых спотыкаются регулярно. Первая — уже описанный proxy_ignore_headers; полный список того, что им можно выключить, в мануале такой: X-Accel-Redirect, X-Accel-Expires, X-Accel-Limit-Rate, X-Accel-Buffering, X-Accel-Charset, Expires, Cache-Control, Set-Cookie и Vary. Если в вашем конфиге эта директива перечисляет заголовки списком, проверьте, не попал ли туда X-Accel-Buffering за компанию.
Вторая ловушка — не тот модуль. Если сайт крутится на PHP-FPM, то между nginx и приложением не proxy, а fastcgi. И правит там всё директива fastcgi_buffering (появилась в 1.5.6, дефолт on), а игнорирование заголовков — fastcgi_ignore_headers. Классика жанра: человек полдня добавляет proxy_buffering off в конфиг php-сайта, где нет ни одного proxy_pass, и не понимает, почему ничего не меняется. Ровно те же пары существуют для uwsgi_buffering и scgi_buffering.
Что выбирать? Я предпочитаю комбинацию: в конфиге явный proxy_buffering off для очевидно потокового пути, плюс заголовок из приложения как страховка на случай, если кто-то раскатает конфиг из шаблона и затрёт location. Дублирование здесь безвредно — оба механизма ведут к одному результату, и заголовок просто подтверждает то, что уже выключено.
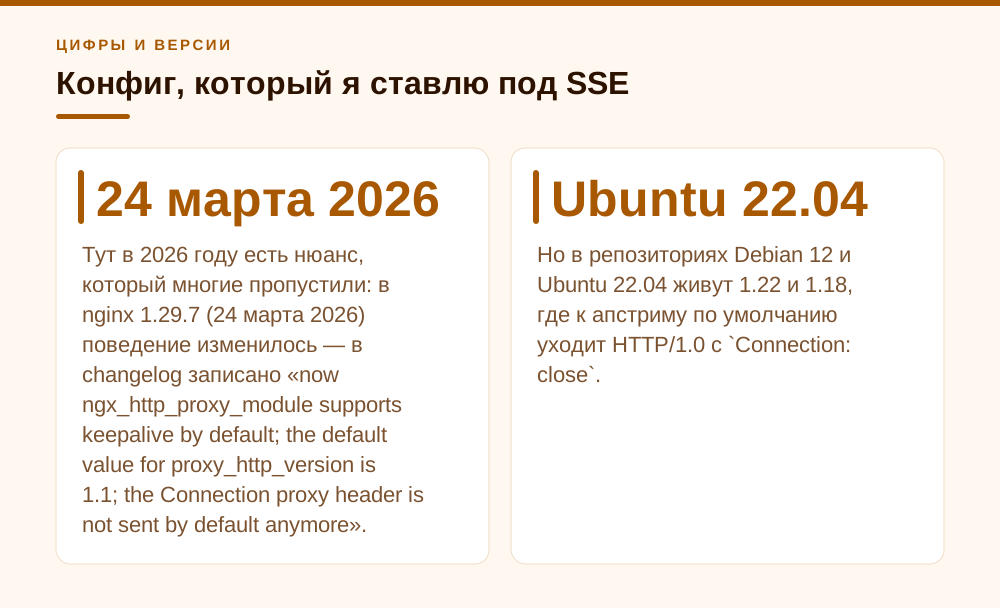
- proxy_pass → proxy_buffering / proxy_ignore_headers
- fastcgi_pass (PHP-FPM) → fastcgi_buffering / fastcgi_ignore_headers
- uwsgi_pass → uwsgi_buffering / uwsgi_ignore_headers
- scgi_pass → scgi_buffering / scgi_ignore_headers
Ещё пять слоёв, которые умеют копить ваш поток
Выключили proxy_buffering, а всё равно пачками? Значит, буферит кто-то ещё. По моей статистике вызовов порядок такой.
Первое — gzip, свой или апстрима. Модуль сжатия набивает свои буферы (gzip_buffers 32 4k|16 8k) и отдаёт порцию, когда есть что отдать. На потоке мелких событий это ровно та же болезнь, только этажом выше. Диагностируется мгновенно: curl -sN -D- .../stream | head и смотрим, есть ли в заголовках Content-Encoding. Лечится gzip off в location. Если апстрим сжимает сам — уберите Accept-Encoding в сторону бэкенда: proxy_set_header Accept-Encoding "";.
Второе — само приложение. Тут зоопарк. PHP держит вывод в output buffering, пока не сделаешь ob_implicit_flush(true) и не выгребешь существующие уровни через ob_end_flush. Gunicorn с синхронным воркером на длинный стрим вообще не рассчитан — нужен gevent, uvicorn или ASGI-воркер. В Node популярный compression() middleware буферит точно так же, как nginx-овый gzip, и его нужно отключать для стрим-роутов. В Spring поток через ResponseBodyEmitter упирается в буфер контейнера. Проверка одна и та же: curl напрямую в порт приложения, минуя всё.
Третье — второй прокси в цепочке. Типичная схема у небольших компаний — HAProxy или облачный балансировщик на периметре, за ним nginx, за ним приложение. HAProxy ответы по умолчанию не копит, но если у него включено compression или стоит короткий timeout server/timeout tunnel, поведение будет похоже на буферизацию или на обрывы. То же с Traefik, с корпоративным Squid и с CDN, где для стриминга обычно нужен отдельный режим. Спецификация HTML прямо предупреждает: chunked-кодирование, которое делает промежуточный слой, не знающий о требованиях к таймингу потока, может ухудшать надёжность SSE. Правило простое: разбирать цепочку с конца, от приложения к браузеру, добавляя по одному звену.
Четвёртое — то, что стоит у пользователя. Корпоративный антивирус с проверкой HTTPS-трафика (тот же Kaspersky Web Traffic Security или любой MITM-фильтр) вынужден собрать ответ, чтобы его просканировать. Это классика: «у всех работает, а у главбуха нет». Здесь nginx ни при чём, и лечится это исключением адреса портала из SSL-инспекции.
Пятое — не буферизация, но выглядит похоже: лимит соединений в браузере. По HTTP/1.1 Chrome и Firefox держат максимум шесть соединений на хост, а открытый SSE занимает одно из них на всё время жизни вкладки. Спецификация HTML в разделе про Server-sent events отдельно отмечает, что клиенты с ограничением числа соединений на сервер могут столкнуться с проблемами, если несколько страниц сайта открывают EventSource к одному домену. Три-четыре вкладки портала — и весь домен встаёт колом, включая обычные запросы. Лечится переходом на HTTP/2: директива http2 on; появилась в nginx 1.25.1 и заменила старый параметр listen ... http2. Внутри одного h2-соединения стримы мультиплексируются, и проблема исчезает; второй вариант из спецификации — общий SharedWorker на все вкладки.
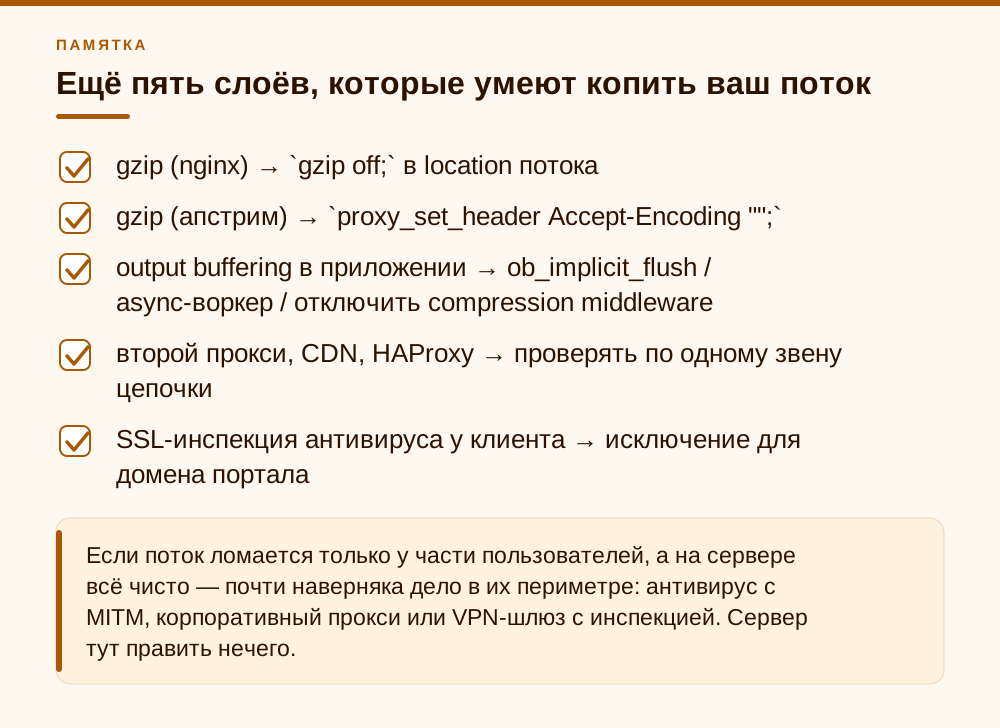
- gzip (nginx) → `gzip off;` в location потока
- gzip (апстрим) → `proxy_set_header Accept-Encoding "";`
- output buffering в приложении → ob_implicit_flush / async-воркер / отключить compression middleware
- второй прокси, CDN, HAProxy → проверять по одному звену цепочки
- SSL-инспекция антивируса у клиента → исключение для домена портала
- лимит 6 соединений HTTP/1.1 → `http2 on;` (nginx 1.25.1+)
Таймауты и живучесть: чтобы поток не рвался и не съел сервер
Второй по частоте вопрос после «почему пачкой» — «почему ровно через минуту рвётся». Ответ в дефолтах: proxy_read_timeout равен 60s, send_timeout тоже 60s. Первый, по мануалу, задаётся «между двумя операциями чтения» от проксируемого сервера, второй — между двумя операциями записи клиенту, а не на весь ответ. То есть если ваше приложение думает больше минуты между событиями — nginx закрывает соединение с апстримом, а браузер получает обрыв и через несколько секунд переподключается.
Правильное лечение — не только поднять таймаут, но и добавить heartbeat в приложении. В SSE для этого есть штатный механизм: по спецификации HTML строка, начинающаяся с двоеточия (U+003A COLON), клиентом игнорируется. Шлём : ping с пустой строкой раз в 15–20 секунд, и соединение никогда не простаивает дольше этого интервала. Это не моя придумка: в авторских заметках к разделу Server-sent events прямо сказано, что устаревшие прокси-серверы могут рвать соединения после короткого таймаута, и для защиты рекомендуется слать строку-комментарий примерно каждые 15 секунд. После этого proxy_read_timeout можно спокойно ставить в 3600s — он будет страховать от реально зависшего бэкенда, а не резать живой поток.
Дальше — арифметика, про которую забывают. SSE-соединение висит постоянно, и на каждое клиентское соединение nginx держит соединение к апстриму. Сорок сотрудников, у каждого портал открыт в двух-трёх вкладках, — это под сотню живых соединений весь рабочий день. Для nginx это ерунда (worker_connections по умолчанию 512, поднимается до десятков тысяч), а вот для gunicorn с четырьмя sync-воркерами это мгновенная смерть: все воркеры заняты, обычные запросы не обслуживаются. Под стрим нужен асинхронный сервер приложений и трезвая оценка максимума одновременных потоков.
И про восстановление. EventSource в браузере переподключается сам: начальная задержка определяется браузером (обычно несколько секунд), сервер меняет её полем retry: в миллисекундах, а при переподключении браузер присылает заголовок Last-Event-ID со значением последнего полученного поля id:. Если нумеровать события и уметь продолжить с места обрыва, получается пятнадцать строк кода, которые превращают «прогресс-бар слетел, начинаем заново» в незаметное для пользователя переподключение. И обратный рычаг: ответ сервера со статусом 204 No Content останавливает попытки переподключения — удобно, когда задача уже завершена и клиенту больше нечего ждать.
Честно про спорное. Иногда мне говорят: «перепишите на WebSocket, там таких проблем нет». Проблемы там другие. SSE — это обычный HTTP-ответ с типом text/event-stream, и nginx проксирует его как любой другой ответ: к нему применяются proxy_buffering, gzip, proxy_cache. WebSocket — смена протокола: клиент шлёт Upgrade, апстрим отвечает 101 Switching Protocols, и nginx (с версии 1.3.13) превращает соединение в двунаправленный туннель, где буферизация и gzip уже не участвуют. Но поскольку Upgrade и Connection — hop-by-hop заголовки, их надо передать апстриму явно, иначе рукопожатие не состоится.
location /ws/ {
    proxy_pass http://127.0.0.1:8080;
    proxy_http_version 1.1;          # до 1.29.7
    proxy_set_header Upgrade $http_upgrade;
    proxy_set_header Connection "upgrade";
    proxy_read_timeout 3600s;        # таймаут действует и на туннель
}
Обратите внимание на разницу в заголовке Connection: для SSE мы его очищаем (""), для WebSocket — наоборот, выставляем upgrade. Скопировать WebSocket-блок на SSE-эндпоинт — частая ошибка: рукопожатия там никто не просит, а буферизацию этот блок не выключает. proxy_read_timeout при этом действует и на WebSocket-туннель, так что без пингов (на уровне WebSocket-фреймов) он оборвётся через ту же минуту. Для одностороннего прогресса я остаюсь на SSE: проще, сам переподключается и не требует отдельного протокола. Если же нужна двусторонняя связь или вы застряли на HTTP/1.1 с множеством вкладок — WebSocket уместнее. Единого правильного ответа нет, решает контекст.
- proxy_read_timeout 3600s + heartbeat `: ping` раз в 15–20 с — рабочая пара.
- proxy_read_timeout 24h без heartbeat — плохая идея: зависшие соединения копятся месяцами.
- `id:` в событиях + обработка Last-Event-ID — бесшовный реконнект.
- `retry: 5000` — управляем частотой переподключения с сервера.
- Считайте максимум одновременных потоков и подбирайте под него сервер приложений.
- SSE ≠ WebSocket: для SSE `Connection "«` и proxy_buffering off, для WebSocket — `Upgrade $http_upgrade` и `Connection »upgrade"`.
- 204 No Content в ответ на переподключение — штатный способ сказать EventSource «больше не приходи».
Чек-лист на десять минут и приоритеты
Порядок действий, который я держу в голове и который закрывает почти сто процентов обращений. Он линейный, каждый шаг отсекает половину вариантов.
# 1. Мимо nginx, прямо в приложение
curl -N -H 'Accept: text/event-stream' http://127.0.0.1:8080/api/jobs/42/stream

# 2. Через nginx, с заголовками ответа
curl -sN --http1.1 -D- -H 'Accept: text/event-stream' \
     https://portal.example.com/api/jobs/42/stream | head -40

# 3. Что реально собрано в конфиге (не в одном файле, а во всех)
nginx -T | grep -nE 'proxy_buffering|fastcgi_buffering|ignore_headers|gzip|proxy_cache|postpone_output|proxy_read_timeout'

# 4. Применить и проверить
nginx -t && systemctl reload nginx
Читаем результат так. Если на шаге 1 события не капают — идите в приложение, nginx ни при чём. Если капают, а на шаге 2 тишина — виноват прокси, и дальше смотрим заголовки из шага 2: Content-Encoding: gzip означает сжатие; отсутствие Content-Type: text/event-stream — что приложение отдаёт поток не тем типом, и EventSource его вообще не примет; Transfer-Encoding: chunked при ответе по HTTP/1.1 — нормальная картина, а его отсутствие вместе с Content-Length говорит, что ответ кто-то собрал целиком. Наличие X-Accel-Buffering в ответе клиенту означает, что nginx его не обработал — скорее всего, заголовок прошёл через другой прокси-слой или вовсе не через nginx. Шаг 3 показывает всю собранную конфигурацию, включая инклюды из conf.d, — именно там всплывают чужие ignore_headers и глобальный gzip.
На что я бы не тратил время в первые полчаса. На postpone_output — эффект есть, но редко и мал. На tcp_nodelay — он и так on. На sendfile — он про отдачу файлов с диска и к проксированию отношения не имеет. На тюнинг worker_processes и worker_connections — если у вас не тысячи одновременных потоков, дефолты справляются. И на переписывание SSE в WebSocket — это последний шаг, а не первый.
На что потратить обязательно: отдельный location под стрим, heartbeat в приложении, реконнект по Last-Event-ID и мониторинг числа живых соединений на этом location. Первые два пункта закрывают саму проблему, вторые два — делают так, чтобы она не вернулась через месяц в виде «сервер приложений не отвечает». По моему опыту, вся связка ставится за час и потом годами не требует внимания.
- Шаг 1 — curl в апстрим напрямую. Отсекает приложение.
- Шаг 2 — curl через nginx с `-D-` и `--http1.1`. Показывает gzip, Content-Type, chunked.
- Шаг 3 — `nginx -T | grep`. Показывает то, что реально собрано, а не то, что вы редактировали.
- Шаг 4 — правка location, `nginx -t`, reload.
- Шаг 5 — heartbeat и таймауты.
- Шаг 6 — при необходимости http2 on и Last-Event-ID.
Частые вопросы
Можно ли просто написать proxy_buffering off в http-блоке и забыть?
Технически можно, но я не советую. Буферизация — не баг, а полезная функция: она защищает бэкенд от медленных клиентов и позволяет nginx быстро освободить воркер приложения. Выключив её глобально, вы заставите каждое подвисшее мобильное соединение удерживать соединение к апстриму на всё время скачивания. Выключайте точечно, в location, который отдаёт поток.
Я поставил X-Accel-Buffering: no, а ничего не изменилось. Почему?
Три типовые причины. Первая — где-то выше по конфигу стоит proxy_ignore_headers с этим полем в списке, и nginx его штатно игнорирует. Вторая — вы работаете через fastcgi_pass (PHP-FPM), а правите proxy_-директивы: там нужны fastcgi_buffering и fastcgi_ignore_headers. Третья — буферит не nginx, а gzip, второй прокси в цепочке или само приложение. Проверяйте через `nginx -T | grep ignore_headers` и curl напрямую в апстрим.
Нужно ли ставить proxy_http_version 1.1 в 2026 году?
В nginx 1.29.7 (март 2026) это стало значением по умолчанию, и на свежих сборках, включая стабильную ветку 1.30, строка избыточна. Но в репозиториях Debian 12 и Ubuntu 22.04 до сих пор nginx 1.22 и 1.18, где к апстриму по умолчанию уходит HTTP/1.0 с Connection: close: апстрим не может отвечать chunked, keepalive к нему не работает, а часть серверов приложений ведёт себя в таком режиме иначе. Пишите `proxy_http_version 1.1` и `proxy_set_header Connection ""` явно — это ничего не стоит и снимает разницу между стендами.
Почему SSE-соединение рвётся ровно через 60 секунд?
Это дефолт proxy_read_timeout — 60s, отсчитываемый между двумя операциями чтения от апстрима. Если приложение молчит дольше минуты, nginx закрывает соединение. Правильное решение — heartbeat в приложении (строка-комментарий `: ping` раз в 15–20 секунд; спецификация HTML сама рекомендует комментарий примерно каждые 15 секунд) плюс увеличенный proxy_read_timeout. Только таймаут поднимать нельзя: получите вместо обрывов вечно висящие соединения.
У всех работает, а у одного пользователя события всё равно приходят пачкой. Что делать?
Почти наверняка это его периметр. Корпоративный антивирус с проверкой HTTPS, MITM-прокси или VPN-шлюз с инспекцией трафика вынужден собрать ответ целиком, чтобы его просканировать, — и получается ровно та же буферизация, только на стороне клиента. Лечится исключением домена портала из SSL-инспекции. На сервере тут править нечего.
SSE или WebSocket для прогресс-бара?
Для одностороннего потока «сервер → браузер» я выбираю SSE: он проще, идёт поверх обычного HTTP, штатно переподключается и не требует особой поддержки в прокси. WebSocket оправдан, если нужна двусторонняя связь или если вы не можете включить HTTP/2 и упираетесь в лимит шести соединений на хост при нескольких открытых вкладках. Единого правильного ответа тут нет — смотрите на свой контекст.
Можно ли для SSE взять конфиг от WebSocket с Upgrade и Connection upgrade?
Нет, это разные механизмы. WebSocket — смена протокола с ответом 101, после которой nginx держит туннель; для этого и нужны `Upgrade $http_upgrade` и `Connection "upgrade"`. SSE — обычный длинный HTTP-ответ с типом text/event-stream, к которому по-прежнему применяются proxy_buffering и gzip. WebSocket-блок на SSE-эндпоинте буферизацию не выключит. Для SSE нужны proxy_buffering off (или X-Accel-Buffering: no), gzip off, пустой Connection и увеличенный proxy_read_timeout.
Источники
- nginx.org/ru, модуль ngx_http_proxy_module — proxy_buffering (умолчание on; «Если буферизация выключена, то ответ синхронно передаётся клиенту…», X-Accel-Buffering), proxy_buffer_size 4k|8k, proxy_buffers 8 4k|8k, proxy_ignore_headers (X-Accel-Buffering с 1.1.6), proxy_read_timeout 60s, proxy_http_version (умолчание 1.1). https://nginx.org/ru/docs/http/ngx_http_proxy_module.html#proxy_buffering
- nginx.org/ru, модуль ngx_http_fastcgi_module — fastcgi_buffering (появилась в 1.5.6, умолчание on) и fastcgi_ignore_headers — аналоги proxy_* для связки nginx + PHP-FPM. https://nginx.org/ru/docs/http/ngx_http_fastcgi_module.html#fastcgi_buffering
- nginx.org/ru, модуль ngx_http_core_module — Умолчания: postpone_output 1460, tcp_nodelay on, chunked_transfer_encoding on, send_timeout 60s. https://nginx.org/ru/docs/http/ngx_http_core_module.html#postpone_output
- nginx.org/ru, модуль ngx_http_gzip_module — gzip off по умолчанию, gzip_types text/html, gzip_buffers 32 4k|16 8k (контекст http). https://nginx.org/ru/docs/http/ngx_http_gzip_module.html
- nginx.org/ru, модуль ngx_http_v2_module — Директива http2 on|off, появилась в версии 1.25.1. https://nginx.org/ru/docs/http/ngx_http_v2_module.html#http2
- nginx.org/ru, Проксирование WebSocket — Туннель при ответе 101 с версии 1.3.13, явная передача hop-by-hop заголовков Upgrade и Connection, proxy_read_timeout для туннеля. https://nginx.org/ru/docs/http/websocket.html
- nginx CHANGES-1.30 — Changes with nginx 1.29.7 (24 Mar 2026): «now ngx_http_proxy_module supports keepalive by default; the default value for proxy_http_version is 1.1; the Connection proxy header is not sent by default anymore». https://nginx.org/en/CHANGES-1.30
- WHATWG HTML Living Standard, 9.2 Server-sent events — Разбор потока (строки с ':' — комментарии), поле retry, заголовок Last-Event-ID, 204 No Content прекращает переподключение, авторские заметки: комментарий каждые ~15 с против прокси, chunking посредников, лимит соединений на сервер. https://html.spec.whatwg.org/multipage/server-sent-events.html
- NGINX Blog: Optimizing Web Servers for High Throughput and Low Latency — Компромисс буферизации (защита бэкенда против задержки, памяти и I/O) и рекомендация отдавать решение приложению через X-Accel-Buffering. https://blog.nginx.org/blog/optimizing-web-servers-for-high-throughput-and-low-latency