
Включил flowtable в nftables — и счётчики в forward почти замерли. Куда делся трафик
Вы добавили flowtable, нагрузка на процессор шлюза упала вдвое, канал наконец держит гигабит — и тут выясняется, что счётчики в цепочке forward показывают тридцать мегабайт там, где реально прошло почти два терабайта. Трафик никуда не делся, просто он больше не проходит через ваши правила. Разберу, как устроен fastpath, почему учёт ломается именно так (и почему счётчики всё-таки не нули), как вернуть корректные цифры через counter в определении flowtable и conntrack, и что ещё перестаёт работать вместе с учётом — а что, вопреки страшилкам, работает нормально.
Счётчики замерли — это не баг и не сбой учёта
Сценарий до боли типовой. Шлюз на Linux, nftables, канал на 500 Мбит/с, вечером softirq выедает ядро целиком и пользователи жалуются на «интернет тормозит». Вы читаете про flowtable, добавляете его в ruleset, ставите flow add @ft в forward — и картина меняется мгновенно: загрузка процессора падает, канал держится, тикеты прекращаются. Через день приходит вопрос от руководителя: почему в отчёте по трафику за сутки 30 мегабайт, если раньше было под два терабайта? И вот тут начинается поиск несуществующей поломки: перепроверяют правила, пересоздают счётчики, грешат на систему мониторинга.
Ломать нечего. Пакет, попавший в flowtable, до цепочки forward просто не доезжает. Формулировка из документации ядра прямая: пакеты, для которых нашлось совпадение в flowtable, передаются на выходной сетевой интерфейс через neigh_xmit(), минуя классический путь IP-форвардинга, и ни один Netfilter-хук после ingress их не видит. (В актуальном коде ядра отправка идёт через dev_hard_header() и dev_queue_xmit(), но суть та же: prerouting, forward и postrouting пропускаются.) Ваш counter живёт в forward. Forward для этих пакетов не выполняется. Счётчик честно считает ровно то, что до него доходит.
Отсюда и характерная картина «почти перестали расти». Не ноль — потому что первый пакет каждого потока всегда идёт классическим путём (иначе некому было бы выполнить flow add), и потому что часть трафика в fastpath принципиально не попадает. В обычном офисном профиле нагрузки на один поток приходятся тысячи пакетов, из которых через forward проезжают единицы. Отсюда расхождение не на проценты, а на три-четыре порядка. Если у вас счётчик упал в тысячу раз — это ровно тот самый эффект, а не «половина трафика потерялась».
Прежде чем чинить, зафиксируйте для себя простую вещь: после включения flowtable counter в forward перестаёт быть счётчиком трафика и становится счётчиком потоков. Это разные метрики с разной ценой ошибки. Правило учёта, на которое смотрит биллинг или отчёт для собственника, после такого изменения врёт молча — никаких ошибок в логах не будет.
- Пакеты потока, найденного в flowtable, не проходят prerouting, forward и postrouting.
- `counter` в forward после `flow add` считает в основном первые пакеты потоков и служебный трафик.
- Ошибок в логах не будет: счётчик работает корректно, изменилась сама метрика.
- Отчёты и триггеры, построенные на forward-счётчиках, начинают занижать объём на порядки.
- Счётчики интерфейсов (`ip -s link`) продолжают показывать реальный объём — это ваша точка сверки.
Куда на самом деле уходит пакет: ingress, flowtable и обход хуков
Flowtable живёт в хуке ingress — то есть до prerouting, в самом начале приёмного тракта. Это принципиально: fastpath стоит раньше conntrack, раньше NAT, раньше всей вашей фильтрации. Схема работы такая. Первый пакет потока идёт полностью классическим путём: ingress (промах в flowtable) → prerouting → routing decision → forward → postrouting. В forward срабатывает ваше правило flow add @ft, которое создаёт запись в flowtable на базе уже существующей записи conntrack. Вики nftables уточняет: запись создаётся после того, как состояние уже есть, то есть обычно её порождает первый ответный пакет. Дальше поток обслуживается в ingress: поиск по кортежу, применение сохранённого NAT-преобразования, декремент TTL/hoplimit, отправка в выходное устройство. Всё. Ни prerouting, ни forward, ни postrouting.
Кортеж поиска в flowtable — входной интерфейс, адреса и порты источника/назначения, протоколы третьего и четвёртого уровня; в записи дополнительно кэшируются выходной интерфейс и адрес шлюза, чтобы обновить MAC-адрес назначения. Это важная деталь: flowtable ведёт себя как кэш маршрутно-канального решения, а не как полноценный форвардинг. В документации ядра прямо сказано, что записи могут протухнуть, если сменится MAC-адрес назначения или выходной интерфейс.
Часть трафика в fastpath не попадает никогда — и именно она даёт остаточный рост счётчиков в forward. Фрагментированный трафик поднимается на классический путь, потому что в нефрагментированном виде нет транспортного заголовка и кортеж не собрать. TCP-пакеты с флагами RST и FIN тоже уходят классическим путём — чтобы поток закрылся аккуратно и запись корректно снялась. Пакеты, превышающие MTU, возвращаются в обычный тракт, чтобы система смогла отправить ICMP packet-too-big.
Есть и потоки, которые в flowtable не попадут вообще, как бы вы ни писали правило. В коде nft_flow_offload.c явно отсеиваются соединения с подключённым conntrack-helper (FTP, SIP и прочие ALG), соединения с корректировкой sequence-номеров, записи с NAT-коллизией, пакеты с security path (то есть IPsec) и IPv4-пакеты с опциями заголовка. Для TCP дополнительно проверяется, что соединение уже в состоянии established. Простой поток без активности выпадает из flowtable по таймауту: net.netfilter.nf_flowtable_tcp_timeout и nf_flowtable_udp_timeout, по умолчанию 30 секунд, после чего возвращается на классический путь и при следующем пакете снова ускоряется.
Практический вывод из этого списка неочевидный, но полезный: по остаточному счётчику в forward можно косвенно судить о профиле трафика. Если после включения flowtable счётчик показывает подозрительно много — скорее всего у вас либо шторм коротких соединений, либо проблема с MTU и лавина ICMP packet-too-big, либо фрагментация от какого-нибудь UDP-туннеля. Я на этом пару раз ловил неверно выставленный MSS на IPsec.
- Первый пакет потока — всегда классический путь, иначе правило `flow add` не отработает.
- Фрагменты идут мимо flowtable: без транспортного заголовка кортеж не построить.
- TCP RST и FIN обрабатываются классическим путём для корректного закрытия потока.
- Пакеты больше MTU возвращаются наверх, чтобы отправить ICMP packet-too-big.
- Не ускоряются потоки с conntrack-helper (FTP, SIP), с seqadj, IPsec-трафик (secpath) и IPv4-пакеты с IP options — это видно в коде `nft_flow_offload.c`.
- Всё остальное — а это подавляющая часть байт — уезжает в ingress и ваших правил не видит.
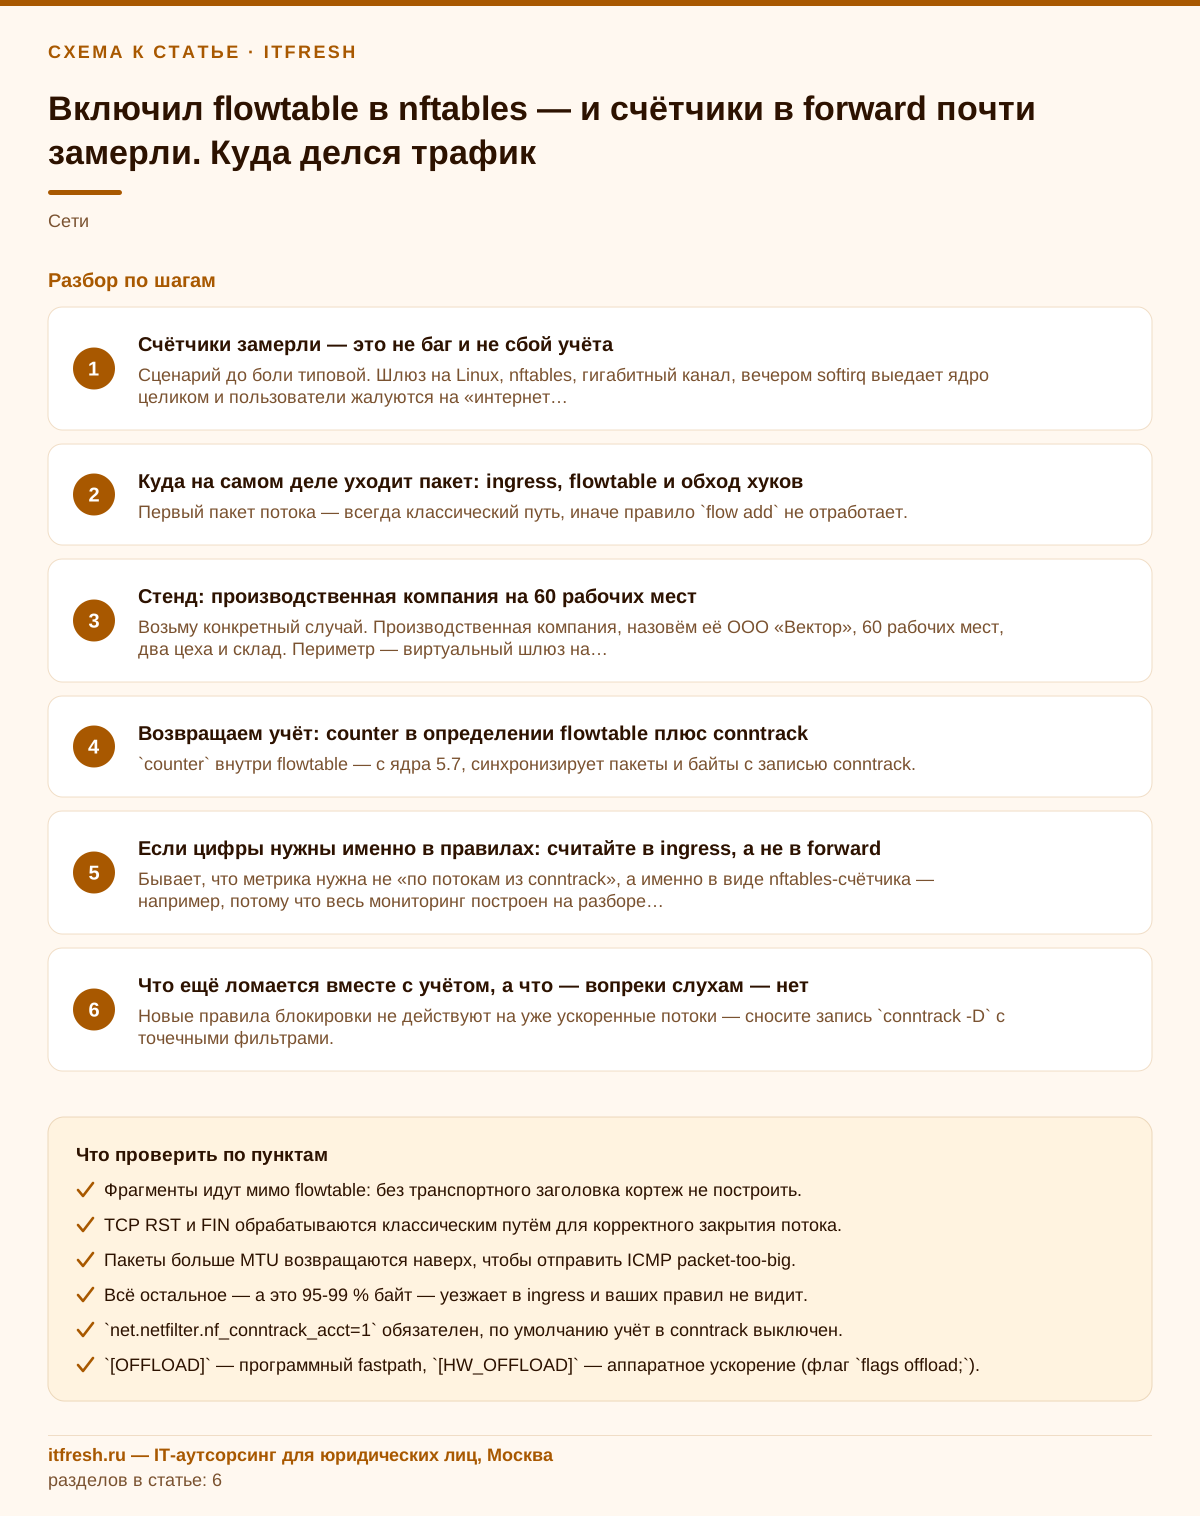
Стенд: микроиздательство на 41 рабочее место
Возьму конкретный случай. Микроиздательство «Книга малым тиражом», 41 рабочее место: редакция, верстальщики, дизайнеры обложек, небольшой отдел продаж и склад готовых тиражей. Периметр — виртуальный шлюз на Ubuntu Server 24.04 LTS (ядро 6.8, nftables 1.0.9 из штатного репозитория), 4 vCPU, канал 500 Мбит/с. Внутри — файловое хранилище с макетами и терминальный сервер с 1С. Хроническая жалоба: вечером, когда верстальщики отправляют в типографию многогигабайтные PDF-макеты, а на склад и в облако одновременно едет резервная копия архива изданий, всё встаёт колом.
Диагноз был простой: одно ядро в softirq на 78-95 %, остальные три курят, потому что RPS не размазан, а вся обработка сидит на одной очереди виртуального адаптера. Правильное решение — распределить прерывания и разгрузить путь пересылки. Flowtable тут ложится идеально: трафик почти целиком транзитный, шлюз ничего с ним не делает, кроме NAT и фильтрации по состоянию. Добавили вот такой блок:
table inet fw {
        flowtable ft {
                hook ingress priority filter - 10
                devices = { ens18, ens19 }
        }

        chain forward {
                type filter hook forward priority filter; policy drop;
                ct state invalid drop
                meta l4proto { tcp, udp } ct state established flow add @ft
                ct state established,related counter accept
                iifname "ens19" ct state new counter accept
        }
}
Обратите внимание на две вещи. Первая: в devices перечислены оба интерфейса — и внутренний, и внешний. Flowtable нужен на обеих сторонах, иначе ускорится только одно направление, а второе продолжит ехать классикой (и, кстати, счётчики в forward у вас упадут ровно вдвое, а не в тысячу раз — узнаваемый симптом недонастройки). Вторая: приоритет filter - 10. Если в ingress у вас уже есть своя nftables-цепочка, приоритет flowtable должен быть меньше — тогда fastpath отработает раньше в конвейере. В документации ядра это оговорено отдельно.
Результат по железу: softirq на пиковом ядре упал с 78-95 % до 11-14 %, вечерние жалобы прекратились в тот же день. Результат по учёту: суточный счётчик в forward показал 30 МБ вместо привычных 1,9 ТБ. Мониторинг на Zabbix, который снимал байты именно с этого правила через nft -j list ruleset, нарисовал ровную линию у нуля, а сотрудник, отвечавший за «компьютеры» в издательстве, решил, что упал канал, и перезагрузил шлюз посреди отправки макетов в типографию. Вот это, а не сами цифры, и есть настоящая цена вопроса: неверный учёт порождает неверные действия.
- В `devices` flowtable — оба интерфейса, внутренний и внешний.
- В таблице `inet` используйте `meta l4proto { tcp, udp }`: `ip protocol` отберёт только IPv4.
- Правило `flow add` ставьте до `accept` для established, иначе до него не дойдёт очередь.
- До включения снимите суточные объёмы с интерфейсов, чтобы было с чем сравнивать.
- Проверьте, какие дашборды и триггеры читают forward-счётчики, и предупредите тех, кто на них смотрит.
Возвращаем учёт: counter в определении flowtable плюс conntrack
Штатное решение появилось в ядре 5.7 и с тех пор работает во всём, что вы сегодня встретите в проде: flowtable умеет синхронизировать счётчики пакетов и байтов с существующей записью connection tracking. Включается одним словом в определении flowtable — без параметров, без скобок:
table inet fw {
        flowtable ft {
                hook ingress priority filter - 10
                devices = { ens18, ens19 }
                counter
        }
}
И вот тут — главная засада, из-за которой половина администраторов решает, что фича не работает. Само по себе counter в flowtable вам ничего не покажет, если в системе выключен учёт в conntrack. А он выключен по умолчанию: net.netfilter.nf_conntrack_acct в свежих ядрах равен нулю (в документации ядра по sysctl conntrack так и написано: 0 — disabled, default). Пока вы его не включите, поля packets= и bytes= в выводе conntrack просто отсутствуют: ядро обновляет счётчики flowtable через nf_ct_acct_update(), а тому нужно расширение учёта в самой записи conntrack. Имейте в виду, что расширение добавляется при создании записи, так что после включения sysctl цифры появятся у новых соединений, а не у давно живущих.
# без этого counter в flowtable бесполезен
sysctl -w net.netfilter.nf_conntrack_acct=1
echo 'net.netfilter.nf_conntrack_acct = 1' > /etc/sysctl.d/90-conntrack-acct.conf

# смотрим ускоренные потоки и их счётчики
conntrack -L -o extended | grep OFFLOAD
conntrack -L | grep -c OFFLOAD

# живая лента: что уезжает в fastpath прямо сейчас
conntrack -E -e NEW,UPDATES,DESTROY -p tcp
В выводе conntrack -L ускоренные потоки помечены явно. Метка [OFFLOAD] — это программный fastpath, тот самый flowtable в ядре. Метка [HW_OFFLOAD] — аппаратное ускорение, когда поток передан в железо сетевой карты или коммутатора; оно запрашивается отдельно, флагом flags offload; в определении flowtable, и требует поддержки со стороны драйвера. Различать их надо: при [HW_OFFLOAD] пакеты в принципе не доходят до процессора, и то, что вы можете о них узнать, ограничено тем, что железо отдаёт наверх.
Типичная запись выглядит так — два кортежа (прямое и обратное направление), метка и счётчики после включения acct:
tcp      6 src=10.20.0.57 dst=198.51.100.34 sport=51344 dport=443
           packets=18422 bytes=21377654
         src=198.51.100.34 dst=203.0.113.10 sport=443 dport=51344
           packets=27310 bytes=39118002 [OFFLOAD] mark=0 use=2
Дальше это уже вопрос техники сбора. Я снимаю с conntrack агрегаты по интерфейсам и направлениям, а не по каждому потоку: на шлюзе с 20-40 тысячами записей парсить полный conntrack -L каждую минуту — плохая идея, это заметная нагрузка и куча мусора в мониторинге. Для суточных объёмов мне достаточно счётчиков самих интерфейсов (ip -s link, они fastpath видят полностью, потому что стоят ниже всей netfilter-обвязки), а conntrack я использую для разбора «кто именно съел канал».
- `counter` внутри flowtable — с ядра 5.7, синхронизирует пакеты и байты с записью conntrack.
- `net.netfilter.nf_conntrack_acct=1` обязателен, по умолчанию учёт в conntrack выключен.
- `[OFFLOAD]` — программный fastpath, `[HW_OFFLOAD]` — аппаратное ускорение (флаг `flags offload;`).
- `ip -s link` и счётчики интерфейсов остаются достоверными при любом offload.
- Полный парсинг `conntrack -L` раз в минуту на нагруженном шлюзе — сам по себе источник нагрузки.
Если цифры нужны именно в правилах: считайте в ingress, а не в forward
Бывает, что метрика нужна не «по потокам из conntrack», а именно в виде nftables-счётчика — например, потому что весь мониторинг построен на разборе nft -j list ruleset и переделывать его никто не будет. Тогда счётчик надо поднять выше flowtable по конвейеру, то есть в ingress, и дать своей цепочке приоритет меньше, чем у flowtable. Тогда она отработает раньше, и мимо неё не проедет ничего.
table netdev acct {
        chain in_ens19 {
                type filter hook ingress device ens19 priority -300; policy accept;
                counter
        }
        chain in_ens18 {
                type filter hook ingress device ens18 priority -300; policy accept;
                counter
        }
}
Ограничения у этого способа честные, и о них лучше знать заранее. Первое: ingress видит только входящий трафик конкретного устройства, поэтому чтобы получить обе стороны, придётся вешать цепочку на каждый интерфейс и складывать. Второе: это состояние до NAT и до маршрутизации, так что «в разрезе внутреннего адреса» такой счётчик даёт другую картину, чем привычный forward. Третье: netdev-цепочки не знают про conntrack, там нет ct state, — фильтровать по «установленным» вы в них не сможете, только по адресам, портам и интерфейсам.
Мой практический приоритет такой. Если задача — общий объём по каналу, берите счётчики интерфейсов, это бесплатно и достоверно. Если задача — разбор по хостам и сервисам, включайте counter в flowtable плюс nf_conntrack_acct и снимайте с conntrack. Если задача — проверить, что конкретное правило вообще срабатывает, помните, что для установленных потоков оно теперь и не должно срабатывать, и проверяйте на новых соединениях. А вот городить netdev-счётчики я советую только тогда, когда переделать сборщик метрик реально невозможно: конструкция рабочая, но лишняя сущность на горячем пути.
- Общий объём по каналу — счётчики интерфейсов, бесплатно и достоверно.
- Разбор по хостам и сервисам — `counter` в flowtable плюс `nf_conntrack_acct=1`.
- Метрика обязательно в nft-правилах — netdev-цепочка в ingress с приоритетом ниже, чем у flowtable.
- В netdev-цепочках нет `ct state`: только адреса, порты и интерфейсы, и картина до NAT.
- Проверка срабатывания правила — только на новых соединениях: established-потоки его обходят по замыслу.
Что ещё ломается вместе с учётом, а что — вопреки слухам — нет
Раз пакеты обходят forward, они обходят там всё, а не только counter. Самое неприятное следствие: правило фильтрации, добавленное после того, как поток уже уехал в fastpath, на этот поток не подействует. Заблокировали адрес — новые соединения к нему не пойдут, а уже открытая сессия будет жить, пока не истечёт запись. Лечится это ровно так же, как с NAT: сносим запись из conntrack точечным conntrack -D с фильтрами, и поток вылетает из flowtable вместе с ней. Массовый conntrack -F на боевом шлюзе я не делаю — прибьёт заодно ваш SSH, IPsec и всё живое.
Дальше по списку: не отработают лимиты и ct count в forward, не сработает логирование транзитных пакетов, не увидит трафик queue — а значит, inline-IDS вроде Suricata в режиме NFQUEUE на ускоренных потоках слепнет. Это не повод отказываться от flowtable, это повод не сочетать его с NFQUEUE на одних и тех же потоках: либо инспектируйте и не ускоряйте, либо ускоряйте и инспектируйте зеркалом на отдельном интерфейсе.
Теперь про то, что пугает зря. tcpdump на интерфейсах ускоренные пакеты видит: он цепляется к устройству раньше netfilter-хуков на приёме, а на передачу пакет всё равно уходит обычным путём отправки. То есть отлаживать связность вы можете как раньше — это важно, потому что первая реакция «flowtable всё сломал, ничего не видно» обычно неверна. Исключение — аппаратное ускорение: при [HW_OFFLOAD] пакеты до хоста не доходят вовсе, и tcpdump на них действительно пуст.
Про шейпинг ходит много слухов. Классический тезис: offload обходит qdisc, поэтому SQM/cake перестаёт работать. Для аппаратного ускорения это верно однозначно — пакет до хоста не доходит. Для программного flowtable картина другая: в коде ядра ускоренный пакет отправляется через dev_queue_xmit(), то есть проходит egress-qdisc выходного интерфейса, и на форуме OpenWrt это же подтверждают практики: software offload с SQM уживается, hardware — нет. Тонкое место — ingress-шейпинг через IFB и классификация в forward: метки, которые вы ставили правилами в forward для ускоренных потоков, больше не проставляются. Если шейпер критичен, замерьте свой профиль до и после — полчаса работы.
- Новые правила блокировки не действуют на уже ускоренные потоки — сносите запись `conntrack -D` с точечными фильтрами.
- `log`, `queue`, `ct count`, лимиты в forward для offload-потоков не отрабатывают.
- Inline-IDS через NFQUEUE на ускоренных потоках не видит трафик — разводите инспекцию и ускорение.
- tcpdump продолжает видеть программно ускоренный трафик; при аппаратном `[HW_OFFLOAD]` — нет.
- Software offload проходит egress-qdisc, hardware — нет; классификация в forward для ускоренных потоков не работает.
Порядок внедрения и грабли, на которых я стоял
Сначала измерьте, что вообще упирается. Flowtable лечит нагрузку на путь пересылки — softirq, съеденный форвардингом. Если у вас тормозит из-за одной очереди на виртуальном адаптере, из-за диска или из-за того, что провайдер режет, ускорение не поможет и только заберёт у вас учёт. Смотрите mpstat -P ALL 1, cat /proc/softirqs, ethtool -S. Только убедившись, что процессор занят именно пересылкой, включайте fastpath.
Самая частая ошибка на старте — попытка загрузить конфиг на ядре без поддержки flowtable. Диагностика тут отвратительная: nft вываливает совершенно не относящееся к делу «Could not process rule: No such file or directory» на строку с объявлением flowtable и на строку с flow add. На ядре, где CONFIG_NF_FLOW_TABLE is not set, я видел именно такое сообщение (в зависимости от версий nft и ядра бывает и «Operation not supported»), и человек, впервые его увидевший, честно идёт искать несуществующий файл. Проверяйте наличие модуля до того, как начнёте править ruleset:
# есть ли поддержка вообще
modprobe nf_flow_table && lsmod | grep flow_table
zcat /proc/config.gz 2>/dev/null | grep NF_FLOW_TABLE

# синтаксическая проверка без применения
nft -c -f /etc/nftables.conf

# что реально объявлено и какие хуки заняты
nft list flowtables
nft list hooks   # есть только в свежих версиях nft
Дальше — короткий список того, что чаще всего делают не так. В devices указывают один интерфейс вместо обоих. Для PPPoE и VLAN добавляют виртуальные устройства — а надо реальное: с ядра 5.13 flowtable сам разбирает VLAN- и PPPoE-заголовки и находит настоящий netdevice. Для мостов забывают, что flowtable умеет разбирать топологию за мостом (включая bridge VLAN filtering), и в flowtable можно (и нужно, если хочется fastpath между портами моста и маршрутизацией) добавлять сами порты моста, представленные реальными устройствами. И почти все забывают, что flow add имеет смысл ставить только для состояния established — на новых соединениях ускорять нечего.
Наконец, про откат. Это одна из немногих оптимизаций, которую можно снять мгновенно и без последствий: убираете правило flow add @ft, перезагружаете ruleset — и новые потоки снова идут классическим путём. Уже ускоренные доживут до истечения записей или до conntrack -D. Поэтому не бойтесь пробовать: цена эксперимента — минута, а вот цену молча сломанного учёта вы узнаете сильно позже и совсем в другом разговоре.
- «Could not process rule: No such file or directory» на flowtable — первым делом проверьте модуль nf_flow_table.
- В `devices` перечисляйте оба интерфейса — иначе ускорится одно направление из двух.
- PPPoE и VLAN: указывайте реальное устройство, разбор заголовков есть с ядра 5.13.
- Мосты: flowtable понимает топологию за мостом, в devices указываются реальные порты.
- `flow add` — только для `ct state established`; откат делается снятием одного правила.
Частые вопросы
Почему счётчик в forward не ноль, а просто маленький?
Потому что часть трафика в fastpath не попадает принципиально. Через forward всегда проходит первый пакет каждого потока (иначе не сработало бы правило flow add), а также фрагментированные пакеты, TCP RST и FIN и всё, что превышает MTU и требует ICMP packet-too-big. Подавляющая часть байт уезжают в ingress и вашего счётчика не видят. Если счётчик упал ровно вдвое, а не на порядки, — скорее всего вы указали в devices только один интерфейс из двух.
Как включить корректный учёт трафика при работающем flowtable?
Добавьте слово counter в определение flowtable (поддерживается с ядра Linux 5.7) и обязательно включите учёт в conntrack: sysctl -w net.netfilter.nf_conntrack_acct=1, а строку продублируйте в /etc/sysctl.d, чтобы она пережила перезагрузку. По умолчанию этот параметр равен нулю, и без него поля packets= и bytes= в выводе conntrack -L просто отсутствуют. После этого счётчики flowtable синхронизируются с записями connection tracking и видны в conntrack -L -o extended.
Чем отличаются метки OFFLOAD и HW_OFFLOAD в выводе conntrack -L?
[OFFLOAD] — это программный fastpath, то есть flowtable внутри ядра: пакеты обрабатываются на CPU, но по короткому пути. [HW_OFFLOAD] — аппаратное ускорение, когда поток передан в железо сетевого адаптера или коммутатора; оно запрашивается флагом flags offload в определении flowtable и требует поддержки драйвером. Практическая разница существенная: при аппаратном offload пакеты до хоста не доходят вообще, поэтому их не видит даже tcpdump.
Почему правило блокировки не действует на уже открытое соединение?
Потому что поток уже находится в flowtable и обходит цепочку forward целиком — новые правила фильтрации к нему не применяются. Блокировка подействует только на новые соединения. Чтобы прибить конкретный живой поток, удалите его запись из connection tracking точечной командой conntrack -D с фильтрами по адресам и портам: вместе с записью conntrack поток вылетит и из flowtable. Массовый conntrack -F на боевом шлюзе делать не стоит — он оборвёт заодно вашу SSH-сессию, туннели и служебные соединения.
nft ругается «Could not process rule: No such file or directory» на объявление flowtable. Что не так?
Чаще всего в ядре нет поддержки flowtable — модуль nf_flow_table отсутствует или CONFIG_NF_FLOW_TABLE не включён в сборке. Сообщение вводит в заблуждение: никакого файла искать не надо. Проверьте modprobe nf_flow_table и lsmod | grep flow_table, а на кастомных и урезанных ядрах (в том числе в некоторых контейнерных и WSL-сборках) — конфигурацию ядра. Тот же самый ruleset на ядре с поддержкой загрузится без единой правки.
Ломает ли flowtable шейпинг трафика и QoS?
Для аппаратного offload — да, однозначно: пакеты не доходят до дисциплин очередей на хосте. Для программного flowtable — в основном нет: ускоренный пакет отправляется через dev_queue_xmit() и проходит дисциплину очередей на выходном интерфейсе, так что egress-шейпинг (SQM/cake) продолжает работать. Ломается то, что опирается на правила в forward: маркировка для классификации, лимиты, ct count. Если шейпер для вас критичен, замерьте профиль до и после включения — это полчаса работы.
Какие соединения flowtable не ускорит, даже если правило flow add на них срабатывает?
Соединения с подключённым conntrack-helper (FTP, SIP и другие ALG), соединения с корректировкой sequence-номеров, записи с NAT-коллизией, IPsec-трафик с security path и IPv4-пакеты с опциями заголовка. TCP-поток должен быть в состоянии established. Такие потоки продолжают идти через forward, поэтому для них счётчики, лимиты и логирование работают как раньше.
Источники
- Документация ядра Linux: Netfilter's flowtable infrastructure — Netfilter's flowtable infrastructure, Linux Kernel documentation (networking): обход хуков после ingress, приоритет flowtable относительно ingress-цепочек, фрагменты/RST/FIN/MTU, counter с ядра 5.7, flags offload, метки [OFFLOAD] и [HW_OFFLOAD], VLAN/PPPoE с 5.13, мосты, ограничения: https://docs.kernel.org/networking/nf_flowtable.html
- nftables wiki: Flowtables — Официальная вики проекта nftables, страница Flowtables: объявление flowtable (hook ingress, priority, devices), правило `flow add @f`, создание записи после появления состояния (обычно первым ответным пакетом): https://wiki.nftables.org/wiki-nftables/index.php/Flowtables
- Документация ядра Linux: Netfilter Conntrack Sysfs variables — nf_conntrack-sysctl: nf_conntrack_acct (по умолчанию 0), nf_flowtable_tcp_timeout и nf_flowtable_udp_timeout (по умолчанию 30 с): https://docs.kernel.org/networking/nf_conntrack-sysctl.html
- man nft(8) — nft(8), раздел FLOWTABLES: синтаксис объявления flowtable, приоритет как знаковое целое или filter (=0), положение в ingress до prerouting, list flowtables: https://www.netfilter.org/projects/nftables/manpage.html
- man conntrack(8) — Параметры -L, -D, -E, -e [ALL|NEW|UPDATES|DESTROY], -o extended, -p: https://manpages.debian.org/bookworm/conntrack/conntrack.8.en.html
- Исходный код ядра: nft_flow_offload.c и nf_flow_table_ip.c — Условия отказа от offload (helper, seqadj, NAT clash, secpath, TCP established), обновление счётчиков nf_ct_acct_update() при NF_FLOWTABLE_COUNTER, отправка через dev_queue_xmit(): https://github.com/torvalds/linux/blob/master/net/netfilter/nft_flow_offload.c
- LWN.net: Flow offload infrastructure — Pablo Neira Ayuso, анонс патчсета flow offload infrastructure, 22.12.2017: https://lwn.net/Articles/742164/
- OpenWrt Forum: Software flow offloading implications — Обсуждение совместимости программного offload с SQM: software offload использует qdisc, hardware offload их обходит: https://forum.openwrt.org/t/software-flow-offloading-implications/90957