
PreferSameNode против internalTrafficPolicy: Local — как оставить трафик на своём узле и не потерять сервис
Статья для тех, чей сервис живёт в Kubernetes — в собственном кластере или у подрядчика, — и кто не хочет разбираться с «иногда зависает» по ночам. Разбираю, что на самом деле означают значения поля trafficDistribution (PreferClose, PreferSameZone, PreferSameNode), как они шли по версиям от 1.30 до 1.35, почему internalTrafficPolicy: Local — это не «предпочтение своего узла», а жёсткое требование с отбрасыванием пакетов, и как мы перевели сервис онлайн-записи небольшой консультации с одного на другое, чтобы rolling update DaemonSet перестал на полминуты обрывать форму записи.
PreferClose никогда не означал «свой узел»
Типичная сцена. На каждом узле крутится вспомогательный под — кэширующий прокси, агент сбора логов, локальный DNS. Логика администратора железная: раз реплика есть на каждой ноде, пусть клиент ходит в свою, а не гоняет пакеты по коммутатору. Человек открывает документацию по Service, видит поле trafficDistribution со значением PreferClose, читает слово «close» как «ближайший, то есть на этой же машине» — и ставит его. А потом удивляется, что в метриках межузловой трафик как был, так и есть.
PreferClose никогда не значил «тот же узел». Он всегда значил ровно «та же зона» — зона в смысле метки topology.kubernetes.io/zone на объекте Node. Внутри зоны все эндпоинты для kube-proxy равны: хоть на этой же ноде, хоть на соседней стойке. В облаке зона — это availability zone провайдера, и там от PreferClose есть польза: он режет межзональный трафик, за который в AWS и GCP выставляют отдельный счёт. А вот в кластере на своём железе в одном ЦОД зона обычно одна на весь кластер (или метки нет вообще), и PreferClose там не делает буквально ничего. Ноль эффекта, ноль ошибок, ноль сообщений в логах — просто тишина.
Второй путь в ту же яму — internalTrafficPolicy со значением Local. Вот это действительно «свой узел», и работает именно так, как хотелось. Ровно до первой ситуации, когда локального пода на узле не оказалось. Тогда kube-proxy не ищет запасной маршрут — он выбрасывает пакет. Не 503, не переадресация на соседа, а тишина в сокете до клиентского таймаута. Rolling update этого самого DaemonSet, cordon узла перед обновлением ядра, OOM-kill одной реплики — и всё, для клиентов на этой ноде сервис умер.
Закрывали эту дыру в два захода. Само поле trafficDistribution с единственным значением PreferClose пришло по KEP-4444: alpha в 1.30 (гейт ServiceTrafficDistribution), beta с включением по умолчанию в 1.31, stable в 1.33. А по KEP-3015 в 1.33 появились PreferSameNode — предпочитаем локальный эндпоинт, но при его отсутствии спокойно уходим на удалённый — и PreferSameZone, новое имя для PreferClose, чтобы оно перестало врать о семантике. В 1.35 эта вторая часть стала stable. Старое имя PreferClose оставили работающим: удалять его из API в KEP прямо записано как «не цель».
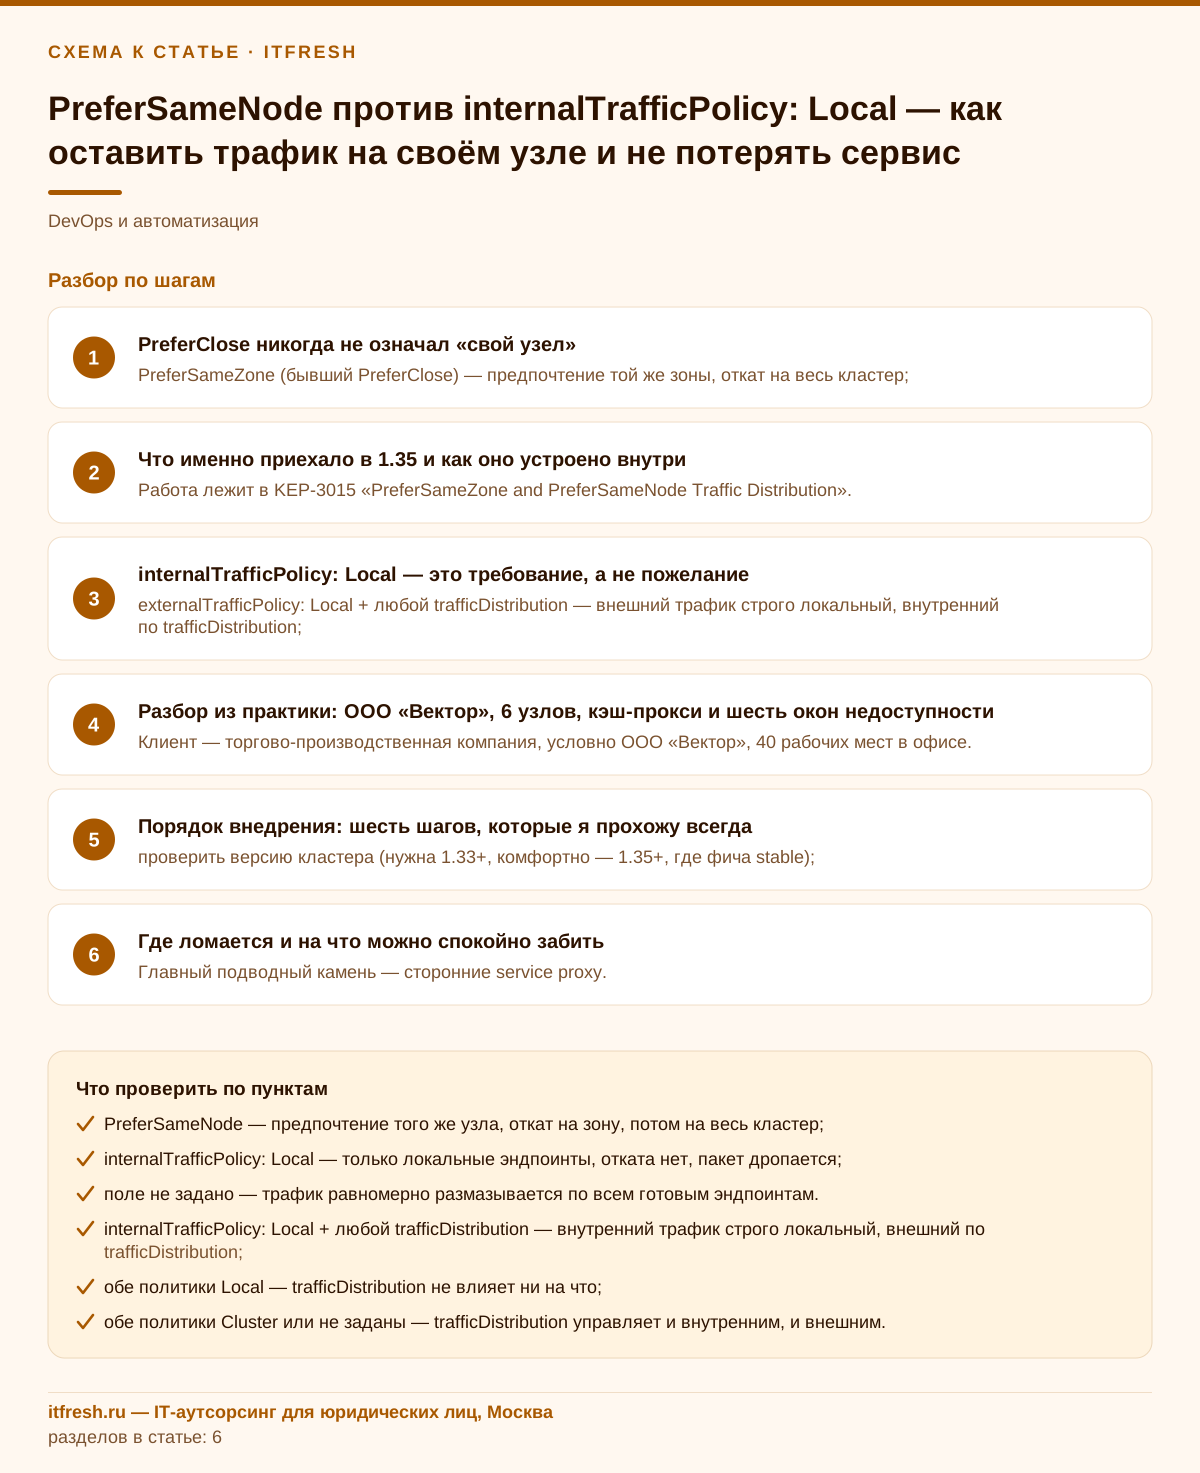
- PreferSameZone (бывший PreferClose) — предпочтение той же зоны, откат на весь кластер;
- PreferSameNode — предпочтение того же узла, откат на зону, потом на весь кластер;
- internalTrafficPolicy: Local — только локальные эндпоинты, отката нет, пакет дропается;
- поле не задано — трафик равномерно размазывается по всем готовым эндпоинтам.
Что именно приехало в 1.35 и как оно устроено внутри
Работа лежит в KEP-3015 «PreferSameZone and PreferSameNode Traffic Distribution». Календарь такой: alpha в 1.33, beta с включением по умолчанию в 1.34, stable в 1.35 (релиз от 17 декабря 2025 года). Фича-гейт называется PreferSameTrafficDistribution и заявлен для трёх компонентов — kube-apiserver, kube-controller-manager и kube-proxy. На сентябрь 2026 в поддержке находятся 1.35, 1.36 и 1.37 (1.37.0 вышел 26 августа 2026), то есть на любой живой версии функция уже stable и гейт трогать не нужно вообще. Важная деталь про alpha: в 1.33 гейт выключен по умолчанию, и без явного включения на kube-apiserver новое значение будет отклонено валидацией. Если у вас 1.32 или ниже — сначала обновляйтесь, там этого нет вообще; впрочем, 1.34 и более ранние версии уже вне поддержки проекта.
Механика простая и в ней стоит разобраться, потому что диагностика идёт именно по ней. kube-proxy сам поле trafficDistribution не читает — вообще никогда. Читает его контроллер EndpointSlice внутри kube-controller-manager и по результату проставляет в объекты EndpointSlice подсказки в секции hints. Для зоны это forZones, для узла — новое поле forNodes со списком объектов вида {name: <имя-узла>}. Причём для PreferSameNode контроллер проставляет ОБА хинта: forNodes для новых прокси и forZones для старых, чтобы при рассинхроне версий сервис деградировал до «той же зоны», а не до полного отсутствия локальности.
Выглядит это так. Сам Service:
apiVersion: v1
kind: Service
metadata:
  name: node-cache
  namespace: prod
spec:
  selector:
    app: node-cache
  ports:
    - port: 80
      targetPort: 8080
  trafficDistribution: PreferSameNode
И то, что после этого появляется в EndpointSlice:
apiVersion: discovery.k8s.io/v1
kind: EndpointSlice
endpoints:
  - addresses: ["10.244.3.17"]
    nodeName: worker-03
    zone: zone-a
    conditions:
      ready: true
    hints:
      forNodes:
        - name: worker-03
      forZones:
        - name: zone-a
Дальше решение принимает kube-proxy в функции CategorizeEndpoints, и алгоритм там трёхступенчатый. Первое: если у КАЖДОГО эндпоинта проставлен forNodes и хотя бы один из них указывает на локальный узел — берём только эти эндпоинты. Второе: иначе, если у каждого эндпоинта есть forZones и хотя бы один указывает на зону локального узла — берём зональные. Третье: иначе доступны все эндпоинты. Обратите внимание на слово «каждый» — это не придирка, это ключевой предохранитель. Если хотя бы у одного эндпоинта в слайсе подсказки нет, вся топология игнорируется целиком, и трафик растекается по кластеру. Сделано, чтобы во время раскатки не получилось полусостояния, когда часть подов невидима.
- kube-apiserver — принимает и валидирует значение trafficDistribution (PreferSameNode — только при включённом гейте PreferSameTrafficDistribution, по умолчанию с 1.34);
- kube-controller-manager (контроллер EndpointSlice) — проставляет hints.forNodes и hints.forZones в EndpointSlice;
- kube-proxy — по хинтам в CategorizeEndpoints выбирает локальные, зональные или все эндпоинты;
- сторонний service proxy (Cilium kube-proxy replacement и аналоги) — сам решает, какие хинты читать, и может понимать только forZones;
- при даунгрейде контроллер считает незнакомое значение пустым и снимает хинты — сервис возвращается к равномерному распределению.
internalTrafficPolicy: Local — это требование, а не пожелание
Поля .spec.internalTrafficPolicy и .spec.externalTrafficPolicy принимают два значения: Cluster и Local. Внутренний вариант стабилен с 1.26, так что это давно не новинка. Документация формулирует поведение предельно прямо: при Local трафик уходит только на готовые эндпоинты локального узла, а если локальных эндпоинтов нет — трафик отбрасывается kube-proxy. Не отклоняется с ошибкой, не перенаправляется. Отбрасывается.
Для клиента это выглядит как зависание. Соединение не устанавливается, ответа нет, приложение сидит до своего таймаута — пять секунд, тридцать, сколько прописано. В графиках это даёт не всплеск пятисоток, а всплеск p99 и рост числа открытых соединений. Люди часто ищут причину в сети, в MTU, в CNI — а причина в одной строчке манифеста и в том, что реплика уехала с узла.
Теперь про приоритеты, потому что это ровно тот вопрос, из-за которого путаница и возникает. Правило одно и оно жёсткое: если для соответствующего типа трафика политика выставлена в Local, она перебивает trafficDistribution. Внутренний трафик смотрит на internalTrafficPolicy, внешний — на externalTrafficPolicy. Если политика стоит в Cluster (значение по умолчанию) или не задана вовсе — тогда работает trafficDistribution. Документация прямо называет это разницей между «строгими гарантиями» и «предпочтениями».
Практический вывод: комбинация из internalTrafficPolicy со значением Local и trafficDistribution со значением PreferSameNode на одном сервисе — это не «двойная защита», а мёртвая строчка. Для внутреннего трафика выиграет Local, и вся идея с откатом на удалённый эндпоинт не сработает. Я такие манифесты вижу регулярно: человек добавил новое поле, старое убрать забыл, поведение не изменилось, и он делает вывод, что «PreferSameNode не работает».
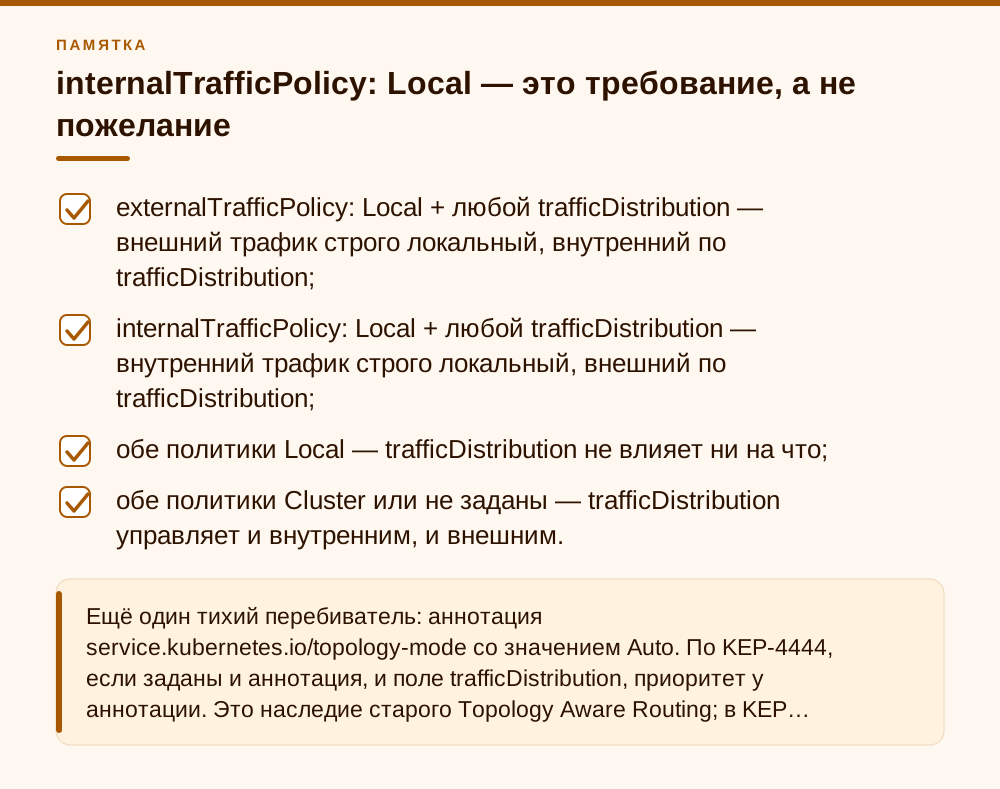
- externalTrafficPolicy: Local + любой trafficDistribution — внешний трафик строго локальный, внутренний по trafficDistribution;
- internalTrafficPolicy: Local + любой trafficDistribution — внутренний трафик строго локальный, внешний по trafficDistribution;
- обе политики Local — trafficDistribution не влияет ни на что;
- обе политики Cluster или не заданы — trafficDistribution управляет и внутренним, и внешним.
Разбор из практики: «Кадровый навигатор», онлайн-запись у подрядчика и четыре зависания формы
Клиент — карьерная консультация «Кадровый навигатор»: 10 рабочих мест, консультанты по поиску работы и составлению резюме, приём по записи. Своего кластера у них нет и быть не должно: сервис онлайн-записи на сайте написал и сопровождает веб-подрядчик, и живёт он у подрядчика в Kubernetes — три воркера, Kubernetes 1.36, kube-proxy в режиме iptables, CNI Calico. Одна зона, метки topology.kubernetes.io/zone нет — обычная история для небольшого кластера. Мы у консультации отвечаем за офисную IT-часть и как её представитель получили от подрядчика read-only доступ к пространству имён сервиса записи.
Перед API календаря консультантов стоял кэширующий nginx, развёрнутый DaemonSet-ом: по одному поду на воркер, задача — не дёргать календарь на каждый просмотр свободных слотов. Подрядчик поставил на его Service internalTrafficPolicy со значением Local. Логика понятна: кэш локальный, ходить в чужой кэш смысла нет. И несколько месяцев всё работало.
Меня позвали, когда администратор консультации переслала два письма клиентов: «нажимаю «Записаться», крутится, потом ошибка». Для компании на 10 человек это не абстрактный SLA: каждая сорванная запись — это клиент, который уходит к конкурентам, а одна консультация стоит заметных денег. Мы с подрядчиком собрали окна из метрик Prometheus за две недели: четыре эпизода, суммарно около семи минут, и все совпадают по времени либо с rolling update DaemonSet-а nginx (смена конфига кэша, 20–40 секунд без готового пода на узле), либо с drain узла под обновление ядра. Поды бэкенда записи на «пострадавшем» узле в эти окна упирались в свой пятисекундный таймаут: 214 записей context deadline exceeded, в каждом окне все с одного узла. По журналу заявок — минимум три незавершённые записи. Сеть ни при чём: kube-proxy честно отбрасывал пакеты, как и написано в документации.
Правка — одна строчка, выполнял её подрядчик по нашей рекомендации: убрать internalTrafficPolicy и поставить trafficDistribution со значением PreferSameNode.
kubectl patch svc nginx-cache -n booking --type=merge \
  -p '{"spec":{"internalTrafficPolicy":"Cluster","trafficDistribution":"PreferSameNode"}}'

kubectl get endpointslice -n booking \
  -l kubernetes.io/service-name=nginx-cache \
  -o jsonpath='{range .items[*].endpoints[*]}{.nodeName}{"\t"}{.hints.forNodes[*].name}{"\n"}{end}'
Вывод второй команды должен дать три строки, где имя узла слева совпадает с именем в подсказке справа. Совпало сразу — контроллер отработал за пару секунд.
Итог за месяц наблюдения: зависаний формы ноль, жалоб от клиентов консультации тоже. Доля запросов, ушедших на под соседнего узла, — единицы процентов и ровно в моменты обновлений и drain, в остальное время близко к нулю. Медиана и p99 в обычном режиме не изменились: локальность и так была, поменялось только поведение в момент отсутствия локальной реплики. Пятисекундные всплески исчезли.
И честная вторая половина истории. По инерции я предложил PreferSameNode и для сервиса генерации PDF-резюме, а у него всего две реплики на три узла. Формально ничего не сломалось: клиенты на узле без реплики откатились на общее распределение. Но на одном из узлов с репликой жила примерно половина клиентских подов, ещё около 30 % — на узле без реплики. В итоге одна реплика стала принимать порядка 65 % запросов (свои 50 % плюс половина от 30 %), вторая — 35 %, и в часы пиковой записи это было видно по времени генерации. Через два дня сервис вернули на дефолт. Вывод: PreferSameNode — для сервисов, у которых реплика есть на каждом узле, где живут клиенты. Для сервисов с горсткой реплик это перекос нагрузки, а не оптимизация.
Что из этого стоит вынести владельцу маленькой компании, у которой сайт или запись крутятся у подрядчика. Разбираться в хинтах EndpointSlice вам не нужно. Нужно уметь задать подрядчику три вопроса: какие сервисы у вас стоят на internalTrafficPolicy: Local и что с ними происходит при обновлении; проверяли ли вы сценарий «на узле нет реплики»; и какие метрики покажут, что форма записи зависала. Если на второй вопрос ответ «не проверяли» — это повод попросить приёмочный тест с drain узла, а не повод менять подрядчика.
- в какие часы подрядчик обновляет DaemonSet-ы и узлы и совпадают ли эти окна с жалобами клиентов;
- какие Service стоят на internalTrafficPolicy: Local и почему именно так;
- проверялся ли сценарий «на узле нет локальной реплики» — drain или scale до нуля;
- какие метрики и логи показывают таймауты формы записи и кто их смотрит;
- какая версия Kubernetes в кластере и когда у неё конец поддержки.
Порядок внедрения: шесть шагов, которые я прохожу всегда
Первое — версия. Значение PreferSameNode валидируется API-сервером, и на кластере ниже 1.33 (и на 1.33 без включённого гейта) патч просто не пройдёт с ошибкой Unsupported value. Это, кстати, самый быстрый способ проверки: попробовать поставить и посмотреть на реакцию.
kubectl version -o json | jq -r '.serverVersion.gitVersion'

kubectl patch svc node-cache -n booking --type=merge \
  -p '{"spec":{"trafficDistribution":"PreferSameNode"}}'
Второе — снять конфликтующее. Аннотацию topology-mode со значением Auto убрать, internalTrafficPolicy привести к Cluster. Пока они на месте, новое поле ни на что не влияет, и вы будете час искать несуществующую проблему.
kubectl annotate svc node-cache -n booking service.kubernetes.io/topology-mode-
kubectl get svc node-cache -n booking \
  -o custom-columns='ITP:.spec.internalTrafficPolicy,TD:.spec.trafficDistribution'
Третье — убедиться, что хинты реально проставились у ВСЕХ эндпоинтов, а не у части. Напоминаю: одного эндпоинта без подсказки достаточно, чтобы kube-proxy отключил топологию для всего сервиса. Четвёртое — проверить, что ваш service proxy умеет forNodes. Штатный kube-proxy умеет с 1.33 при включённом гейте, по умолчанию — с 1.34. Со сторонними реализациями нужна проверка на месте, об этом ниже отдельно. Пятое — снять базовые метрики до правки, иначе потом нечем будет доказать эффект. Шестое — раскатывать по одному сервису, а не пачкой: поведение при отсутствии локальной реплики у разных сервисов разное, и разбирать регресс проще, когда изменение одно.
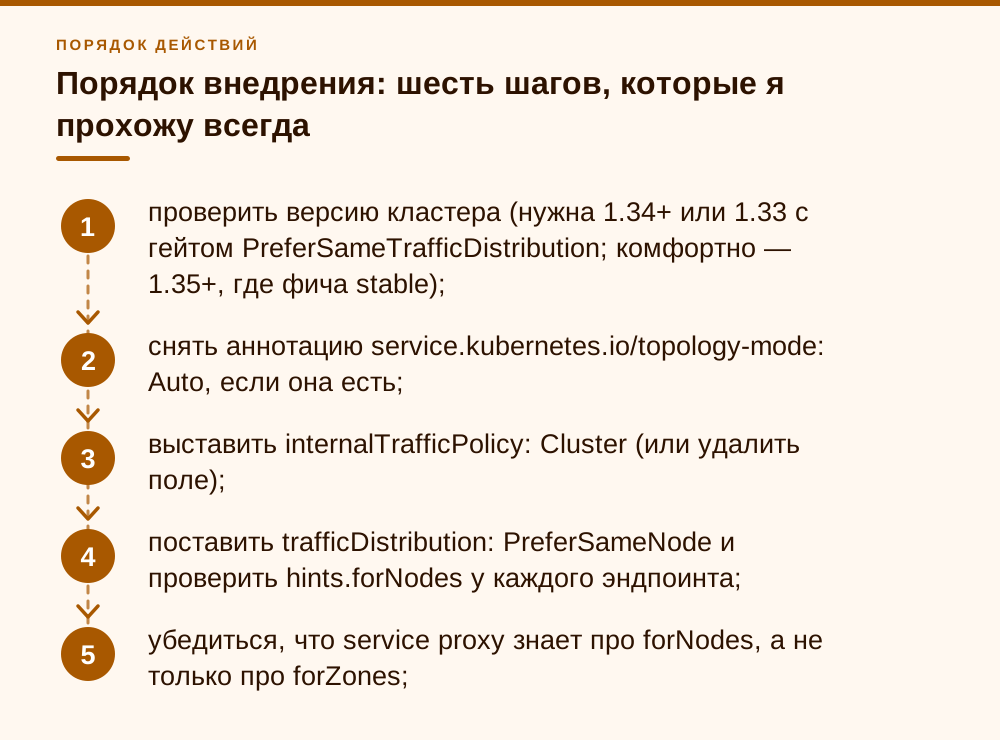
- проверить версию кластера (нужна 1.34+ или 1.33 с гейтом PreferSameTrafficDistribution; комфортно — 1.35+, где фича stable);
- снять аннотацию service.kubernetes.io/topology-mode: Auto, если она есть;
- выставить internalTrafficPolicy: Cluster (или удалить поле);
- поставить trafficDistribution: PreferSameNode и проверить hints.forNodes у каждого эндпоинта;
- убедиться, что service proxy знает про forNodes, а не только про forZones;
- прогнать нагрузочный тест с намеренным drain одного узла — это единственная честная проверка отката.
Где ломается и на что можно спокойно забить
Главный подводный камень — сторонние service proxy. kube-proxy читает forNodes начиная с 1.33 (с гейтом) и по умолчанию с 1.34, тут вопросов нет. А вот если у вас kube-proxy заменён на Cilium в режиме kube-proxy-free, картина другая: Traffic Distribution там реализован и включается опцией loadBalancer.serviceTopology=true, но в документации механика описана как маршрутизация к эндпоинтам в той же зоне, про forNodes там ничего нет. KEP-3015 именно такой сценарий и предусматривает: прокси, не знающий forNodes, увидит проставленный рядом forZones и отработает как PreferSameZone. То есть сервис не сломается — он просто тихо не будет делать того, что вы задумали. Проверять надо на своём кластере трассировкой реального запроса, а не по релиз-нотам.
Второй камень — перегрузка эндпоинтов, и это спорное место по дизайну. Старый Topology Aware Routing через аннотацию Auto пытался быть умным: раскидывал трафик пропорционально выделяемому CPU по зонам и имел предохранитель на случай малого числа эндпоинтов. Новое поле сознательно от этого отказалось в пользу предсказуемости: есть локальные эндпоинты — они забирают весь трафик, нет — уходим дальше. Документация честно перекладывает балансировку на вас и предлагает Pod Topology Spread Constraints, отдельные Deployment на зону и горизонтальное автомасштабирование. Мне такой размен нравится больше — предсказуемое поведение отлаживается, эвристика нет, — но признаю, что это именно размен.
Третий — деградация при откате версии. Если кластер откатили на релиз, не знающий новое значение, контроллер EndpointSlice воспримет его как пустое и снимет хинты. Сервис не упадёт, он просто вернётся к равномерному распределению. Безопасно, но тихо: в событиях ничего, в статусе Service ничего. Поэтому мониторить надо наличие forNodes в EndpointSlice, а не значение поля в Service. Достаточно простой проверки в любом мониторинге — раз в пять минут kubectl-запрос и сравнение количества эндпоинтов с количеством хинтов:
kubectl get endpointslice -n booking -l kubernetes.io/service-name=nginx-cache -o json \
  | jq '[.items[].endpoints[]] | {endpoints: length, withNodeHints: map(select(.hints.forNodes != null)) | length}'
А теперь про то, на что можно забить. На фича-гейт — он stable, включён, отключать его вручную не надо и не стоит. На размер EndpointSlice из-за дублирования forZones рядом с forNodes — прирост исчисляется десятками байт на эндпоинт, это шум. На метрики самой фичи — их нет, и KEP прямо это признаёт: проект не знает, какая латентность считается у вас хорошей, поэтому меряйте прикладными метриками. И на PreferSameZone в кластере с одной зоной — он там просто лишняя строчка в манифесте, вреда никакого, пользы тоже.
- замена kube-proxy (Cilium и аналоги): документация Cilium описывает маршрутизацию только по зональным хинтам — проверяйте forNodes трассировкой;
- эндпоинт без хинта в слайсе: kube-proxy игнорирует топологию для всего сервиса;
- аннотация topology-mode: Auto: перебивает поле trafficDistribution;
- мало реплик при неравномерных клиентах: локальный под забирает весь трафик узла;
- даунгрейд control plane: хинты тихо снимаются, сервис уходит на равномерное распределение.
Когда Local — по-прежнему правильный выбор
Я не призываю выкорчёвывать Local отовсюду. Есть сценарии, где именно строгая гарантия и нужна, а падение при отсутствии локальной реплики — корректное поведение, а не авария. Самый частый — externalTrafficPolicy со значением Local на сервисах типа LoadBalancer и NodePort. Он сохраняет реальный source IP клиента (критично для геофильтрации, whitelist по адресам и вообще любой аналитики) и убирает лишний хоп между узлами.
Там же завязана и балансировщиковая проверка здоровья. kube-proxy отдаёт health-check на ${NODE_IP}:10256/healthz, и для сервиса с Local он возвращает 200 только тогда, когда kube-proxy жив и на узле есть локальный эндпоинт. То есть внешний балансировщик сам уберёт узел без реплики из пула — деградации по сути не будет. Это принципиально иная ситуация, чем с внутренним трафиком, где никакого балансировщика между подом и Service нет и некому принять решение об исключении узла. Отдельно отмечу: для livenessProbe самого kube-proxy используйте путь /livez, а не /healthz — второй учитывает состояние удаления узла и при drain загонит kube-proxy в бесконечный рестарт.
Внутренний Local я оставляю там, где удалённый вызов семантически невозможен. Агент, который пишет в сокет или устройство конкретного узла. Сервис, читающий данные с локального hostPath. Компонента, лицензированная по узлу. В этих случаях уход на соседнюю ноду — это не «деградация с сохранением работоспособности», а тихо неверный результат, и явный отказ лучше. Но такие случаи надо уметь назвать вслух: если на вопрос «что сломается, если запрос уйдёт на соседний узел» ответа нет — значит, вам нужен PreferSameNode, а не Local.
Мой рабочий критерий укладывается в одну фразу. Local — когда удалённый эндпоинт даст неправильный ответ. PreferSameNode — когда удалённый эндпоинт даст правильный ответ, просто чуть медленнее. В девяти случаях из десяти, что я вижу у клиентов, речь именно про второе, а стоит первое.
- externalTrafficPolicy: Local на LoadBalancer/NodePort, когда нужен реальный source IP клиента;
- агент, работающий с сокетом или устройством конкретного узла;
- сервис, читающий данные с локального hostPath;
- компонент, лицензированный по узлу;
- всё остальное, где соседний узел ответит верно, но медленнее, — кандидат на PreferSameNode.
Частые вопросы
С какой версии Kubernetes можно ставить PreferSameNode в продакшене?
Значение принимается с 1.33 (alpha, гейт PreferSameTrafficDistribution выключен по умолчанию), включено по умолчанию с 1.34 (beta), stable — с 1.35. В продакшене я ставлю с 1.35 и выше: там гейт уже не нужно контролировать, а поведение зафиксировано. На сентябрь 2026 поддерживаются 1.35, 1.36 и 1.37, так что на любом живом кластере вопрос не стоит.
Нужно ли переписывать манифесты с PreferClose на PreferSameZone?
Не обязательно и не срочно. PreferClose объявлен устаревшим алиасом PreferSameZone, но удалять его из API никто не планирует — это прямо записано в непринятых целях KEP-3015. Меняйте при очередной правке манифеста, чтобы имя не вводило в заблуждение следующего дежурного. Поведение при этом не изменится ни на йоту.
Что произойдёт, если поставить internalTrafficPolicy: Local и trafficDistribution: PreferSameNode одновременно?
Для внутреннего трафика выиграет Local: строгие политики имеют приоритет над предпочтениями. То есть при отсутствии локального эндпоинта пакет будет отброшен, никакого отката на удалённый под не случится. Такая комбинация — типичная причина жалобы «поставил PreferSameNode, а ничего не изменилось». Уберите Local или явно поставьте Cluster.
Как убедиться, что PreferSameNode реально работает, а не откатился до зональной семантики?
Посмотрите EndpointSlice: у каждого эндпоинта должен быть hints.forNodes с именем его узла. Если хинтов нет или они есть не у всех — kube-proxy отключит топологию для всего сервиса. Потом проверьте на трафике: запустите curl из пода на конкретном узле и посмотрите в логах бэкенда, какой под ответил. И обязательно проверьте сторонний service proxy — при замене kube-proxy на Cilium или аналог поддержка forNodes не гарантирована, и вы молча получите поведение PreferSameZone.
Имеет ли смысл PreferSameZone в кластере на своём железе в одном ЦОД?
Практически нет. Если метка topology.kubernetes.io/zone на узлах не проставлена или одинакова у всех, PreferSameZone (он же PreferClose) не изменит ничего. Ощутимую пользу он даёт в облаке, где межзональный трафик тарифицируется отдельно и добавляет заметную задержку. Для on-prem кластера в одной стойке правильный инструмент — именно PreferSameNode.
Не перегрузит ли PreferSameNode отдельные поды?
Может, и это задокументированный риск. В отличие от старой аннотации topology-mode: Auto, у нового поля нет эвристики и предохранителя на малое число эндпоинтов: есть локальный под — он забирает весь трафик узла. Поэтому PreferSameNode хорош для DaemonSet-подобных сервисов, где реплика есть на каждом узле с клиентами, и опасен для сервисов с двумя-тремя репликами на большой кластер. Балансировку проект перекладывает на Pod Topology Spread Constraints и автомасштабирование.
Нашей компании 10 человек, сервис записи у подрядчика в Kubernetes. Нам вообще нужно об этом думать?
Самим править манифесты — нет, это работа подрядчика. Но если клиенты жалуются на «иногда зависает запись», а подрядчик не находит проблем в сети, попросите его проверить internalTrafficPolicy на сервисах и прогнать тест с drain узла. Это полчаса работы, а сорванные записи для маленькой консультации — прямые потери выручки.
Источники
- Kubernetes Documentation — Virtual IPs and Service Proxies — Разделы «Traffic policies» (Internal/External traffic policy) и «Traffic distribution control» с описанием PreferSameZone, PreferSameNode, PreferClose и правил приоритета: https://kubernetes.io/docs/reference/networking/virtual-ips/
- KEP-3015: PreferSameZone and PreferSameNode Traffic Distribution — Design Details, поле hints.forNodes в discovery.k8s.io/v1, алгоритм CategorizeEndpoints, Version Skew Strategy; kep.yaml: stage stable, milestone alpha v1.33 / beta v1.34 / stable v1.35, feature gate PreferSameTrafficDistribution: https://github.com/kubernetes/enhancements/tree/master/keps/sig-network/3015-prefer-same-node
- KEP-4444: Traffic Distribution for Services — Введение поля spec.trafficDistribution (PreferClose), взаимодействие с externalTrafficPolicy/internalTrafficPolicy, приоритет аннотации topology-mode; kep.yaml: alpha v1.30 / beta v1.31 / stable v1.33, гейт ServiceTrafficDistribution: https://github.com/kubernetes/enhancements/tree/master/keps/sig-network/4444-service-traffic-distribution
- Kubernetes v1.35 Release Announcement — Официальный анонс релиза 1.35 от 17 декабря 2025 года (60 улучшений, из них 17 stable): https://kubernetes.io/blog/2025/12/17/kubernetes-v1-35-release/
- Kubernetes Releases — поддерживаемые версии — Актуальный список поддерживаемых минорных релизов на сентябрь 2026: 1.37 (2026-08-26), 1.36, 1.35 (EOL 2027-02-28): https://kubernetes.io/releases/
- Cilium Documentation — Kube-Proxy Replacement — Раздел «Traffic Distribution and Topology Aware Hints»: включение через Helm-опцию loadBalancer.serviceTopology=true, маршрутизация к эндпоинтам в той же зоне по хинтам EndpointSlice: https://docs.cilium.io/en/stable/network/kubernetes/kubeproxy-free/