
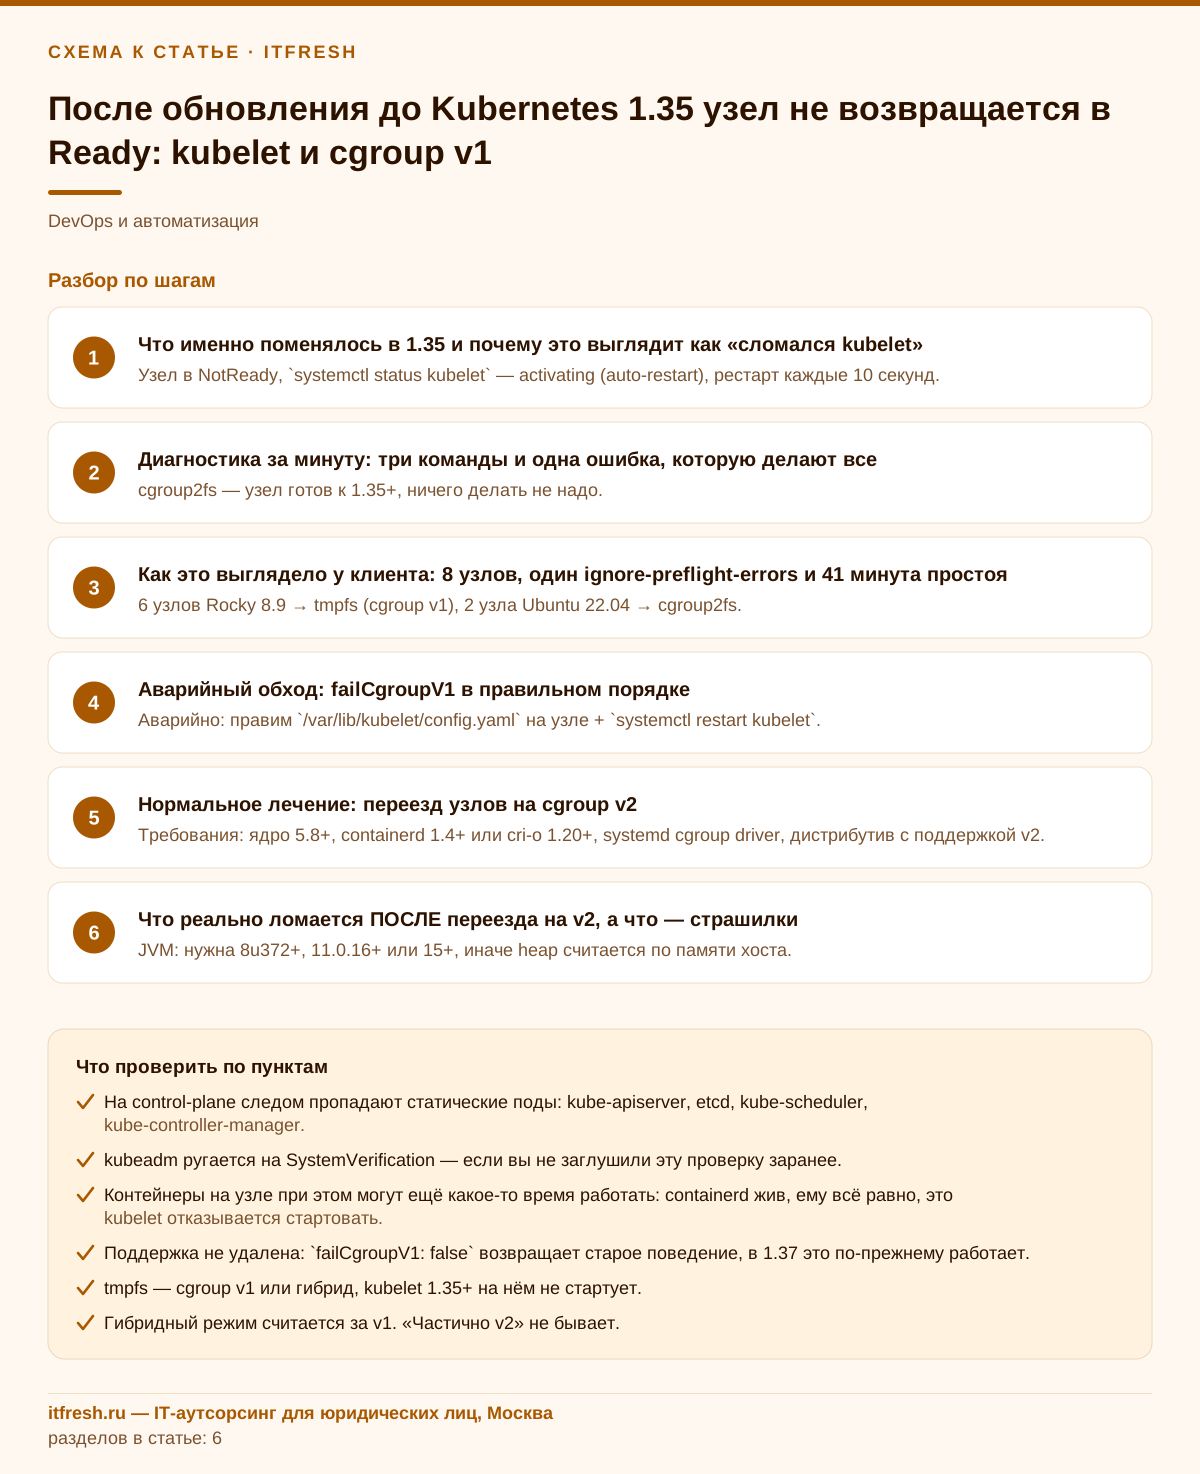
После обновления до Kubernetes 1.35 узел не возвращается в Ready: kubelet и cgroup v1
Обновление прошло «успешно»: пакеты встали, kubeadm отчитался, узел ушёл в перезагрузку — и не вернулся. kubectl показывает NotReady, kubelet в состоянии activating (auto-restart) и падает по кругу. Никакого «поддержка удалена» в логах нет, поэтому админ идёт искать сломанный containerd, протухший сертификат и битый CNI. А дело в одной строчке настройки, которая в 1.35 сменила значение по умолчанию. Ниже — как это опознать за минуту, как поднять узел прямо сейчас, как правильно обновляться, чтобы не повторилось, и что реально ломается после переезда на cgroup v2.
Что именно поменялось в 1.35 и почему это выглядит как «сломался kubelet»
Начиная с Kubernetes 1.35 cgroup v1 официально в состоянии Deprecated, и вместе с этим статусом изменилось поведение по умолчанию. Опция kubelet-конфига failCgroupV1 раньше была равна false — kubelet видел cgroup v1, писал предупреждение в лог и работал дальше. Теперь она по умолчанию true. Формулировка в документации прямая: kubelet больше не запускается на узле с cgroup v1 по умолчанию, а чтобы это отключить, администратор кластера должен выставить failCgroupV1 в false в файле конфигурации kubelet.
Ключевое, что сбивает людей с толку: поддержка cgroup v1 НЕ удалена. Код на месте, флаг работает. В KEP-5573 «Remove cgroup v1» (SIG Node) прямо записано: сейчас — депрекация и смена дефолта FailCgroupV1 на true (PR #134298), а само удаление кода — не раньше 1.38, по общей политике депрекации Kubernetes. Релиз 1.37 уже вышел 26 августа 2026, и по плану KEP в нём обход ещё обязан работать — то есть время у вас есть. Так что если вы читаете эту статью в состоянии «у нас всё лежит» — выдохните, узел поднимается за пять минут.
Почему это ощущается как поломка, а не как депрекация. Во-первых, сообщение уезжает в журнал systemd-юнита, а не в вывод kubeadm или kubectl — там вы видите только NotReady. Во-вторых, kubelet в этот момент не стартует вообще, поэтому на control-plane-узле следом ложатся статические поды: kube-apiserver, etcd, controller-manager, scheduler. Внешне это выглядит как «умер весь кластер», а не «одна настройка сменила дефолт». В-третьих, текст ошибки в разных сборках слегка плавает и содержит слово cgroup, но не содержит слов «обновите ОС», поэтому глазами по логу его легко проскочить.
Отдельная засада — kubeadm. В 1.35 preflight-проверка SystemVerification выдаёт именно ошибку (а не предупреждение), если на хосте обнаружен cgroups v1 и целевая версия kubelet — 1.35 или новее. Для старого kubelet это по-прежнему предупреждение. То есть kubeadm честно пытается остановить вас ДО того, как вы разнесёте узел. Проблема в том, что половина админов уже на автомате дописывает --ignore-preflight-errors во все команды, потому что там вечно ругань про своп и число ядер. Вот на этом рефлексе всё и падает.
Почему это случилось именно сейчас, а не «когда-нибудь». Толчком стал systemd: в NEWS к версии 258 в разделе несовместимых изменений записано, что поддержка cgroup v1 (иерархии legacy и hybrid) удалена и cgroup v2 монтируется при загрузке всегда. В треде «cgroup v1 deprecation» в рассылке SIG Cluster Lifecycle (октябрь 2025) авторы KEP ссылаются именно на это: свежие дистрибутивы с systemd 258+ в режиме v1 просто не загрузятся, а держать в kubelet ветку кода, которую никто не тестирует, дальше смысла нет.
- Узел в NotReady, `systemctl status kubelet` — activating (auto-restart), рестарт каждые 10 секунд.
- На control-plane следом пропадают статические поды: kube-apiserver, etcd, kube-scheduler, kube-controller-manager.
- kubeadm ругается на SystemVerification — если вы не заглушили эту проверку заранее.
- Контейнеры на узле при этом могут ещё какое-то время работать: containerd жив, ему всё равно, это kubelet отказывается стартовать.
- Поддержка не удалена: `failCgroupV1: false` возвращает старое поведение, удаление по KEP-5573 — не раньше 1.38.
Диагностика за минуту: три команды и одна ошибка, которую делают все
Первое — версия cgroup на конкретном узле. Команда одна, ответ однозначный:
stat -fc %T /sys/fs/cgroup/
# cgroup2fs -> cgroup v2, всё хорошо
# tmpfs     -> cgroup v1 (или гибридный режим), это ваш случай
Вот здесь и живёт ошибка, которую делают почти все, кого я разбирал. Гибридный режим (когда часть контроллеров смонтирована по v2, а часть по v1 — так по умолчанию работала Ubuntu 20.04; RHEL/CentOS 7 и 8 по умолчанию вообще в чистом v1) отдаёт tmpfs. То есть «у нас же есть /sys/fs/cgroup/unified, значит v2» — неверно. Для kubelet гибрид это v1, точка. Никаких полутонов.
Второе — подтвердить причину в журнале, а не гадать:
journalctl -u kubelet -n 200 --no-pager | grep -i -e cgroup -e 'failed to run Kubelet'
systemctl status kubelet --no-pager -l
Точный текст сообщения от сборки к сборке слегка отличается, поэтому я и грепаю по подстроке cgroup, а не по всей фразе целиком. Если в выводе есть строка про cgroup v1 рядом с «failed to run Kubelet» — диагноз закрыт, дальше не копаем.
Третье и самое полезное — не лечить по одному узлу, а сразу узнать масштаб. Пока кластер ещё жив (то есть ДО обновления, что и есть правильный порядок), прогоните разовый аудит по всем узлам. Мне удобнее не поднимать DaemonSet, а сходить по SSH из инвентаря — быстрее и не мусорит в кластере:
for n in $(kubectl get nodes -o jsonpath='{.items[*].metadata.name}'); do
  printf '%-24s ' "$n"
  ssh -o BatchMode=yes "$n" 'stat -fc %T /sys/fs/cgroup/; . /etc/os-release; echo "$PRETTY_NAME $(uname -r)"' | paste -sd' '
done
Выхлоп этой петли — и есть ваш план работ. Узлы с cgroup2fs можно обновлять хоть сегодня, узлы с tmpfs идут в отдельный список, и вот с ним уже надо что-то решать.
Ещё одна деталь, которую стоит проверить заодно: какой драйвер cgroup у kubelet и у containerd. Если вы всё-таки поедете на v2, драйвер обязан быть systemd с обеих сторон, иначе получите вторую аварию поверх первой:
grep -i cgroupDriver /var/lib/kubelet/config.yaml
grep -rn SystemdCgroup /etc/containerd/config.toml
В kubeadm начиная с 1.22 драйвер systemd для kubelet подставляется по умолчанию, если его не задали явно, но я регулярно вижу узлы, доставленные руками в 2020–2021 годах и с тех пор просто апгрейженные — там встречается cgroupfs.
- cgroup2fs — узел готов к 1.35+, ничего делать не надо.
- tmpfs — cgroup v1 или гибрид, kubelet 1.35+ на нём не стартует.
- Гибридный режим считается за v1. «Частично v2» не бывает.
- Проверяйте ДО апгрейда: после апгрейда у вас может не быть работающего kubectl.
- Заодно сверьте cgroupDriver у kubelet и SystemdCgroup у containerd — они понадобятся на следующем шаге.
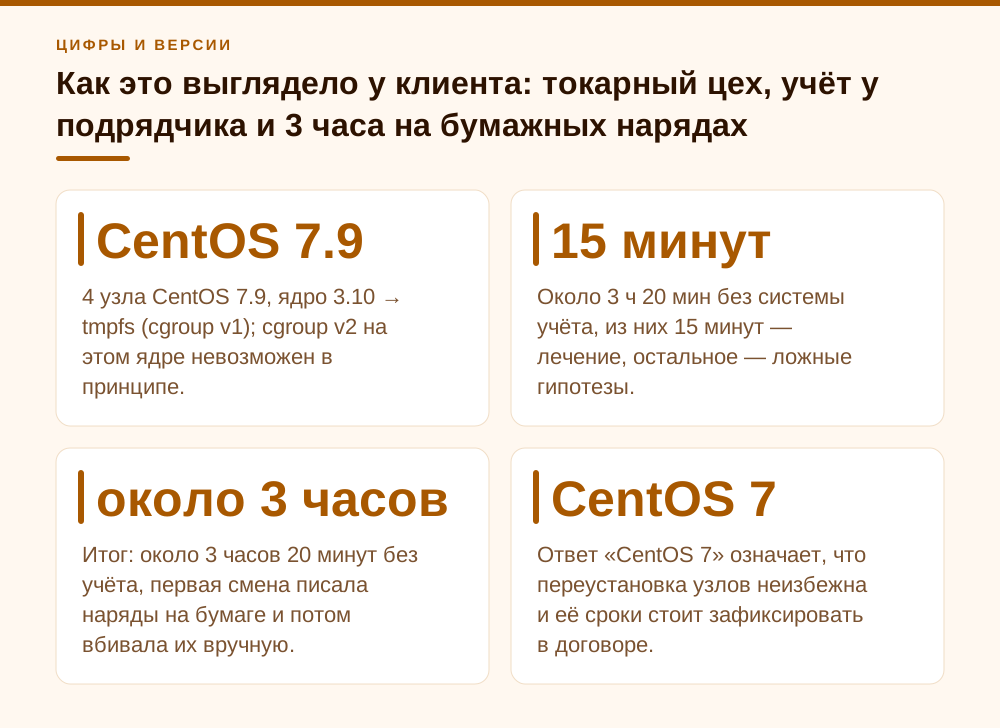
Как это выглядело у клиента: токарный цех, учёт у подрядчика и 3 часа на бумажных нарядах
Клиент — металлообработка «Токарный цех», 48 рабочих мест: офис, мастера участков, склад заготовок и ОТК. Офисную инфраструктуру ведём мы, а систему учёта производства — сменные задания, наряды, движение заготовок и остатки металла — клиент купил у отраслевого подрядчика. Подрядчик держит её у себя в небольшом kubeadm-кластере: один control-plane и три воркера, все на CentOS 7.9 с ядром 3.10.0-1160, containerd 1.6, calico, база PostgreSQL вынесена на отдельную ВМ. К самому кластеру у нас доступа нет и не было, говорю честно: мы видели проблему со стороны клиента, а руками чинил подрядчик по нашей подсказке.
В пятницу вечером подрядчик обновлял кластер с 1.34 на 1.35. На kubeadm upgrade plan вылезла ошибка SystemVerification про cgroups v1, и инженер поступил так, как поступает большинство: решил, что это очередная ругань про swap, и добавил --ignore-preflight-errors=SystemVerification. Пакеты kubelet и kubeadm обновились, kubeadm upgrade apply переписал /var/lib/kubelet/config.yaml из ConfigMap kube-system/kubelet-config и перезапустил kubelet. Kubelet 1.35 увидел tmpfs и не поднялся, а вместе с ним погасли статические поды kube-apiserver и etcd. Control-plane был один — значит, API не стало вообще, и kubectl молчал.
Утром в субботу первая смена не смогла открыть сменные задания: веб-интерфейс учёта отдавал 502. Мастер позвонил нам, мы за десять минут убедились, что офисная сеть, DNS и канал до подрядчика в порядке, а падает сам ingress на их стороне, и дозвонились до дежурного подрядчика. Тот уже час копал containerd и сертификаты. Мы попросили выполнить на узле stat -fc %T /sys/fs/cgroup/ и journalctl -u kubelet | grep -i cgroup — ответ tmpfs и строка про cgroup v1 закрыли вопрос.
Дальше по порядку из этой статьи: через консоль гипервизора дописали failCgroupV1: false в локальный конфиг kubelet на control-plane, перезапустили kubelet, через минуту вернулись apiserver и etcd. Затем та же строка ушла в ConfigMap, и только после этого подрядчик обновил воркеры по одному. Итог: около 3 часов 20 минут без учёта, первая смена писала наряды на бумаге и потом вбивала их вручную. Собственно лечение заняло 15 минут, остальное — поиск не там. Главный вывод для клиента неприятный: на CentOS 7 с ядром 3.10 cgroup v2 не включить никаким параметром, так что обход — это отсрочка, а узлы подрядчику предстоит переустановить до 1.38.
- 4 узла CentOS 7.9, ядро 3.10 → tmpfs (cgroup v1); cgroup v2 на этом ядре невозможен в принципе.
- `--ignore-preflight-errors=SystemVerification` без правки ConfigMap = гарантированный NotReady на 1.35.
- Один control-plane: вместе с kubelet ушли apiserver и etcd, чинить можно было только с консоли узла.
- Около 3 ч 20 мин без системы учёта, из них 15 минут — лечение, остальное — ложные гипотезы.
- В договор с подрядчиком добавили пункт: переустановка узлов на ОС с cgroup v2 до обновления на 1.38 и уведомление клиента перед каждым апгрейдом кластера.
Аварийный обход: failCgroupV1 в правильном порядке
Если узел уже лежит — поднимаем локально, кластер для этого не нужен:
# на самом узле, под root
cp /var/lib/kubelet/config.yaml /root/kubelet-config.yaml.bak
printf 'failCgroupV1: false\n' >> /var/lib/kubelet/config.yaml
systemctl restart kubelet
systemctl status kubelet --no-pager -l
Это верхнеуровневое поле KubeletConfiguration, так что дописать его в конец файла достаточно — лишь бы отступов не было. Через 30–60 секунд узел вернётся в Ready. На control-plane следом сами поднимутся статические поды.
Локальной правки мало: она живёт до следующего kubeadm upgrade node, который заново развернёт конфиг из ConfigMap. Поэтому сразу закрепляем в кластере — и именно этот шаг release notes 1.35 предписывают делать ДО обновления:
kubectl -n kube-system edit configmap kubelet-config
# внутри data.kubelet, на верхнем уровне KubeletConfiguration:
#   failCgroupV1: false
Проверить, что попало куда надо:
kubectl -n kube-system get cm kubelet-config -o jsonpath='{.data.kubelet}' | grep -n failCgroupV1Правильная последовательность для планового обновления кластера, где есть узлы на cgroup v1, выглядит так. Сначала правим ConfigMap. Потом обновляем control-plane с явным исключением одной проверки (не всех сразу — только SystemVerification, и только осознанно). Потом воркеры по одному:
# 1. ConfigMap уже поправлен и проверен
# 2. первый control-plane
kubeadm upgrade apply v1.35.2 --ignore-preflight-errors=SystemVerification
# 3. остальные узлы
kubectl drain <node> --ignore-daemonsets --delete-emptydir-data
kubeadm upgrade node --ignore-preflight-errors=SystemVerification
systemctl daemon-reload && systemctl restart kubelet
kubectl uncordon <node>
После каждого узла — kubectl get nodes -o wide и убедиться, что он реально Ready, прежде чем трогать следующий. Не гоняйте это циклом по всему инвентарю: массовое обновление несовместимых узлов разом выносит рабочую ёмкость кластера, и вы получаете не одну аварию, а каскад из вытеснения подов на оставшиеся узлы.
И честно про статус этого обхода. Это костыль с известным сроком годности. Он не даёт вам ничего, кроме отсрочки: узел на cgroup v1 навсегда остаётся без функций, которые в v2 считаются базовыми — memory QoS с memory.min/memory.low, PSI-метрики давления по CPU, памяти и I/O. Разрыв в возможностях растёт с каждым релизом молча, вы его не замечаете, пока не полезете разбирать, почему под с лимитом памяти ведёт себя странно. Поэтому failCgroupV1: false — это строка в тикете «переехать до такого-то числа», а не решение.
- Аварийно: правим `/var/lib/kubelet/config.yaml` на узле + `systemctl restart kubelet`.
- Надёжно: `failCgroupV1: false` в ConfigMap `kube-system/kubelet-config`, и это делается ДО апгрейда.
- `--ignore-preflight-errors=SystemVerification` — только точечно и только после того, как ConfigMap поправлен.
- Узлы обновляем по одному, с drain/uncordon и проверкой Ready между ними.
- Ставьте себе дату переезда сразу же — иначе костыль переживёт вас в этой компании.
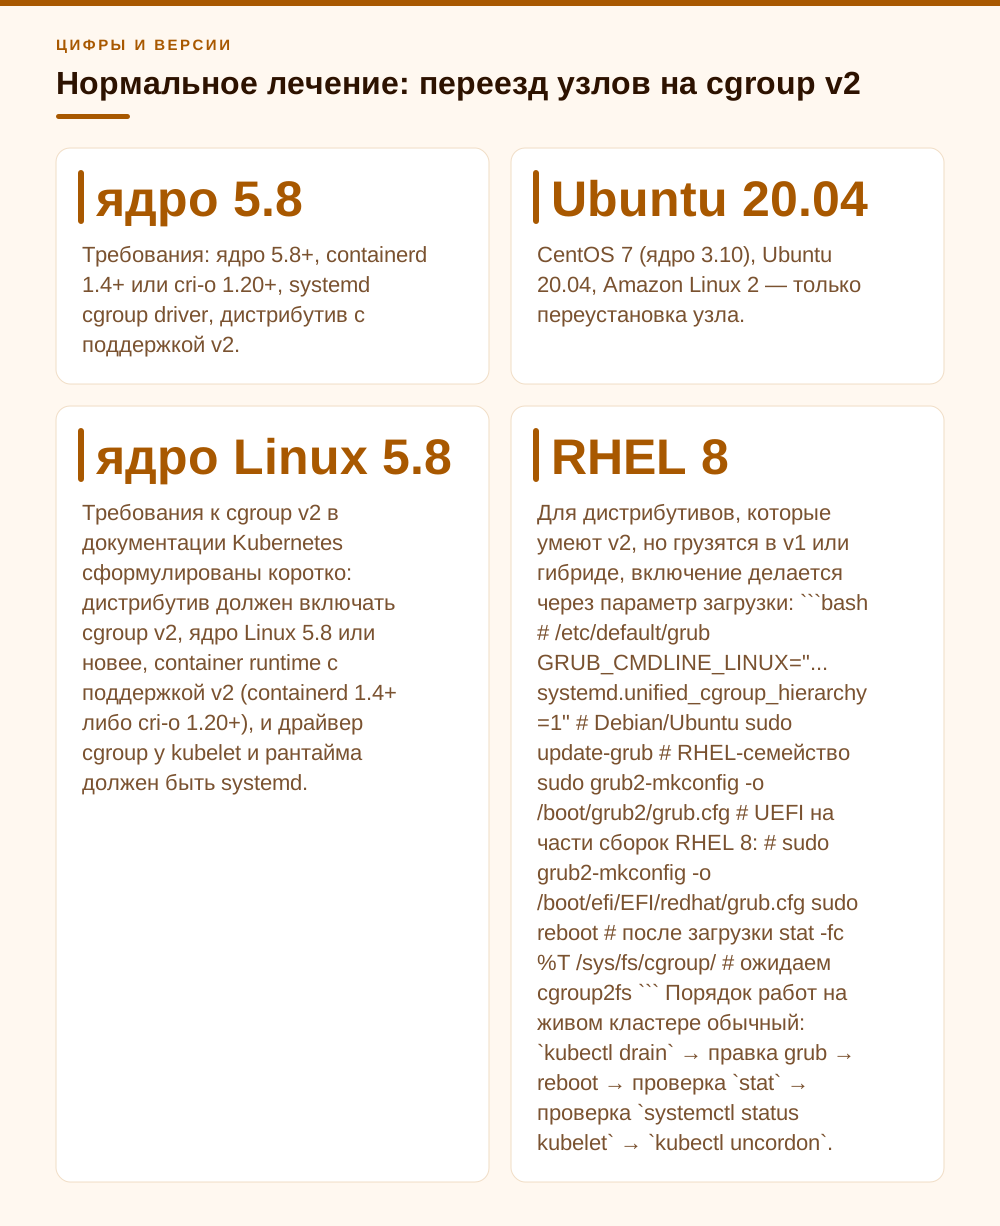
Нормальное лечение: переезд узлов на cgroup v2
Требования к cgroup v2 в документации Kubernetes сформулированы коротко: дистрибутив должен включать cgroup v2, ядро Linux 5.8 или новее, container runtime с поддержкой v2 (containerd 1.4+ либо cri-o 1.20+), и драйвер cgroup у kubelet и рантайма должен быть systemd. Если по этим четырём пунктам всё в порядке — переезд сводится к одному параметру ядра и перезагрузке. Если не в порядке хотя бы по ядру — переезд сводится к переустановке узла, и лучше принять это сразу.
Для дистрибутивов, которые умеют v2, но грузятся в v1 или гибриде, включение делается через параметр загрузки:
# /etc/default/grub
GRUB_CMDLINE_LINUX="... systemd.unified_cgroup_hierarchy=1"

# Debian/Ubuntu
sudo update-grub
# RHEL-семейство
sudo grub2-mkconfig -o /boot/grub2/grub.cfg
# UEFI на части сборок RHEL 8:
# sudo grub2-mkconfig -o /boot/efi/EFI/redhat/grub.cfg

sudo reboot
# после загрузки
stat -fc %T /sys/fs/cgroup/   # ожидаем cgroup2fs
Порядок работ на живом кластере обычный: kubectl drain → правка grub → reboot → проверка stat → проверка systemctl status kubelet → kubectl uncordon. Один узел за раз, и обязательно с оглядкой на PodDisruptionBudget, иначе drain повиснет и вы будете думать, что сломали что-то ещё.
Отдельно про cgroup driver — это второй по частоте способ уронить узел на этом же шаге. На cgroup v2 работать надо через systemd-драйвер. Если у вас в containerd стоит SystemdCgroup = false, а kubelet при этом переехал на v2, вы получите узел, который вроде бы Ready, но поды на нём валятся с невнятными ошибками рантайма. Проверяйте до перезагрузки:
# containerd 1.7 (config version = 2)
# [plugins."io.containerd.grpc.v1.cri".containerd.runtimes.runc.options]
#   SystemdCgroup = true
# containerd 2.x (config version = 3) — секция io.containerd.cri.v1.runtime
grep -rn 'SystemdCgroup' /etc/containerd/config.toml
systemctl restart containerd
И в /var/lib/kubelet/config.yaml должно быть cgroupDriver: systemd.
Теперь про то, что я говорю клиентам прямо, потому что это спорное место. Дистрибутивы, где v2 включён по умолчанию — Ubuntu с 21.10 (на практике 22.04+), Debian 11+, Fedora 31+, Arch Linux, Container-Optimized OS, RHEL 9 и его клоны. Проблема — не в них, а в RHEL 8 / Rocky 8 / AlmaLinux 8 с ядром 4.18: технически cgroup v2 там включается тем же параметром и в большинстве случаев заводится, потому что Red Hat много чего забэкпортил. Но 4.18 формально ниже планки «ядро 5.8 или новее» из документации Kubernetes. Моя позиция: как аварийная мера — флаг допустим, гоняйте на стенде и смотрите; как долгосрочное решение для продакшена — нет, переустанавливайте узел на 9-ку. Спорить с вендором о поддержке конфигурации, которая off-label и там и там, вы будете ровно в тот момент, когда меньше всего этого хотите. А CentOS 7 (EOL с 30 июня 2024, ядро 3.10, systemd 219) обсуждать вообще нечего: полноценного cgroup v2 на этом ядре нет, флаг загрузки ничего не даст — только переустановка. С Ubuntu 20.04 и Amazon Linux 2 то же самое по сути: штатное GA-ядро 5.4 на 20.04 ниже планки 5.8, а поддержка обеих ОС уже закончилась или заканчивается.
И обратная сторона, о которой стоит помнить при выборе ОС для новых узлов. Дистрибутивы на systemd 258 и новее (по NEWS: удалены иерархии legacy и hybrid, минимальное ядро поднято до 5.4) в режиме v1 уже не загрузятся вовсе — параметр systemd.unified_cgroup_hierarchy=0 там больше не работает. То есть на свежей ОС вопрос «оставить v1 и выставить failCgroupV1: false» просто не стоит: переустановка узла автоматически решает и проблему cgroup, и проблему устаревшего ядра.
- Требования: ядро 5.8+, containerd 1.4+ или cri-o 1.20+, systemd cgroup driver, дистрибутив с поддержкой v2.
- Включение: `systemd.unified_cgroup_hierarchy=1` в GRUB_CMDLINE_LINUX + пересборка grub + reboot.
- Уже v2 из коробки: Ubuntu 22.04+, Debian 11+, Fedora 31+, RHEL 9 и клоны; на systemd 258+ v1 нет вовсе.
- RHEL/Rocky/Alma 8: флаг сработает, но ядро 4.18 ниже документированного минимума — как временная мера да, как прод нет.
- CentOS 7 (ядро 3.10), Ubuntu 20.04, Amazon Linux 2 — только переустановка узла.
Что реально ломается ПОСЛЕ переезда на v2, а что — страшилки
Первое и единственное, из-за чего я видел настоящие проблемы: старые JVM в контейнерах. До определённых версий Java не умела читать лимиты контейнера через cgroup v2 и видела память всего хоста. Итог — под с лимитом 2 ГБ выставляет себе heap исходя из 128 ГБ хоста и получает OOMKilled на ровном месте, причём не сразу, а под нагрузкой. Поддержка cgroup v2 появилась в JDK 15 и была бэкпортирована в 11.0.16 и 8u372. Если у вас в кластере крутится приложение на OpenJDK 8 старого билда — проверьте версию до миграции, а не после. Лечится обновлением базового образа либо явным -Xmx вместо -XX:MaxRAMPercentage.
Второе — самописный мониторинг и старые экспортёры, которые ходят в файлы напрямую. На v1 это были /sys/fs/cgroup/memory/memory.limit_in_bytes и memory.usage_in_bytes, на v2 — memory.max и memory.current, и путь другой. Скрипт, который парсил v1-пути, после переезда молча отдаёт пустоту или ноль. Я такое ловил на кастомных health-check'ах и на самодельных алертах «память пода выше 80 %»: алерт просто перестаёт срабатывать, и это хуже, чем если бы он падал с ошибкой. Свежие cAdvisor, node_exporter и kube-state-metrics с этим давно в порядке — вопрос ровно к самописному.
Третье, про что спрашивают чаще всего и зря волнуются: «а поды не поедут?». Не поедут. Спецификации подов, лимиты, requests, QoS-классы — всё описано в API и от версии cgroup не зависит. Ядро просто применяет их через другой интерфейс. Приложение внутри контейнера в подавляющем большинстве случаев вообще не замечает разницы. Единственное «но» — приложения, которые сами лезут в /sys/fs/cgroup, и их в обычном корпоративном кластере на 20–50 подов ровно ноль штук, если только у вас нет своего агента.
И приятная часть, ради которой это вообще стоит делать не из-под палки. На v2 вы получаете PSI-метрики — реальное давление по CPU, памяти и I/O, а не косвенные догадки по utilization. Получаете нормальный memory QoS с memory.min и memory.low, то есть возможность защитить критичный под от того, чтобы его страницы вымыло соседом. Получаете единую иерархию вместо десятка независимых деревьев контроллеров, что заметно упрощает разбор инцидентов «кто съел память на узле». На v1 всего этого нет и не будет.
- JVM: нужна 8u372+, 11.0.16+ или 15+, иначе heap считается по памяти хоста.
- Пути cgroup сменились: `memory.limit_in_bytes` → `memory.max`, `memory.usage_in_bytes` → `memory.current`.
- Самописные скрипты и алерты, читающие /sys/fs/cgroup, отдают тишину — проверяйте их отдельно.
- Манифесты подов, лимиты и QoS править не нужно вообще.
- Бонус v2: PSI-метрики, memory.min/memory.low, единая иерархия.
Порядок действий: что делать в первую очередь, а на что можно забить
Если у вас всё лежит прямо сейчас — по пунктам: stat -fc %T /sys/fs/cgroup/ на упавшем узле, при tmpfs дописать failCgroupV1: false в /var/lib/kubelet/config.yaml, systemctl restart kubelet, дождаться Ready, затем внести ту же строку в ConfigMap kube-system/kubelet-config и только после этого продолжать обновление. Остановите массовое обновление остальных узлов, пока не сделаете второй шаг: каждый следующий узел ляжет ровно так же, и в какой-то момент у вас кончится ёмкость под вытесняемые поды.
Если вы ещё не обновлялись — это лучший вариант, и если кластер ведёт подрядчик, начните с письма ему с вопросом про ОС узлов, и делать надо в другом порядке. Сначала аудит: пробежать по всем узлам и разложить их на две кучки, cgroup2fs и tmpfs. Дальше по узлам с tmpfs решить, что с ними: если это Ubuntu 22.04+/Debian 11+/RHEL 9 в гибриде — просто флаг в grub и перезагрузка, это работа на полчаса. Если CentOS 7, Ubuntu 20.04 или Amazon Linux 2 — планируйте переустановку, обход через failCgroupV1: false даёт передышку до 1.38, но узел всё равно придётся трогать. Обновление кластера начинайте только после того, как ConfigMap поправлен.
На что можно забить с чистой совестью. Не надо срочно переписывать манифесты, менять лимиты и requests, пересобирать образы «под v2» — это не требуется. Не надо в панике мигрировать всё за одну ночь: по KEP-5573 удаление cgroup v1 из kubelet запланировано не раньше 1.38, а до тех пор failCgroupV1: false остаётся рабочим вариантом. Не надо трогать узлы, которые уже отвечают cgroup2fs — там работы нет. И совершенно точно не надо откатывать кластер на 1.34: вы потеряете время и уйдёте из окна поддержки, ничего не выиграв.
Что я закладываю в план у себя. Раз в квартал — прогон аудита узлов по cgroup и ядру, вместе с проверкой версий containerd. Перед каждым минорным апгрейдом Kubernetes — обязательный kubeadm upgrade plan на стенде, а не на проде, и внимательное чтение секции deprecations в release notes, а не только заголовков про новые фичи. И правило, которое сэкономило нам не один вечер: --ignore-preflight-errors пишется только с конкретным именем проверки и только после того, как понято, что именно эта проверка ловит. Пустой --ignore-preflight-errors=all в проде — это не ускорение работы, это отложенная авария.
- Горит: stat → failCgroupV1 локально → restart kubelet → ConfigMap → продолжать по одному узлу.
- Не горит, но обязательно: аудит cgroup по всем узлам и решение по каждому tmpfs-узлу.
- Планово: переезд на дистрибутив с cgroup v2 по умолчанию, drain/uncordon, один узел за раз.
- Не делать: откат кластера, переписывание манифестов, миграция всего за ночь.
- Навсегда: никаких `--ignore-preflight-errors=all` на боевом кластере.
Частые вопросы
Поддержку cgroup v1 в Kubernetes 1.35 удалили или нет?
Не удалили — депрекировали. С 1.35 опция kubelet `failCgroupV1` по умолчанию равна true (PR #134298), поэтому kubelet отказывается стартовать на узле с cgroup v1. Выставив `failCgroupV1: false`, вы возвращаете прежнее поведение. По KEP-5573 полное удаление поддержки cgroup v1 из kubelet запланировано не раньше версии 1.38.
Как быстро понять, что дело именно в cgroup, а не в containerd или сертификатах?
Выполните на узле `stat -fc %T /sys/fs/cgroup/`. Ответ cgroup2fs — версия cgroup ни при чём, ищите дальше. Ответ tmpfs — это ваш случай, cgroup v1 или гибридный режим. Подтвердить можно командой `journalctl -u kubelet -n 200 --no-pager | grep -i cgroup`: точная формулировка ошибки от сборки к сборке немного отличается, поэтому грепать лучше по подстроке cgroup, а не по фразе целиком.
Куда именно писать failCgroupV1: false — в файл на узле или в ConfigMap?
В оба места, но с разными целями. Локальный `/var/lib/kubelet/config.yaml` — это аварийное поднятие узла прямо сейчас, оно работает даже когда API-сервер недоступен. ConfigMap `kube-system/kubelet-config` — это долговременная фиксация: без неё следующий `kubeadm upgrade node` перезапишет локальный файл и узел ляжет снова. При плановом обновлении ConfigMap правится ДО апгрейда.
Можно ли переключить на cgroup v2 узел на Rocky Linux 8 или RHEL 8?
Технически да: параметр `systemd.unified_cgroup_hierarchy=1` в GRUB_CMDLINE_LINUX, пересборка конфига grub и перезагрузка. Но ядро 4.18 в этой ветке ниже документированного минимума Kubernetes «5.8 или новее», хотя Red Hat много чего забэкпортил. Моя рекомендация: как временная мера — допустимо после проверки на стенде, как долгосрочное решение для продакшена — переустанавливайте узел на RHEL 9 или его клон.
Что сломается в приложениях после перехода на cgroup v2?
Манифесты, лимиты, requests и QoS-классы менять не нужно вообще. Реально ломаются две вещи: старые JVM, которые не читают лимиты через cgroup v2 (нужны 8u372+, 11.0.16+ или 15+, иначе heap считается по памяти хоста и приложение ловит OOMKilled), и самописные скрипты и алерты, читающие `/sys/fs/cgroup` напрямую — пути и имена файлов изменились, `memory.limit_in_bytes` стал `memory.max`.
Почему kubeadm заблокировал обновление, а не просто предупредил?
Так решили осознанно в SIG Cluster Lifecycle: в 1.35 проверка SystemVerification даёт ошибку, если на хосте обнаружены cgroups v1 и целевая версия kubelet — 1.35 или новее. Логика простая: лучше остановить администратора на preflight, чем дать ему обновиться и получить падение kubelet в логах уже после того, как статические поды control-plane пропали. Для более старого kubelet это по-прежнему предупреждение.
Наша учётная система у подрядчика в Kubernetes на CentOS 7. Что делать?
Спросить подрядчика, поправлен ли `failCgroupV1: false` в ConfigMap `kube-system/kubelet-config` перед обновлением на 1.35, и зафиксировать срок переустановки узлов. На CentOS 7 ядро 3.10, cgroup v2 там не включить, поэтому единственный долгосрочный путь — новые узлы на Rocky/Alma 9 или Ubuntu 22.04/24.04 до обновления кластера на 1.38.
Источники
- Kubernetes 1.35 — Upgrade A Cluster — Официальная документация Kubernetes v1.35, раздел Tasks → Administer a Cluster → Upgrade A Cluster: «On Linux nodes, the kubelet defaults to supporting only cgroups v2. For Kubernetes 1.35 the FailCgroupV1 kubelet configuration option is set to true by default». https://v1-35.docs.kubernetes.io/docs/tasks/administer-cluster/cluster-upgrade/
- Kubernetes — About cgroup v2 / Deprecation of cgroup v1 — Концептуальная документация Kubernetes, Concepts → Cluster Architecture → cgroups: статус Deprecated с v1.35, требования к cgroup v2 (ядро 5.8+, containerd v1.4+, cri-o v1.20+, systemd cgroup driver), проверка `stat -fc %T /sys/fs/cgroup/`, миграция через `systemd.unified_cgroup_hierarchy=1`. https://kubernetes.io/docs/concepts/architecture/cgroups/
- Kubernetes dev mailing list — v1.35.0 release notes — Анонс «Kubernetes v1.35.0 is live!» в рассылке dev@kubernetes.io от 17.12.2025: preflight-проверка kubeadm SystemVerification выдаёт ошибку при cgroups v1 и kubelet v1.35+; нужно проигнорировать эту проверку и добавить failCgroupV1: false в ConfigMap kube-system/kubelet-config до обновления. https://groups.google.com/a/kubernetes.io/g/dev/c/z1uOCVCOsxA
- Kubernetes SIG Cluster Lifecycle — обсуждение депрекации cgroup v1 — Тред «cgroup v1 deprecation» (октябрь 2025): предложение KEP сделать failCgroupV1=true в 1.35 со ссылкой на удаление cgroup v1 в systemd 258, PR #134298, обновление system-validators в kubeadm (ошибка вместо предупреждения на preflight). https://groups.google.com/a/kubernetes.io/g/sig-cluster-lifecycle/c/RxKW1cNK1rg
- KEP-5573: Remove cgroup v1 (SIG Node) — Kubernetes Enhancement Proposal: смена дефолта FailCgroupV1 на true (cgroup v1 выключен по умолчанию), полное удаление — не раньше v1.38 по deprecation policy. https://github.com/kubernetes/enhancements/tree/master/keps/sig-node/5573-remove-cgroup-v1
- Kubernetes CHANGELOG-1.35 — Раздел v1.35.0, Urgent Upgrade Notes: «failCgroupV1 will be set to true from 1.35» (PR #134298) и kubeadm/system-validators v1.12.1 — ошибка SystemVerification при cgroups v1 (PR #134744). https://github.com/kubernetes/kubernetes/blob/master/CHANGELOG/CHANGELOG-1.35.md
- systemd NEWS — CHANGES WITH 258 — Incompatible changes: «Support for cgroup v1 ('legacy' and 'hybrid' hierarchies) has been removed», минимальное ядро поднято до v5.4. https://github.com/systemd/systemd/blob/v258/NEWS