
Как я переношу фильтрацию Docker на nftables без DOCKER-USER
После переключения Docker на nftables приложение открывается. Только теперь оно открывается и у тех, кому раньше было запрещено. Я, Семёнов Евгений Сергеевич, директор ООО «АйТи-Фреш», начинаю такую миграцию с проверки запрещённых подключений. Ниже покажу сисадмину рабочую схему фильтрации, разберу её на изолированном стенде и объясню, как пережить перезапуск без потери защиты.
1. Сначала выясняю, действительно ли меняется backend
Надпись (nf_tables) в выводе iptables --version легко сбивает с толку. Это совместимый интерфейс iptables поверх nftables; Docker при этом может продолжать использовать backend iptables и создавать DOCKER-USER. Переключение alternatives само по себе задачу не решает. Я смотрю серверную версию в docker version, поле Firewall Backend в docker info, конфигурацию daemon и фактические таблицы. Начинать с удаления старых цепочек здесь рано.
Нативный backend nftables появился в Docker Engine 29.0.0. На 5 сентября 2026 года опубликован Engine 29.8.0, но документация всё ещё помечает backend как экспериментальный. В Swarm его включать нельзя. Дальше я рассматриваю rootful Docker на Linux с bridge-сетями; для rootless, host networking и macvlan этот конфиг не является готовым рецептом. Версии Engine, ограничения backend.
Моя позиция простая: если единственная причина перехода — желание увидеть слово nftables, исправно работающий сервер можно оставить в покое. Миграция оправданна, когда вы унифицируете управление firewall и готовы владеть политикой forwarding. Я оставляю Docker управление NAT и его служебными таблицами, а ограничения бизнеса размещаю отдельно. Таблицы ip docker-bridges и ip6 docker-bridges не редактирую: их структура принадлежит Docker и меняется между версиями. Устройство правил Moby.
2. Переношу смысл правил: hook, DNAT и окончательный drop
Для обычного внешнего подключения к опубликованному порту путь такой: prerouting → DNAT → forward → postrouting. Поэтому закрытый порт в input ещё ничего не доказывает: после DNAT пакет направляется контейнеру. Базовая цепочка должна быть привязана к forward. Просто создать цепочку с красивым названием недостаточно — без hook либо перехода из другой цепочки пакеты туда не попадут. Путь пакета в Netfilter.
Я выбираю type filter hook forward priority -10; policy accept;. Она выполняется перед Docker-фильтрацией с приоритетом 0. Меньшее число означает более раннюю обработку в пределах одного hook; forward с отрицательным приоритетом всё равно идёт после prerouting. При одинаковом приоритете на порядок не рассчитываю. И главное: accept завершает текущую базовую цепочку, а другая цепочка ещё может отбросить пакет. Drop окончателен. Отсюда мой подход: собственная цепочка накладывает дополнительные запреты, разрешённое передаёт следующим проверкам. Семантика nftables.
В нашем примере публикация 203.0.113.10:8443 → 172.30.0.2:80. В forward обычное tcp dport уже равно 80. Матч по 8443 промахнётся; если после него стоит accept-политика без закрывающего правила, получится открытый доступ. Для исходного адреса и порта я использую ct original ip daddr и ct original proto-dst. Это свойства исходного направления соединения, сохранённые conntrack. Синтаксис conntrack.
Старые ACCEPT, которые намеренно обходили запреты Docker, требуют отдельного решения. Для такого исключения есть --bridge-accept-fwmark=0x1/0x3: выбранные биты packet mark выставляют до Docker forward-цепочки, предварительно проверив конфликты с VPN и policy routing. Обычный ранний accept этого не заменяет. Но метка не обходит drop в Docker raw-PREROUTING. В предлагаемой схеме обходы не нужны, поэтому fwmark я не включаю. Миграция ACCEPT.
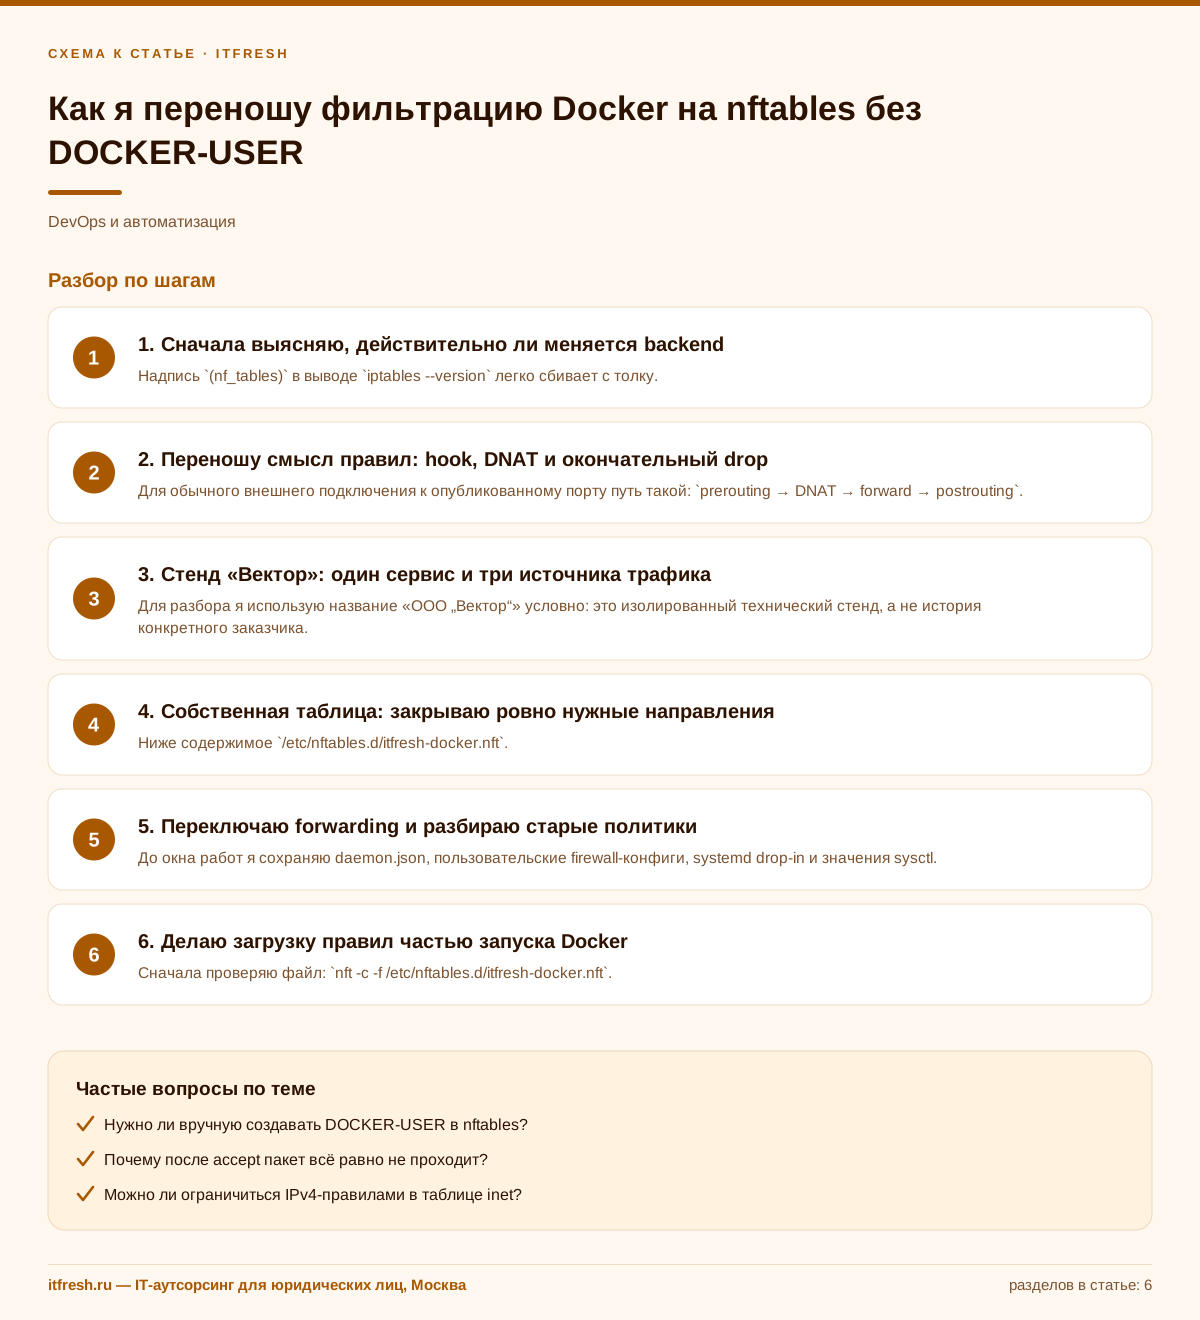
3. Стенд «СумкаПром»: один сервис и три источника трафика
Для разбора я использую название «ООО „СумкаПром“» условно: это изолированный технический стенд, а не история конкретного заказчика. Проверяемая среда — Ubuntu 24.04 LTS, ядро 6.8.0-136-generic, Docker Engine 29.6.0 и nftables 1.0.9. Версию стенда отделяю от актуального релиза: испытание одной сборки не превращается автоматически в испытание всех последующих. Отдельный daemon и сетевые пространства имён позволяют проверять ошибки, не меняя firewall основной системы.
Схема намеренно небольшая. На стороне Docker-хоста ens18 имеет адрес 203.0.113.10, ens19 — 192.0.2.1. Контейнер находится на мосту br-app, адрес — 172.30.0.2. Через ens18 приходят разрешённый клиент 198.51.100.10 и запрещённый 198.51.100.20; через ens19 — клиент 192.0.2.2. Адреса внешних сегментов взяты из документационных диапазонов. Политика: первый клиент получает опубликованный HTTP-сервис, остальные новые подключения к этому мосту запрещены; транзит ens18↔ens19 закрыт.
Для HTTP достаточно локального образа со статическим BusyBox 1.36.1 и файлом /www/index.html. В стенде он называется itfresh-nft-lab:busybox; это подготовленный тестовый образ, не имя для скачивания из публичного registry. Сеть и контейнер создаются так:
docker network create --subnet=172.30.0.0/24 \
  --opt com.docker.network.bridge.name=br-app app-lab
docker run -d --name web-lab --network app-lab --ip 172.30.0.2 \
  -p 203.0.113.10:8443:80 itfresh-nft-lab:busybox \
  /bin/busybox httpd -f -p 80 -h /www
Порт 8443 здесь передаёт обычный HTTP: номер порта не включает TLS. Имя Linux-моста задаю явно, чтобы пересоздание сети не заставляло угадывать очередной br-…. Параметры bridge.
4. Собственная таблица: закрываю ровно нужные направления
Ниже содержимое /etc/nftables.d/itfresh-docker.nft. Все команды администрирования в статье предполагают root. Первые две строки позволяют повторно загрузить именно нашу таблицу без накопления правил. Весь файл применяется одним вызовом nft -f: очистка и заполнение проходят одной транзакцией. Атомарная замена правил.
add table inet itfresh_guard
flush table inet itfresh_guard

table inet itfresh_guard {
  chain forward_guard {
    type filter hook forward priority -10; policy accept;

    iifname { "ens18", "ens19" } oifname "br-app" ct state invalid counter drop
    iifname { "ens18", "ens19" } oifname "br-app" ct state established,related counter accept
    iifname "ens18" oifname "br-app" ip saddr 198.51.100.10 ip daddr 172.30.0.2 tcp dport 80 ct original ip daddr 203.0.113.10 ct original proto-dst 8443 counter accept
    iifname { "ens18", "ens19" } oifname "br-app" counter drop

    iifname "ens18" oifname "ens19" counter drop
    iifname "ens19" oifname "ens18" counter drop
  }
}
Разрешение проверяет источник, фактическое назначение после DNAT и исходную публикацию. Следующее правило закрывает остальной вход с двух интерфейсов на br-app. Такой запас полезен: если завтра кто-то опубликует на этом мосту ещё один контейнер, новая публикация не станет доступной этим клиентам автоматически. Последние два правила отдельно запрещают маршрутизацию между внешними сегментами. Исходящие подключения контейнера и межконтейнерную политику эта таблица не заменяет.
Established/related поставлен перед новым разрешением сознательно: так сохраняются существующие сеансы и ответы на исходящие соединения контейнера. Значит, уже установленный нежелательный сеанс может пережить смену ACL. Для немедленного отзыва доступа нужна отдельная адресная работа с conntrack; глобальный сброс всех соединений я здесь не советую. Проверять запрет надо новым TCP-подключением, а не обновлением вкладки с живым keep-alive.
Таблица inet обрабатывает оба семейства, но разрешающее правило с ip saddr относится только к IPv4. Новые входящие IPv6-соединения с ens18/ens19 на br-app попадут в общий drop. Для dual stack добавьте самостоятельную IPv6-политику и тесты. И проверьте охват: этот конфиг не защищает docker0, другие мосты, VPN-интерфейсы и сервисы самого хоста. Я перечисляю эти границы прямо, иначе локальный пример быстро превращается в ложное обещание общей защиты.
5. Переключаю forwarding и разбираю старые политики
До окна работ я сохраняю daemon.json, пользовательские firewall-конфиги, systemd drop-in и значения sysctl. Для диагностики снимаю nft list ruleset, iptables-save и ip6tables-save, фиксирую маршруты и публикации контейнеров. Проверяю также legacy-вариант iptables, если он установлен и использовался. Дальше останавливаю нагрузку и docker.service вместе с docker.socket; при live-restore отдельно убеждаюсь, что контейнеры действительно остановлены. Доступ к консоли гипервизора держу под рукой.
Сначала загружаю собственную защиту, затем включаю маршрутизацию. В /etc/sysctl.d/90-docker-forwarding.conf для IPv4-сценария записываю net.ipv4.ip_forward=1 и применяю sysctl -p /etc/sysctl.d/90-docker-forwarding.conf. Для IPv6-маршрутизации нужен также net.ipv6.conf.all.forwarding=1. Нативный backend сам forwarding не включает; "ip-forward": false только отключает его проверку. Особенно неприятен случай, когда старый Docker включил forwarding временно: всё работает до перезагрузки. Изменение поведения Engine, назначение sysctl. На стенде я отдельно выставил forwarding в 0: создание новой bridge-сети завершилось ошибкой, значение осталось 0.
В существующий /etc/docker/daemon.json добавляю ключ, сохраняя остальные настройки:
{
  "firewall-backend": "nftables"
}
Перед запуском выполняю dockerd --validate --config-file=/etc/docker/daemon.json и проверяю отсутствие дублирующего флага в systemd. Ключ "iptables": false не нужен: это отключение управления правилами, а не выбор backend. Параметр ip-forward-no-drop также не заменяет собственную политику: native nftables backend и так не устанавливает общий forwarding-drop. Параметры dockerd, политика forwarding.
Старый FORWARD DROP способен заблокировать трафик, принятый nftables. После переноса всех ограничений проверяю iptables -S FORWARD и ip6tables -S FORWARD; только если прежняя политика действительно стала лишней, меняю её соответствующей командой iptables -P FORWARD ACCEPT или ip6tables -P FORWARD ACCEPT. Старый jump в DOCKER-USER тоже может пережить переключение, но после чистого старта больше не появится. Удаляю именно проверенный переход после переноса его логики, например iptables -D FORWARD -j DOCKER-USER, если правило выглядит ровно так. Особенности миграции.
6. Делаю загрузку правил частью запуска Docker
Сначала проверяю файл: nft -c -f /etc/nftables.d/itfresh-docker.nft. Для постоянной загрузки создаю /etc/systemd/system/itfresh-docker-guard.service. Он стартует до настройки сети и не очищает firewall при остановке. Именно для такого порядка предназначен network-pre.target. Порядок запуска firewall в systemd.
[Unit]
Description=ITFresh Docker forwarding policy
DefaultDependencies=no
Wants=network-pre.target
Before=network-pre.target shutdown.target
Conflicts=shutdown.target

[Service]
Type=oneshot
RemainAfterExit=yes
ExecStart=/usr/sbin/nft -f /etc/nftables.d/itfresh-docker.nft
ExecReload=/usr/sbin/nft -f /etc/nftables.d/itfresh-docker.nft

[Install]
WantedBy=sysinit.target
В /etc/systemd/system/docker.service.d/firewall.conf добавляю зависимость. При ошибке первоначальной загрузки guard запуск Docker не должен продолжаться:
[Unit]
Requires=itfresh-docker-guard.service
After=itfresh-docker-guard.service systemd-sysctl.service
После создания файлов выполняю systemctl daemon-reload, затем systemctl enable --now itfresh-docker-guard.service. Проверяю таблицу, применяю sysctl и изменения предыдущего раздела, запускаю systemctl start docker.service и возвращаю нагрузку. Для изменения ACL дальше использую systemctl reload itfresh-docker-guard.service: остановка зависимого сервиса через restart может затронуть Docker. Зависимости systemd.
До включения этой схемы исключаю глобальную очистку ruleset из других загрузчиков. Два сервиса перед network-pre.target могут выполниться в любом порядке; чужой flush ruleset способен стереть уже загруженный guard. В проверенной Ubuntu штатный nftables.service содержит ещё и ExecStop=/usr/sbin/nft flush ruleset, поэтому его нельзя бездумно останавливать рядом с Docker. Проверяю nftables.conf, firewalld и конфигурационный менеджер, закрепляю владельца каждой таблицы. Статус guard active (exited) подтверждает прошлую загрузку, но не обнаруживает последующее удаление правил.
7. Принимаю работу по запретам и проверяю откат
В реальном прогоне все шесть сетевых проверок дали ожидаемый результат. Разрешённый запрос возвращал строку itfresh-nft-lab-ok; после добавления второй forward-цепочки с policy drop он переставал проходить, хотя счётчик нашего accept рос. Удаление тестовой цепочки восстанавливало доступ.
| Проверка | Фактический результат |
| --- | --- |
| 198.51.100.10 → публикация 8443 | HTTP-ответ получен |
| 198.51.100.20 → публикация 8443 | Подключение заблокировано |
| 192.0.2.2 через ens19 → публикация 8443 | Подключение заблокировано |
| 198.51.100.10 → 172.30.0.2:80 напрямую | Заблокировано раньше, в Docker raw-PREROUTING |
| Разрешённый клиент при второй цепочке с policy drop | Подключение заблокировано |
| Разрешённый клиент после удаления второй цепочки | HTTP-ответ снова получен |
Повторная загрузка нашего файла оставила ровно одну цепочку и шесть правил — дубликатов нет. Полную перезагрузку хоста и dual-stack этим изолированным прогоном я не проверял.
Проверку с клиента выполняю, например, командой curl --noproxy '*' --connect-timeout 2 --max-time 3 http://203.0.113.10:8443/. Тот же запрос нужен с запрещённого адреса. Curl с Docker-хоста не заменяет эти проверки: путь локального соединения отличается. Тайм-аут тоже сам по себе не доказательство firewall — смотрю рост нужного counter и при необходимости трассировку.
Для точечного разбора включаю meta nftrace set 1 только для тестового источника в отдельной prerouting-цепочке с priority -301, затем запускаю nft monitor trace. Это позволяет увидеть обработку до ранних Docker-drop; после диагностики удаляю свою временную trace-таблицу. Трассировка nftables. На целевом сервере повторяю матрицу после перезапуска Docker и после полной перезагрузки: доступ разрешённого клиента, запрет остальных, исходящие соединения, DNS, нужный IPv6 и запрет транзита между интерфейсами.
Если нужен откат, останавливаю нагрузку и daemon с socket, возвращаю backend iptables и прежние пользовательские ограничения. Новую таблицу держу до восстановления старой защиты; затем удаляю только её, если она мешает прежней схеме. Не восстанавливаю вслепую динамический дамп поверх работающего Docker. Для меня миграция закончена, когда воспроизводятся и разрешения, и запреты, а следующий администратор понимает, где именно принимается решение.
Частые вопросы
Нужно ли вручную создавать DOCKER-USER в nftables?
Нет. Создайте собственную таблицу с базовой цепочкой на нужном hook. Само имя DOCKER-USER не обеспечивает прохождение трафика.
Почему после accept пакет всё равно не проходит?
Другая базовая цепочка может выдать drop. Проверьте также старую политику iptables FORWARD, маршруты и forwarding.
Можно ли ограничиться IPv4-правилами в таблице inet?
Только если IPv6 сознательно обработан отдельным запретом. Само семейство inet не превращает матч ip saddr в IPv6-правило.
Я помогу проверить вашу схему Docker, перенести ограничения и подготовить проверяемый откат. Обратитесь в «АйТи-Фреш» через itfresh.ru — начнём с действующих правил, маршрутов и списка опубликованных сервисов.
Бесплатная консультация →
Источники
- Docker Docs — Docker with nftables — Нативный backend, миграция DOCKER-USER, FORWARD и bridge-accept-fwmark; документация проверена 05.09.2026.
- Docker Docs — Engine version 29 release notes — 29.0.0 от 10.11.2025; 29.8.0 от 03.09.2026. Стенд использует 29.6.0.
- Docker Docs — dockerd; Packet filtering and firewalls; Bridge network driver — firewall-backend, validate, ip-forward-no-drop и com.docker.network.bridge.name.
- Moby — Docker Engine’s use of nftables — integration/network/bridge/nftablesdoc/index.md: владение таблицами и нестабильность внутренней структуры.
- Netfilter — nft(8), nftables wiki — Hooks, base-chain priorities, accept/drop, conntrack original tuple, атомарная загрузка и nftrace.
- Linux Kernel — IP Sysctl — net.ipv4.ip_forward; net.ipv6.conf.all.forwarding.
- systemd — Network Configuration Synchronization Points; systemd.unit — network-pre.target, Requires и After; документация unit версии v255.