BorgBackup для Linux-серверов офиса: моя схема для клиентов в Москве
На обслуживании — 28 офисов с Linux-серверами: 1С на PostgreSQL, файловые серверы на Samba, веб-сайты на Nginx, корпоративные чаты на Mattermost. На всех этих серверах всегда ставим BorgBackup. Дальше — почему именно его и как мы это настраиваем.
Почему я отказался от rsync, tar и платных решений
Шесть лет назад я пользовался вполне стандартным набором: rsync для файлов, mysqldump для баз, tar для архивов, а для всей нашей VM-инфраструктуры, конечно, Veeam. Мы привыкли, всё работало как часы, никаких проблем. Но однажды, у одного из клиентов — помню, это была типография, 22 рабочих места, и у них крутился 1С на PostgreSQL — внезапно полетел RAID-контроллер. И вот тут-то, друзья, всё и закрутилось.
Бэкапы, как обычно, 'вроде как делались'. Ночью запускался cron-скрипт, который пытался делать mysqldump базы. Только вот незадача: база-то была на PostgreSQL, а скрипт, как выяснилось, накатал какой-то прошлый админ лет пять назад, причём явно под MySQL. Ещё там был rsync на NAS. Когда я приехал спасать ситуацию, восстанавливать что-либо, оказалось вот что:
- mysqldump? На PostgreSQL? Это просто провал! Он не делал никаких бэкапов. Более того, утилита просто молча вылетала с ошибкой, которую, конечно же, никто нигде не логировал. Представьте масштаб проблемы: ты думаешь, что всё в порядке, а на самом деле — пустота.
- rsync? Мы столкнулись с тем, что он копировал файлы базы данных, пока PostgreSQL преспокойно себе работал. Что это означало на практике? Файлы оказывались повреждены, а восстановить базу из таких копий было, увы, уже невозможно. Какой в этом смысл?
- Что же обнаружилось на NAS? Не было вообще никакой истории бэкапов. Доступной оказалась только самая последняя копия. И как назло, она тоже оказалась битой. Можно ли представить себе худшую ситуацию?
У клиента бэкапа не было совсем. Мы месяц вручную восстанавливали базу из логов 1С, и этим занимались оператор с бухгалтером. После такого стало понятно: нужно срочно и серьёзно изучать нормальные, профессиональные инструменты для резервного копирования. Так мы вышли на Borg — теперь это основное решение для всех Linux-машин, без вариантов.
Что мне в нём понравилось:
- Блочная дедупликация. Borg бьёт файлы на куски по 2 MB и хранит их по hash. Если два бэкапа отличаются только парой строк в конфиге, реально хранится только разница.
- Шифрование из коробки. AES-256 + HMAC-SHA256 встроены в формат репозитория. Бэкапы можно безопасно хранить даже на чужом облаке.
- Сжатие. zstd, lz4, lzma — выбираете под свою задачу. Для текстовых данных 1С-выгрузок lzma даёт сжатие в 8–12 раз.
- Бесплатно и open source. Никаких лицензий, никаких ограничений на размер репозитория или количество клиентов.
Архитектура: где хранить бэкапы
Ладно, прежде чем нырять в дебри настройки Borg, поговорим о самом главном. Куда же, черт возьми, эти бэкапы вообще складировать? Знаете, самая частая, просто гигантская ошибка, которую я вижу снова и снова, — это хранить резервные копии прямо на том же сервере, который вы якобы защищаете. Какой в этом смысл? Мы в ITFresh всегда, БЕЗОГОВОРОЧНО, следуем правилу «3-2-1». Что это значит? Три копии данных, две из них на разных типах носителей, и обязательно, просто кровь из носу, одна копия — где-то далеко, географически удалённо.
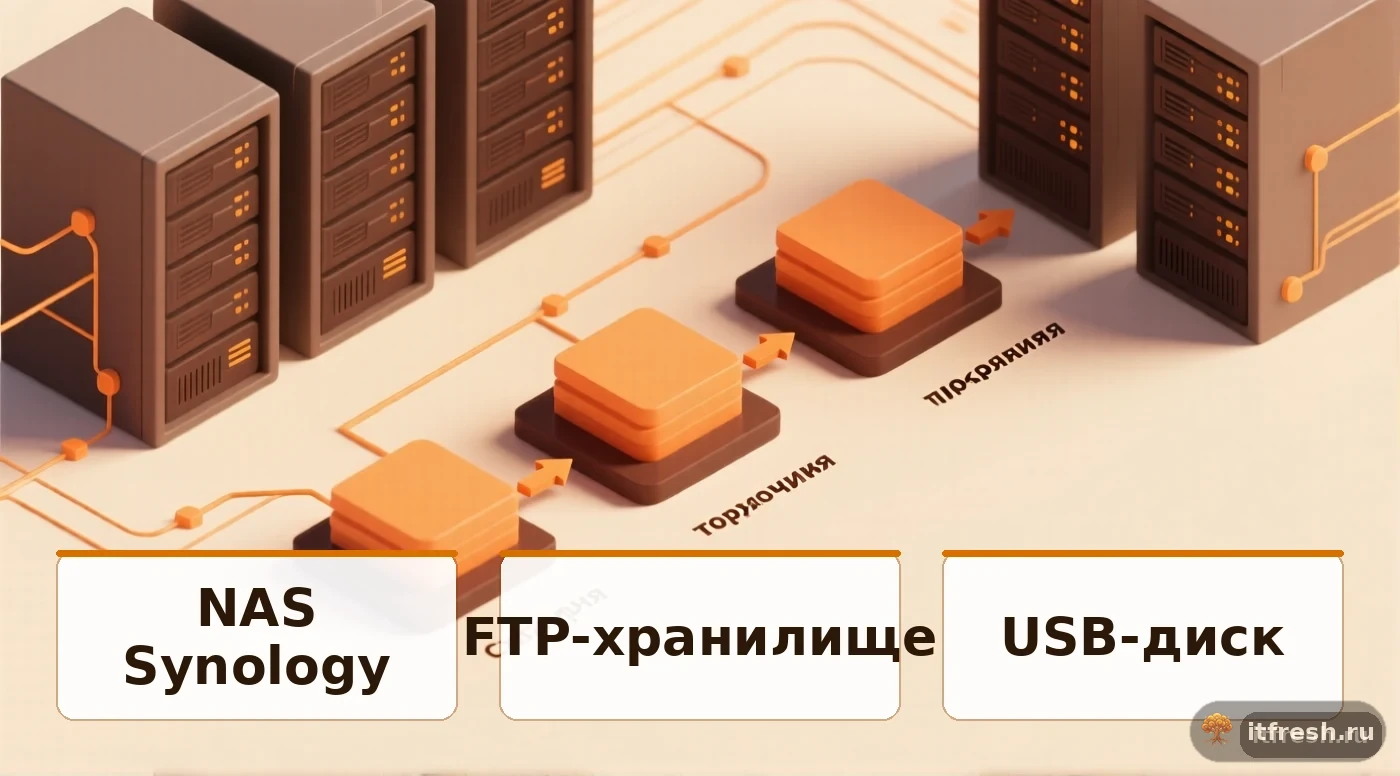
Вот как выглядит наша проверенная схема для обычного клиента: офис на 25 ПК и всего один Linux-сервер. Схема, которую мы применяем, выглядит так:
- Копия 1 (горячая): Borg-репозиторий на отдельном NAS Synology в офисе. Бэкап делается ночью, восстановление за минуты.
- Копия 2 (холодная): репликация репозитория на наш FTP-хранилище в дата-центре МТС (выделенная VM ITfreshFTP). Через rclone раз в сутки.
- Копия 3 (архивная): ежемесячная выгрузка на внешний USB-диск, который директор уносит домой. Защита от криптолокеров и пожара.
Сколько это стоит? Наша схема обходится клиенту примерно в 8 500 рублей в месяц за удалённое хранилище в дата-центре. Плюс, конечно, единоразовые расходы на NAS — это где-то от 45 тысяч рублей за модель с двумя дисками по 4 TB. Но вот что я вам скажу по опыту: за три года, один-единственный раз эта система реально выручила нас после жуткой атаки шифровальщика на один из офисов в Подольске. Клиент тогда восстановился всего за 6 часов. Представляете? Не пришлось переписывать все договоры месяцами!
Установка и инициализация репозитория
И вот вам хорошая новость: Borg не придётся искать где-то по интернету. Он есть в репозиториях почти всех современных Linux-дистрибутивов. Например, если у вас Debian или Ubuntu, установка проще пареной репы, делается вот так:
apt install borgbackup
borg --version  # должно быть 1.2 или выше
На CentOS/Rocky/AlmaLinux через EPEL:
dnf install epel-release
dnf install borgbackup
Создаём репозиторий. Я делаю его на NAS, который примонтирован через NFS или SMB на сервере как /mnt/backup:
borg init --encryption=repokey-blake2 /mnt/backup/srv01На этом этапе Borg попросит ввести пароль для шифрования. Этот пароль я генерирую через pwgen 32 1 и сохраняю в трёх местах: KeePass-базу клиента, мой собственный KeePass АйТи Фреш и бумажку в сейфе у директора. Если потеряете пароль — данные потеряны навсегда. AES-256 не подбирается.
Тип шифрования repokey-blake2 я выбираю осознанно: ключ хранится внутри репозитория и зашифрован паролем. Это удобно, потому что не нужно отдельно бэкапить ключевой файл — он уже там. Альтернатива keyfile-blake2 требует отдельного бэкапа ключевого файла, что добавляет геморрой.
Скрипт ежедневного бэкапа
Ну что, готовы? Теперь самое интересное — мой основной скрипт. Тот самый, что запускается по cron каждую ночь, ровно в 02:30. Я его уже шесть лет, без преувеличения, оттачиваю и постоянно дорабатываю. И вот перед вами его текущая версия — идеальное решение для типового сервера 1С, работающего с PostgreSQL:
#!/bin/bash
set -euo pipefail

export BORG_PASSPHRASE="ваш_пароль_сюда"
export BORG_REPO="/mnt/backup/srv01"
export BORG_RSH="ssh -i /root/.ssh/borg_key"

LOG_FILE="/var/log/borg/$(date +%Y-%m-%d).log"
HOSTNAME=$(hostname -s)
TIMESTAMP=$(date +%Y-%m-%d-%H%M)

# 1. Дамп PostgreSQL
echo "[$(date)] Dumping PostgreSQL..." | tee -a $LOG_FILE
sudo -u postgres pg_dumpall | gzip > /tmp/pgdump_${TIMESTAMP}.sql.gz

# 2. Borg-бэкап
echo "[$(date)] Creating Borg archive..." | tee -a $LOG_FILE
borg create \
    --verbose --stats --show-rc \
    --compression zstd,9 \
    --exclude '/proc' --exclude '/sys' --exclude '/dev' \
    --exclude '/var/log' --exclude '/tmp' --exclude '/run' \
    --exclude '/var/lib/postgresql' \
    --exclude '/var/cache' \
    ::"${HOSTNAME}-${TIMESTAMP}" \
    /etc /home /opt /root /srv /usr/local /var \
    /tmp/pgdump_${TIMESTAMP}.sql.gz 2>&1 | tee -a $LOG_FILE

# 3. Удаление дампа
rm -f /tmp/pgdump_${TIMESTAMP}.sql.gz

# 4. Применение политики хранения
echo "[$(date)] Pruning old archives..." | tee -a $LOG_FILE
borg prune --verbose --list \
    --keep-daily=14 --keep-weekly=8 --keep-monthly=12 \
    2>&1 | tee -a $LOG_FILE

# 5. Compact
borg compact 2>&1 | tee -a $LOG_FILE

# 6. Уведомление
if [ "${PIPESTATUS[0]}" -eq 0 ]; then
    curl -s "https://api.telegram.org/botTOKEN/sendMessage" \
        -d "chat_id=CHAT_ID" \
        -d "text=Backup ${HOSTNAME} OK"
else
    curl -s "https://api.telegram.org/botTOKEN/sendMessage" \
        -d "chat_id=CHAT_ID" \
        -d "text=BACKUP ${HOSTNAME} FAILED!"
fi
Есть несколько ключевых моментов в этом скрипте, которые, поверьте, я выстрадал на практике:
- Исключение
/var/lib/postgresql. Сами файлы базы Borg бэкапить не нужно — у нас есть pg_dumpall, который делает консистентный дамп. - Сжатие zstd,9 — оптимальный баланс между скоростью и компрессией. lzma даёт лучше сжатие, но в 5 раз медленнее.
- Политика хранения 14/8/12. Хранится 14 ежедневных, 8 еженедельных и 12 ежемесячных копий. Итого глубина бэкапа — около года.
- Уведомления в Telegram. Каждый успех и каждая ошибка летят в общий чат IT-команды. Без этого через месяц забываешь, что бэкап вообще делается.
Восстановление: три рабочих сценария
Что самое крутое в Borg? Его невероятная простота восстановления! Сейчас покажу вам три самых распространённых сценария, с которыми мы сталкиваемся в своей работе.
Сценарий 1: пользователь случайно удалил файл. Бухгалтер потёр папку с отчётами в shared. Звонит, паникует. Подключаюсь через SSH к серверу и за минуту восстанавливаю:
borg mount /mnt/backup/srv01::srv01-2026-04-16-0230 /mnt/restore
cp -r /mnt/restore/srv/shared/buh/2026-04 /srv/shared/buh/
borg umount /mnt/restore
Сценарий 2: упала база 1С. Накануне был успешный бэкап. Восстанавливаем PostgreSQL дамп:
borg extract --list /mnt/backup/srv01::srv01-2026-04-16-0230 \
    tmp/pgdump_2026-04-16-0230.sql.gz
gunzip /tmp/pgdump_*.sql.gz
sudo -u postgres psql < /tmp/pgdump_*.sql
Сценарий 3: полный bare-metal restore. Сервер сгорел, есть свежее железо. Ставим минимальный Linux, монтируем NAS, ставим Borg, восстанавливаем:
borg extract /mnt/backup/srv01::srv01-2026-04-16-0230
# Дальше восстановить PostgreSQL из дампа, проверить /etc, перезагрузиться
Вот наши цифры: реальное время bare-metal восстановления для типового офисного сервера с 1С — это 3–5 часов. Причём считаем мы это с момента, как железо готово к работе. А для клиентов на нашем «Премиум»-тарифе этот показатель, между прочим, жёстко закреплён в договоре. Если мы задерживаемся, платим штраф: 5000 рублей за каждый час просрочки. Мы этим очень гордимся!
Тестирование бэкапов: то, чего почти никто не делает
Здесь начинается самое скользкое и неприятное. От коллег часто слышу: «Да, конечно, у нас бэкапы делаются, всё пучком». Но стоит задать один вопрос: «А когда вы последний раз реально из них что-то восстанавливали?» — и, как правило, повисает тишина. Наблюдения печальны: у 80% компаний, что приходят к нам на аудит, бэкапы вроде есть, но никто и никогда не проверял, получится ли из них хоть что-то поднять.
Поэтому мы давно ввели железное правило: квартальное тестирование бэкапов. Раз в три месяца поднимаем отдельную тестовую виртуальную машину, развёртываем туда самый свежий бэкап и проверяем его работоспособность. Для стандартного клиента это занимает 4–6 часов работы специалиста — и эти несколько часов отделяют «у нас вроде бы всё окей» от настоящей готовности к катастрофе.
А вот и скрипт, который мы используем для автоматического тестирования — он запускает команду `borg check`:
#!/bin/bash
borg check --verbose --repository-only /mnt/backup/srv01
borg check --verbose --archives-only --last 3 /mnt/backup/srv01
У нас эта проверка запускается строго раз в неделю: на 200-гигабайтном репозитории всё занимает около 40 минут. Если же 'check' начинает ругаться — это стопроцентный сигнал: данные в репозитории повреждены, и с этим надо разбираться без промедления.
Удалённое хранение через SSH
Как мы организуем по-настоящему надёжную географически распределённую копию? Для этого я задействую отдельный, второй сервер. Он стоит в другом дата-центре, и Borg напрямую записывает на него данные, используя проверенное SSH-соединение. Просто и безопасно.
borg init --encryption=repokey-blake2 \
    backup-user@backup.example.com:/storage/srv01

borg create \
    backup-user@backup.example.com:/storage/srv01::srv01-{now} \
    /etc /home /srv
На принимающей стороне нужен SSH-доступ с ограниченным окружением. В /home/backup-user/.ssh/authorized_keys я прописываю:
command="borg serve --restrict-to-path /storage/srv01 --append-only" ssh-rsa AAAA...Флаг --append-only крайне важен: он означает, что даже если злоумышленник получит SSH-ключ, он не сможет удалить старые бэкапы, только добавить новые. Это защита от криптолокеров, которые научились искать и шифровать также ваши бэкапы.
borgmatic: красивый wrapper для тех, кто не любит писать скрипты
Если вам не нравится поддерживать кучу bash-скриптов, есть инструмент borgmatic — Python-обёртка, где вся конфигурация описывается в YAML:
location:
    source_directories:
        - /etc
        - /srv
        - /var/lib/mysql
    repositories:
        - /mnt/backup/srv01
storage:
    encryption_passphrase: "пароль"
    compression: zstd,9
retention:
    keep_daily: 14
    keep_weekly: 8
    keep_monthly: 12
hooks:
    postgresql_databases:
        - name: all
    healthchecks: https://hc-ping.com/UUID
Главные плюсы: встроенные хуки для PostgreSQL, MySQL и MongoDB, а также интеграция с healthchecks.io, ntfy и Telegram. На практике мы часто выбираем borgmatic для клиентов, чей сервер обслуживает штатный администратор — ему проще читать понятный YAML, чем расшифровывать хитросплетённые bash-скрипты.
FAQ — частые вопросы по BorgBackup
- Чем BorgBackup лучше rsync или tar?
- Borg делает дедупликацию на уровне блоков данных: одинаковые куски сохраняются один раз. На бэкапах VM или баз данных это даёт экономию места в 10–30 раз по сравнению с tar и в 3–5 раз по сравнению с rsync с hardlink.
- Подходит ли Borg для Windows-серверов?
- Нативно — нет, Borg только для Linux/BSD/macOS. Для Windows-серверов мы используем Veeam B&R или Restic, у которого похожая идеология. Borg отлично подходит для Linux-серверов 1С на CentOS/Debian, веб-серверов и LXC.
- Сколько места нужно для репозитория?
- С учётом дедупликации — 2–4 объёма исходных данных при политике хранения 30 дней. Для офисного сервера с 200 GB полезных данных хватает диска на 1 TB на 6–12 месяцев бэкапов.
- Где хранить пароль репозитория?
- Обязательно в нескольких местах: KeePass с шифрованием, бумажный архив в сейфе у директора и резервная копия у IT-аутсорсера. Без пароля Borg-репозиторий неотличим от случайного шума.
- Можно ли восстановить отдельный файл из бэкапа?
- Да, через borg mount репозиторий монтируется как обычная папка через FUSE. Дальше работаете как с любым файловым деревом — копируете нужное и размонтируете.